田渊栋创业公司开源首款 RSI 模型
前 Meta FAIR 研究科学家总监田渊栋参与创立的 Recursive Superintelligence,终于发布了首款开源模型 Flint。
这家公司由 Richard Socher 担任 CEO,田渊栋也是联合创始人之一。此前融资超过 6.5 亿美元,估值达到 46.5 亿美元,主要研究方向就是 RSI(递归自我改进)。
📌 模型架构与性能
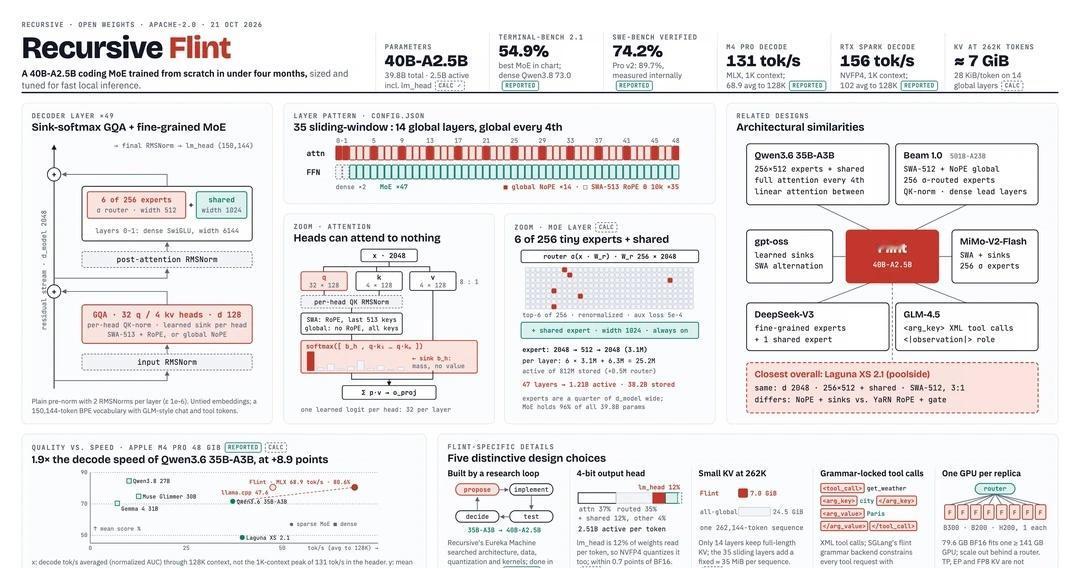
🔹 40B MoE 模型,每个 Token 仅激活 2.5B 参数
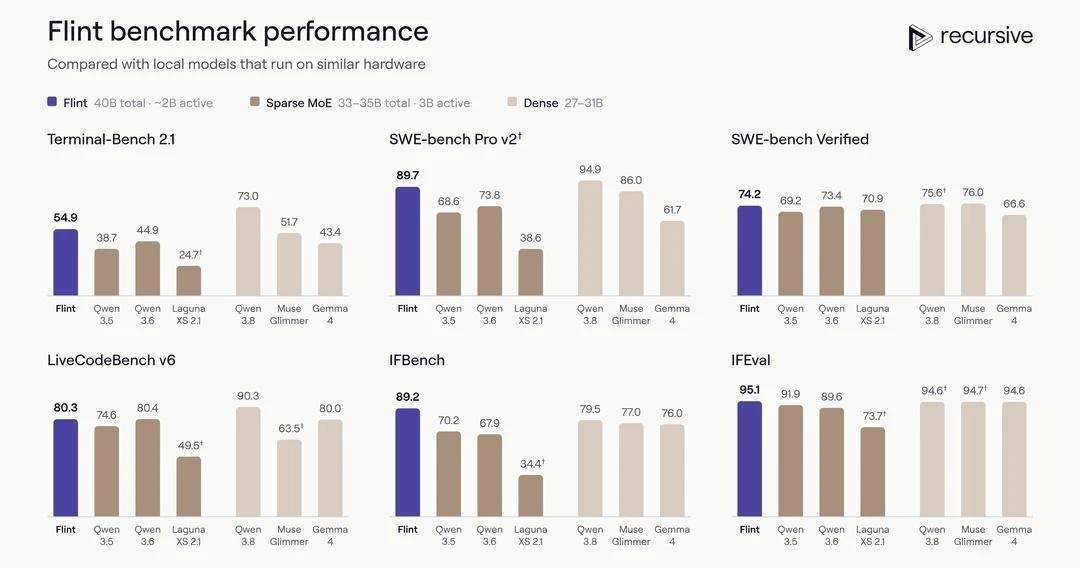
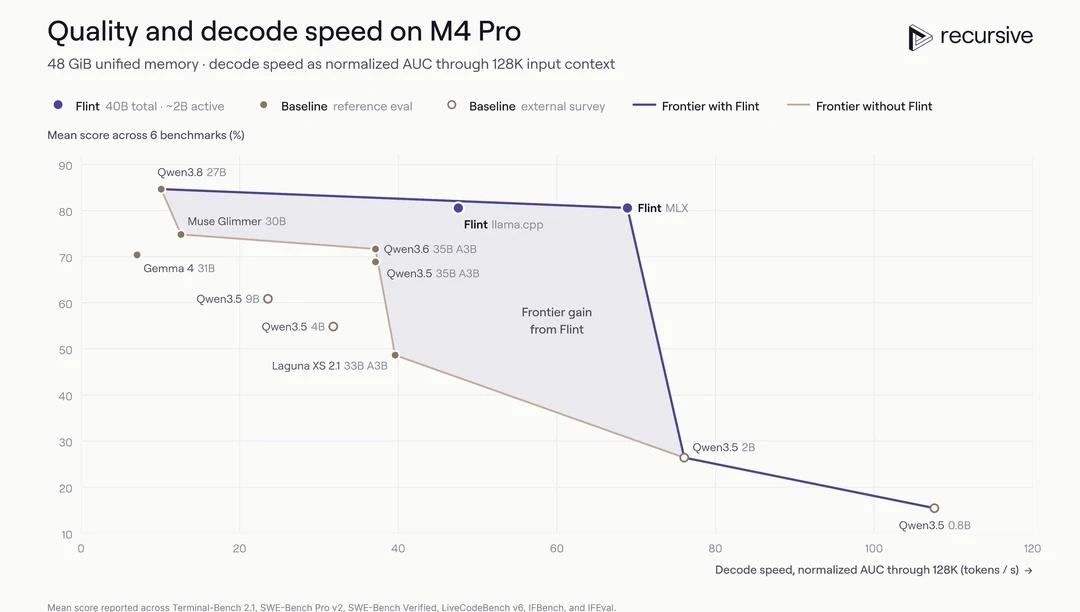
🔹 专门面向本地 Agent 编程,在 SWE-bench、Terminal-Bench 等评测中,官方称领先于 50B 以下的同类 MoE 模型
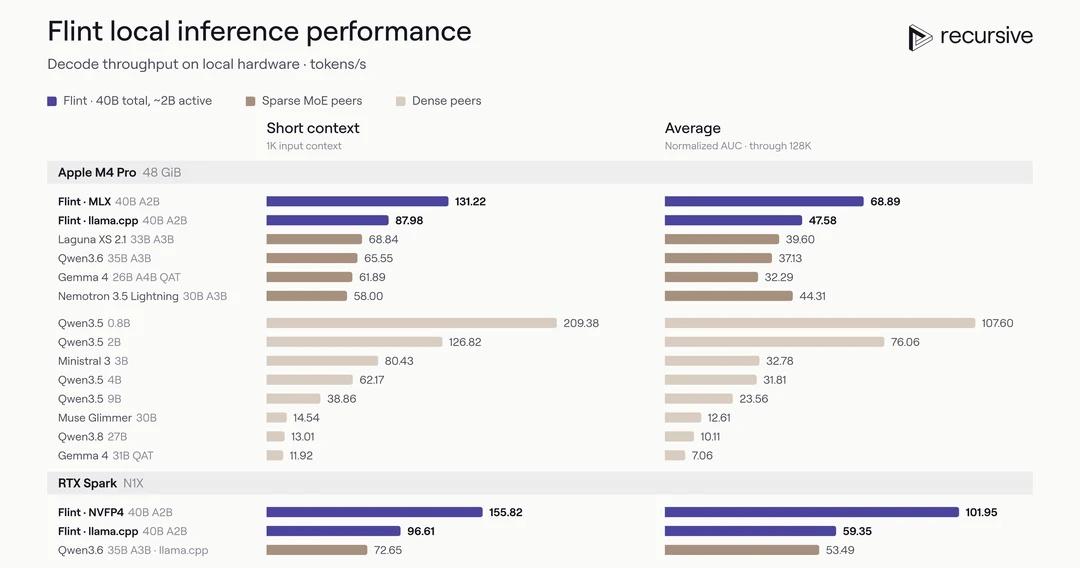
🔹 M4 Pro MacBook Pro:125+ tokens/s
🔹 NVIDIA RTX Spark:150+ tokens/s
🔹 相比编程能力接近的 25B~40B 稠密模型,推理速度快 5 倍以上
🔹 支持最高 512K 上下文,Apache 2.0 许可证,模型权重已上传 Hugging Face
📌这个模型怎么训练出来的
Recursive 表示,Flint 是一个小团队借助自动化 AI 研究系统 Eureka Machine,在不到 4 个月内从零开发出来的。
Eureka Machine 可以自动完成研究闭环:
提出想法 → 编写代码 → 运行实验 → 评估结果 → 继续优化。
而且它不只是调调超参数,而是参与了几乎整个模型开发流程。
比如:
🔹 模型架构:自动搜索不同 MoE 专家配置,最终选择 40B 总参数、2.5B 激活参数的架构。
🔹 量化方案:探索 4-bit 量化和蒸馏策略,让最终 NVFP4 模型与 16-bit 模型的评测差距不到 0.7 分。
🔹 推理优化:自动开发针对 Apple Silicon 和 NVIDIA 硬件的 Kernel,甚至在 M4/M5 上实现了融合整个 Decode 前向计算的 Metal Megakernel。
这些优化叠加在一起,才有了 Flint 的本地推理速度。
Flint 还不是一个能够自主递归改进的 RSI 模型,更准确地说,它是利用自动化 AI 研究系统开发出来的模型。
这次 Flint 算是一次初步验证。虽然还远远谈不上实现了完全自主的递归自我改进,但 AI 已经开始深入参与模型架构、训练算法和底层推理优化了。
大模型