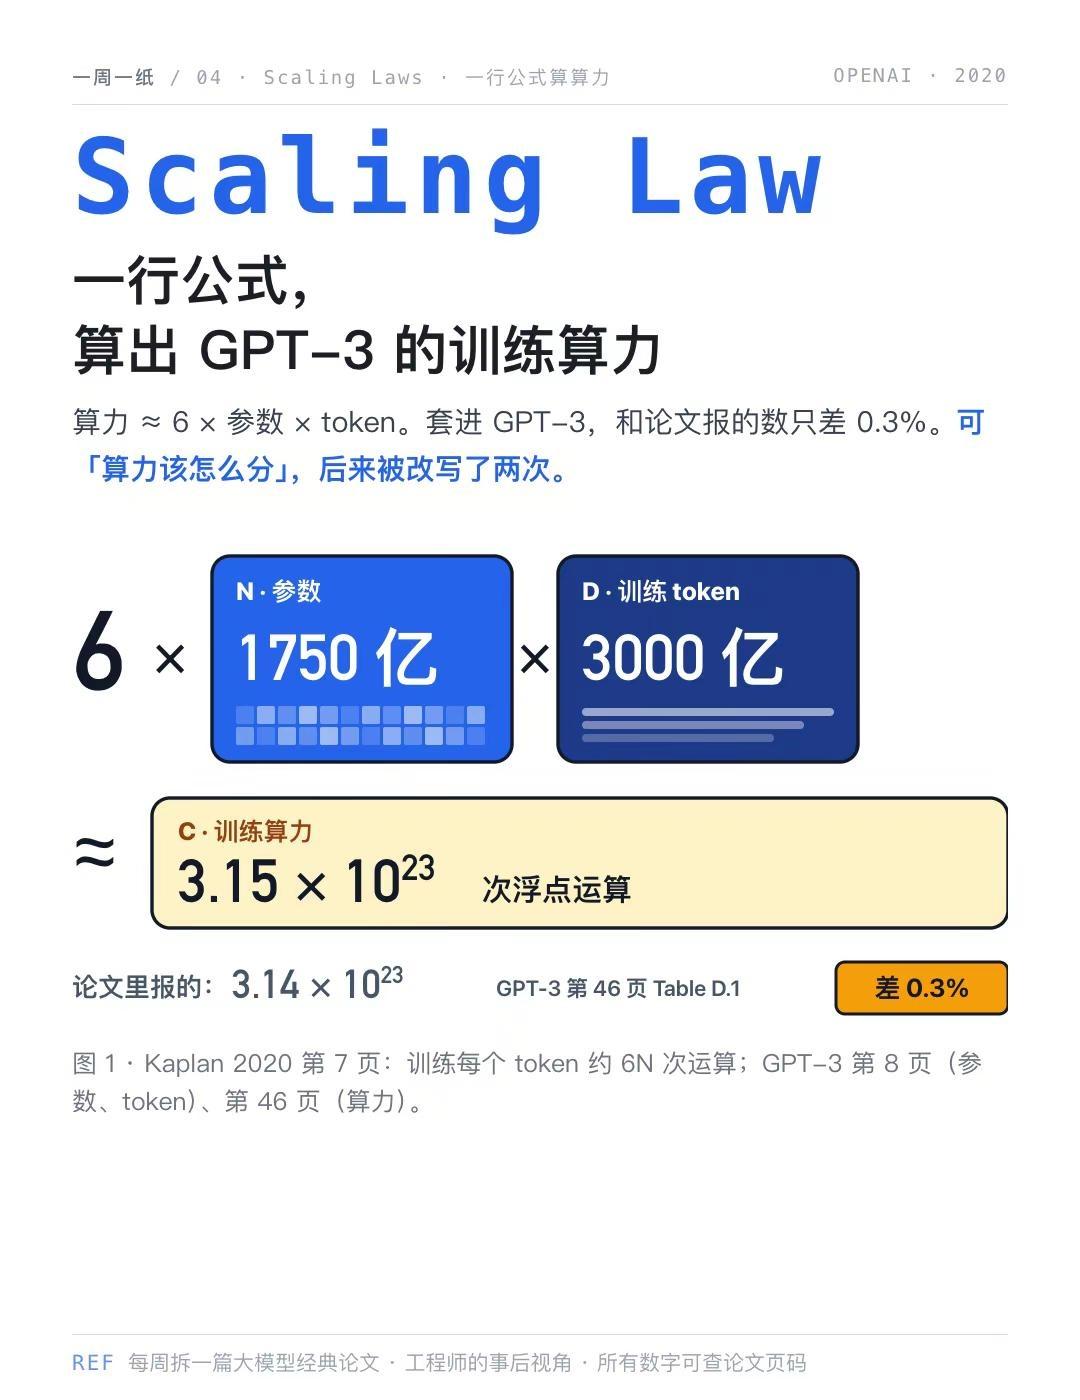
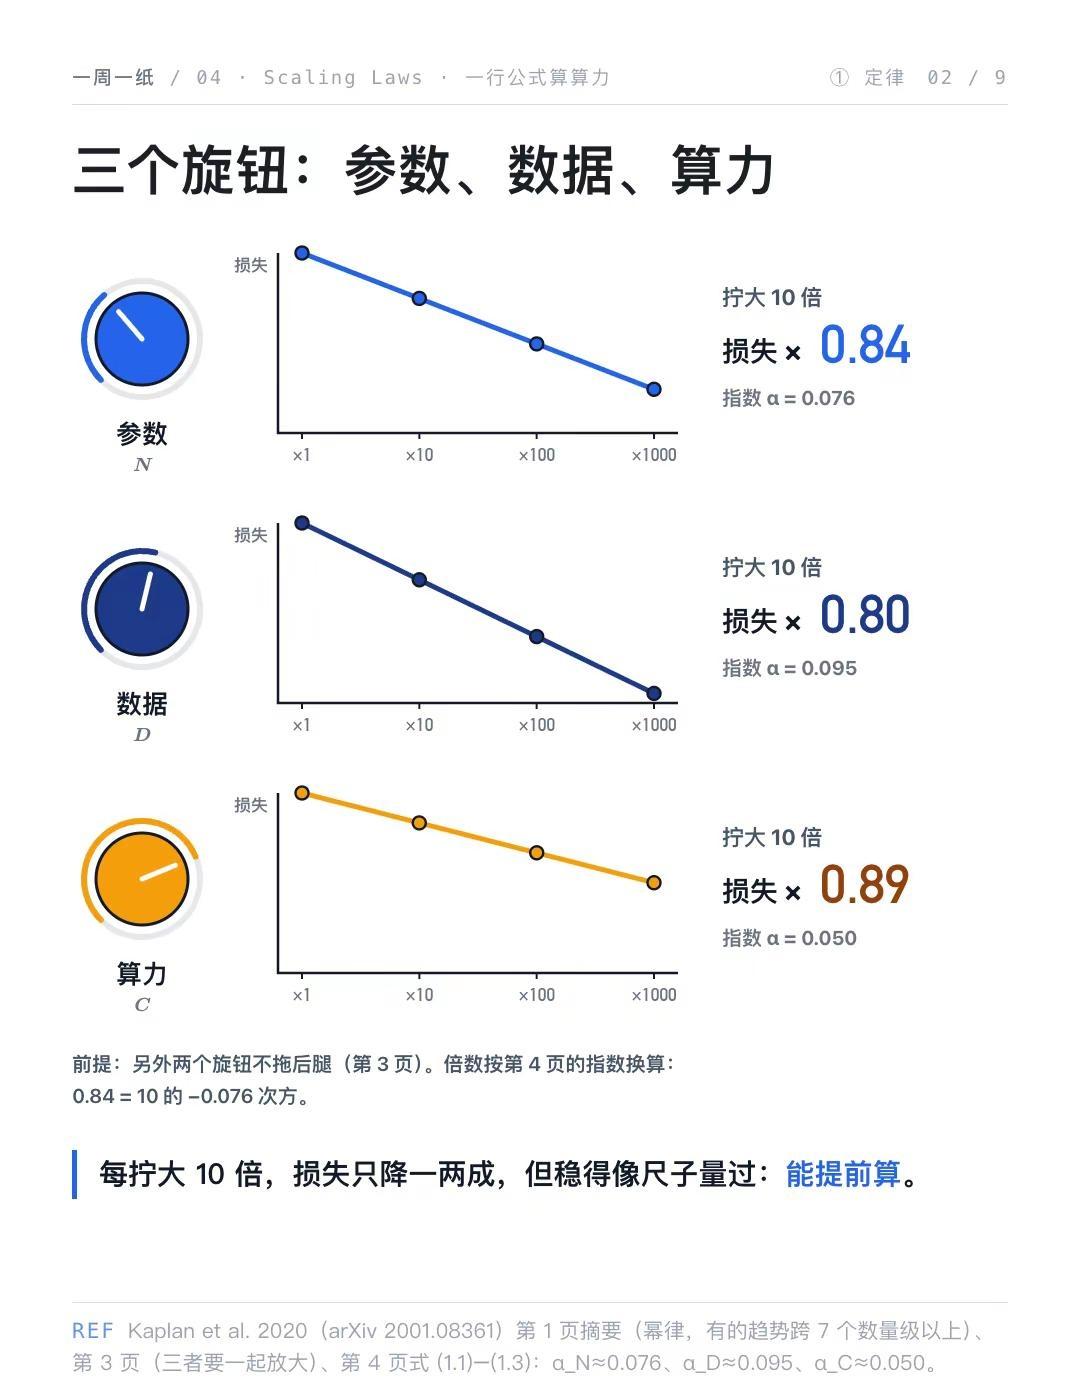
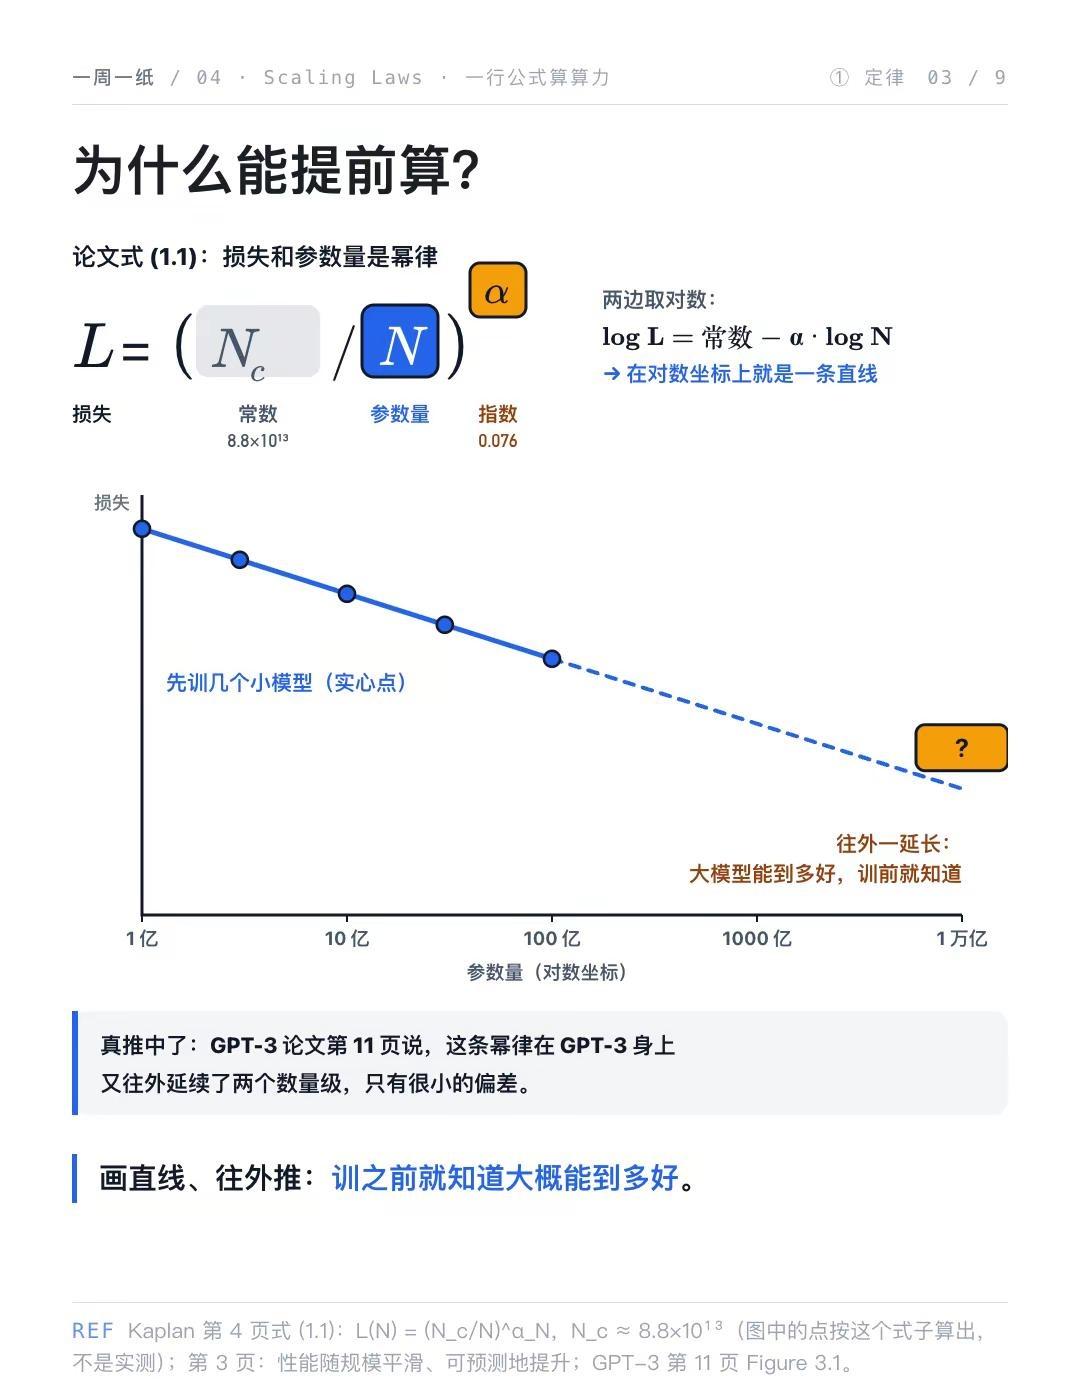
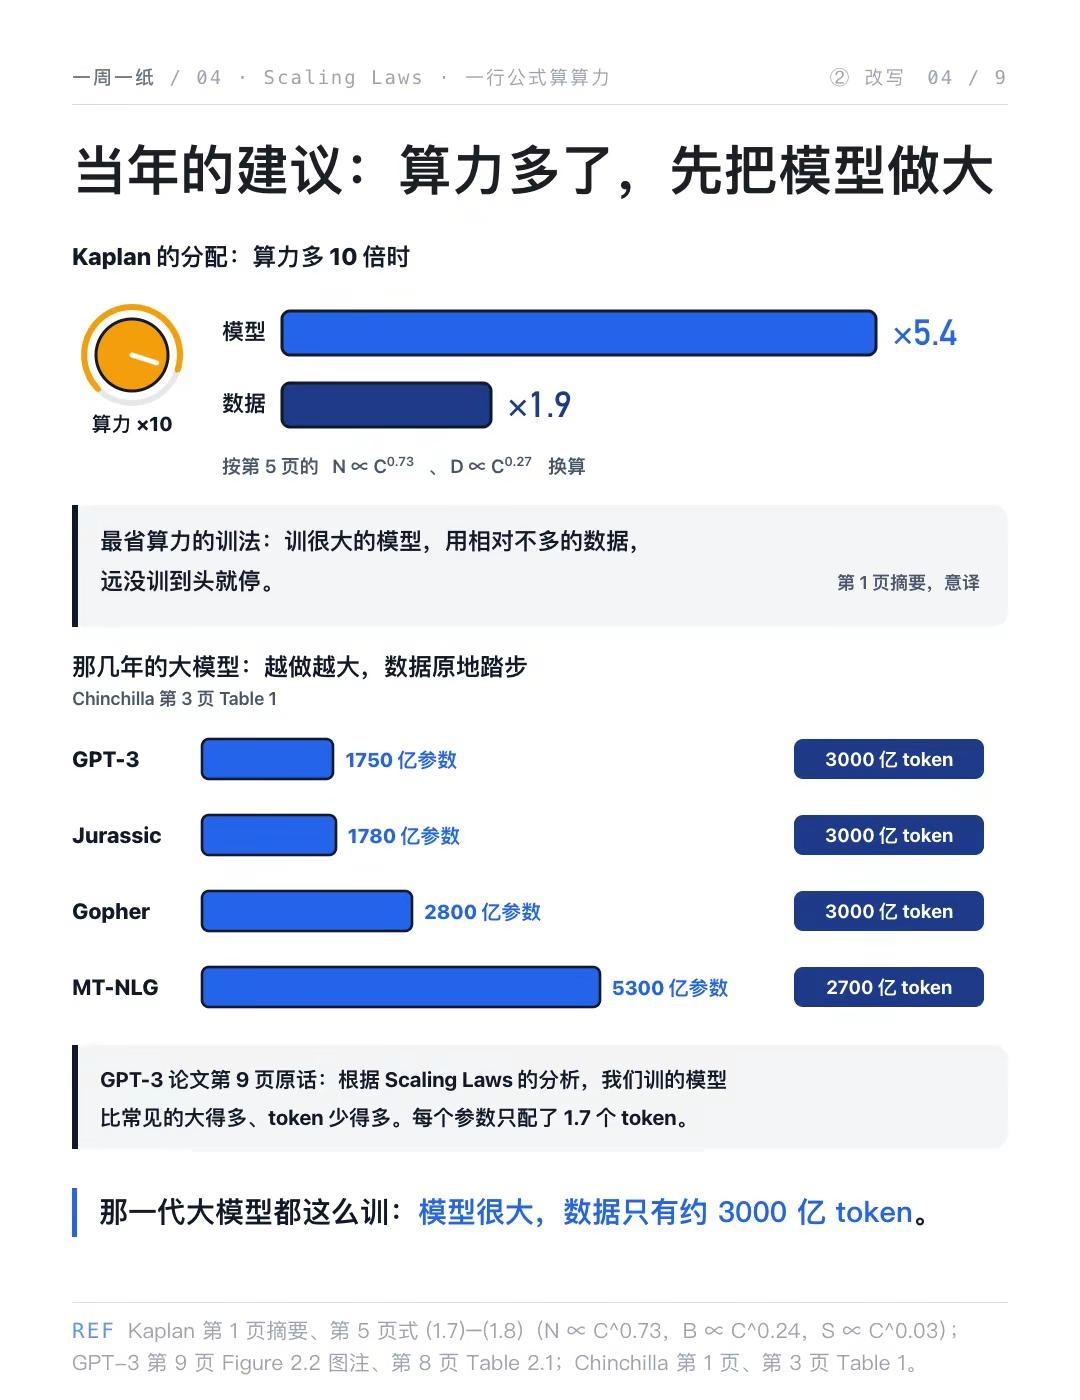
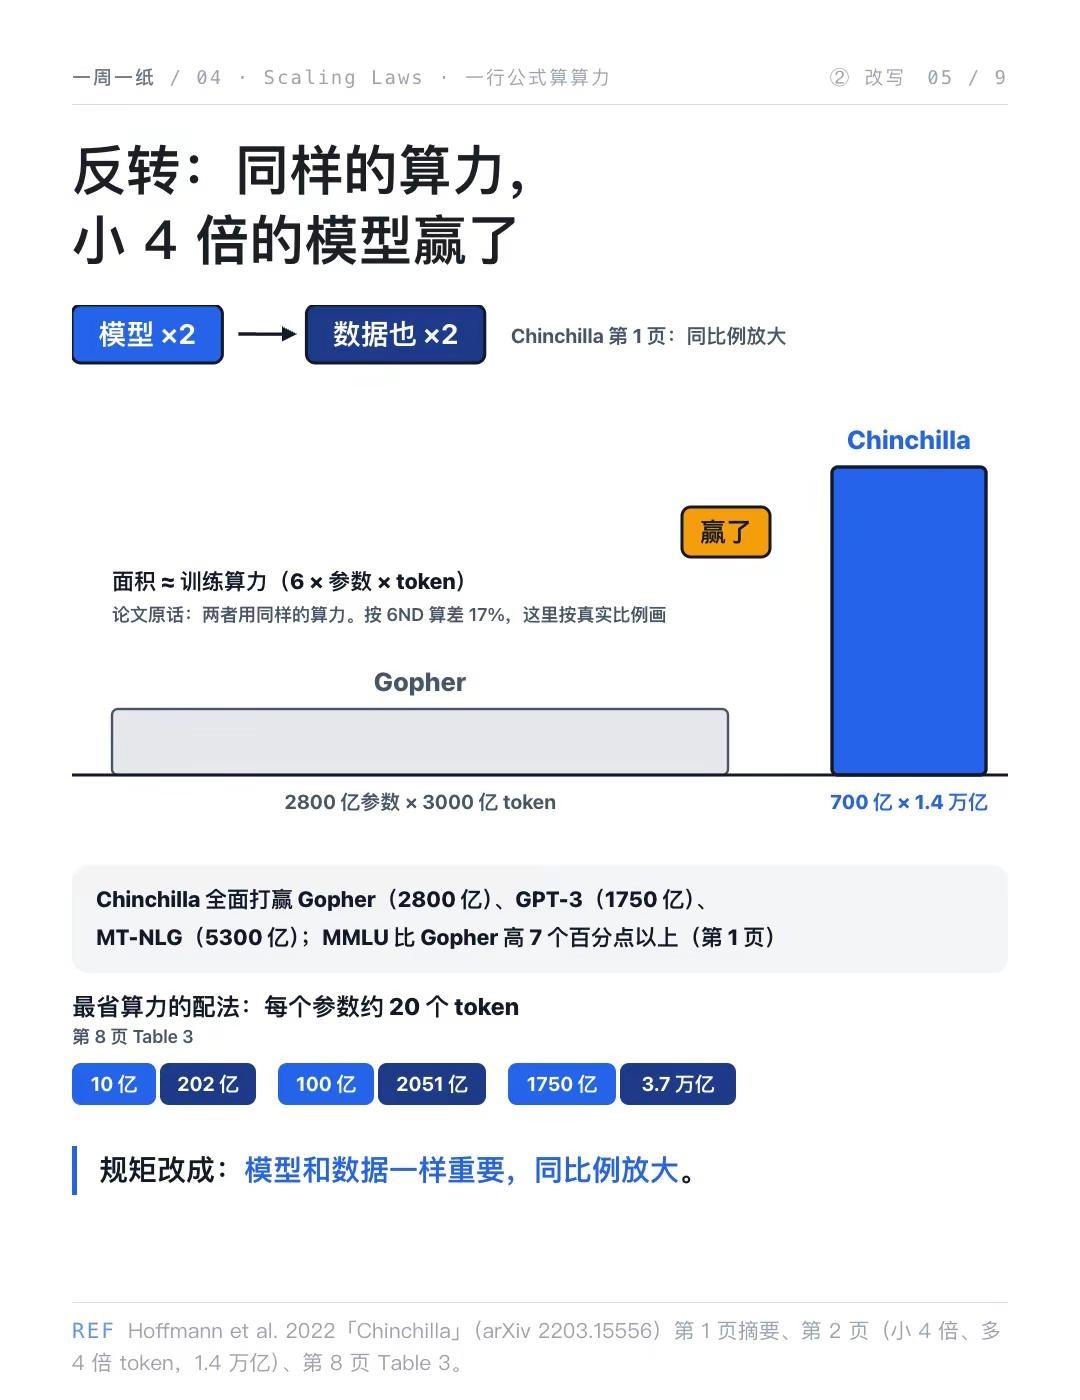
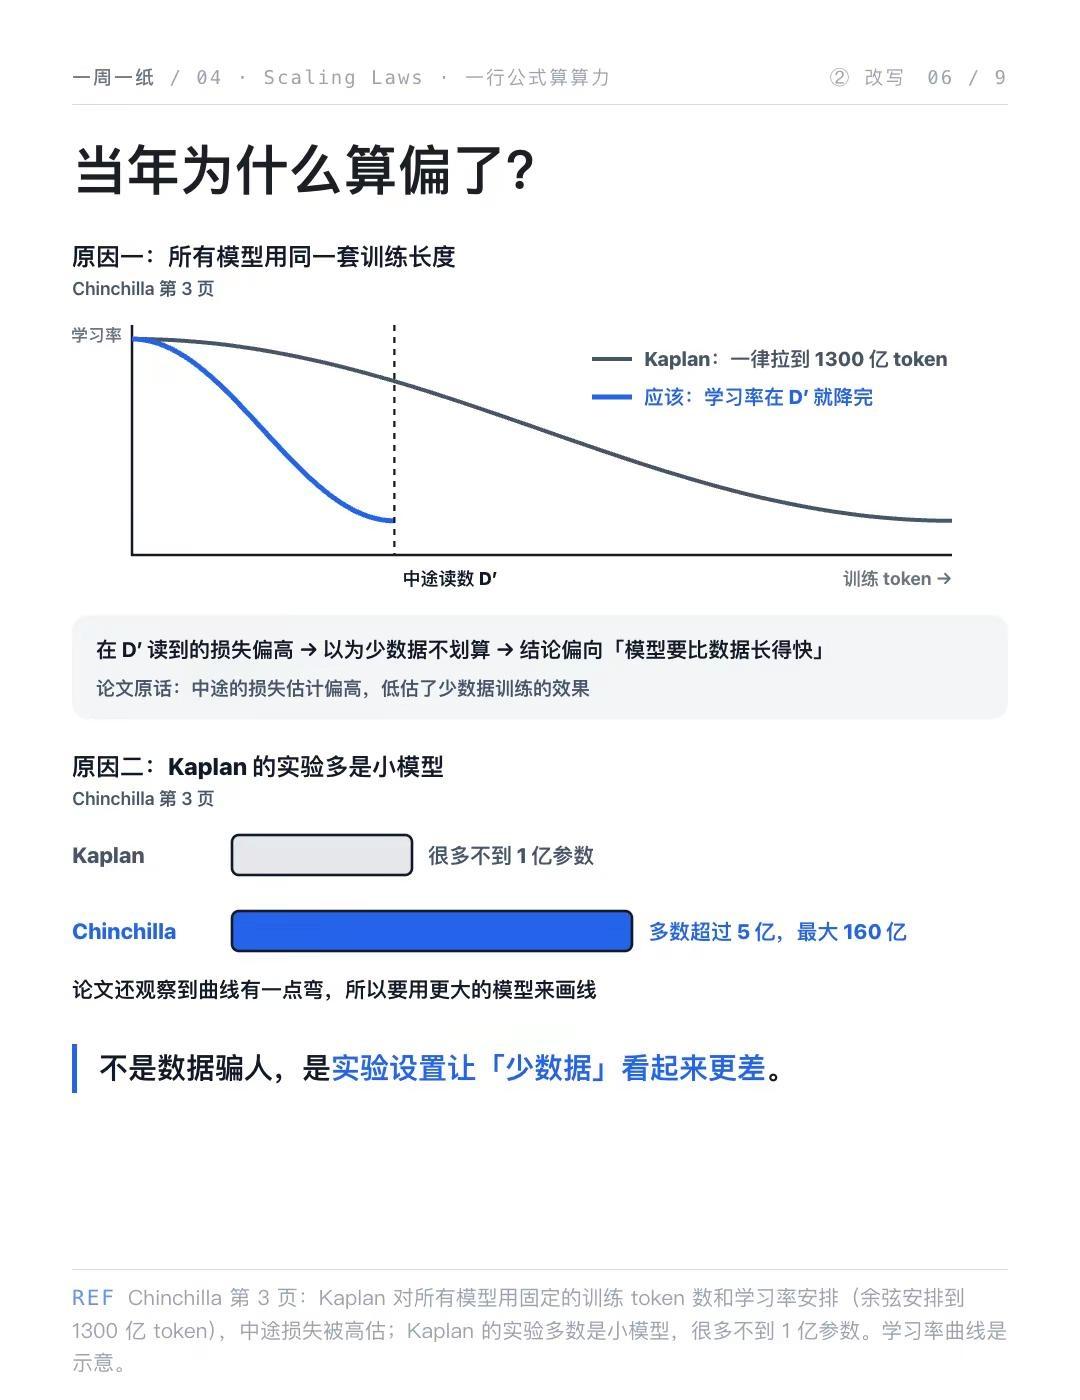
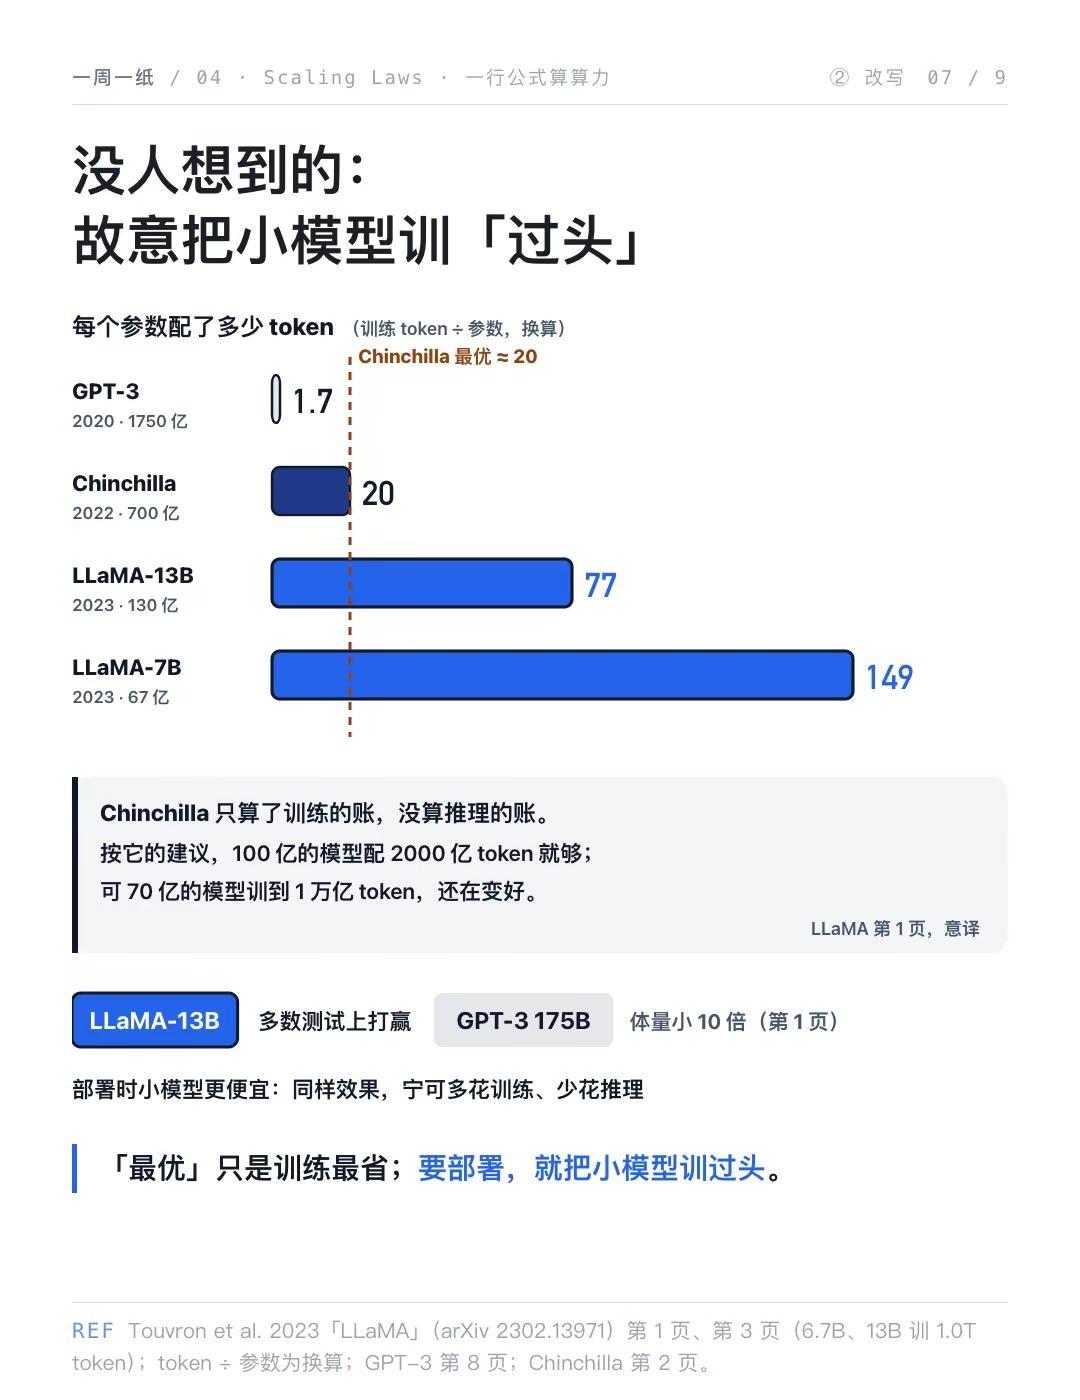
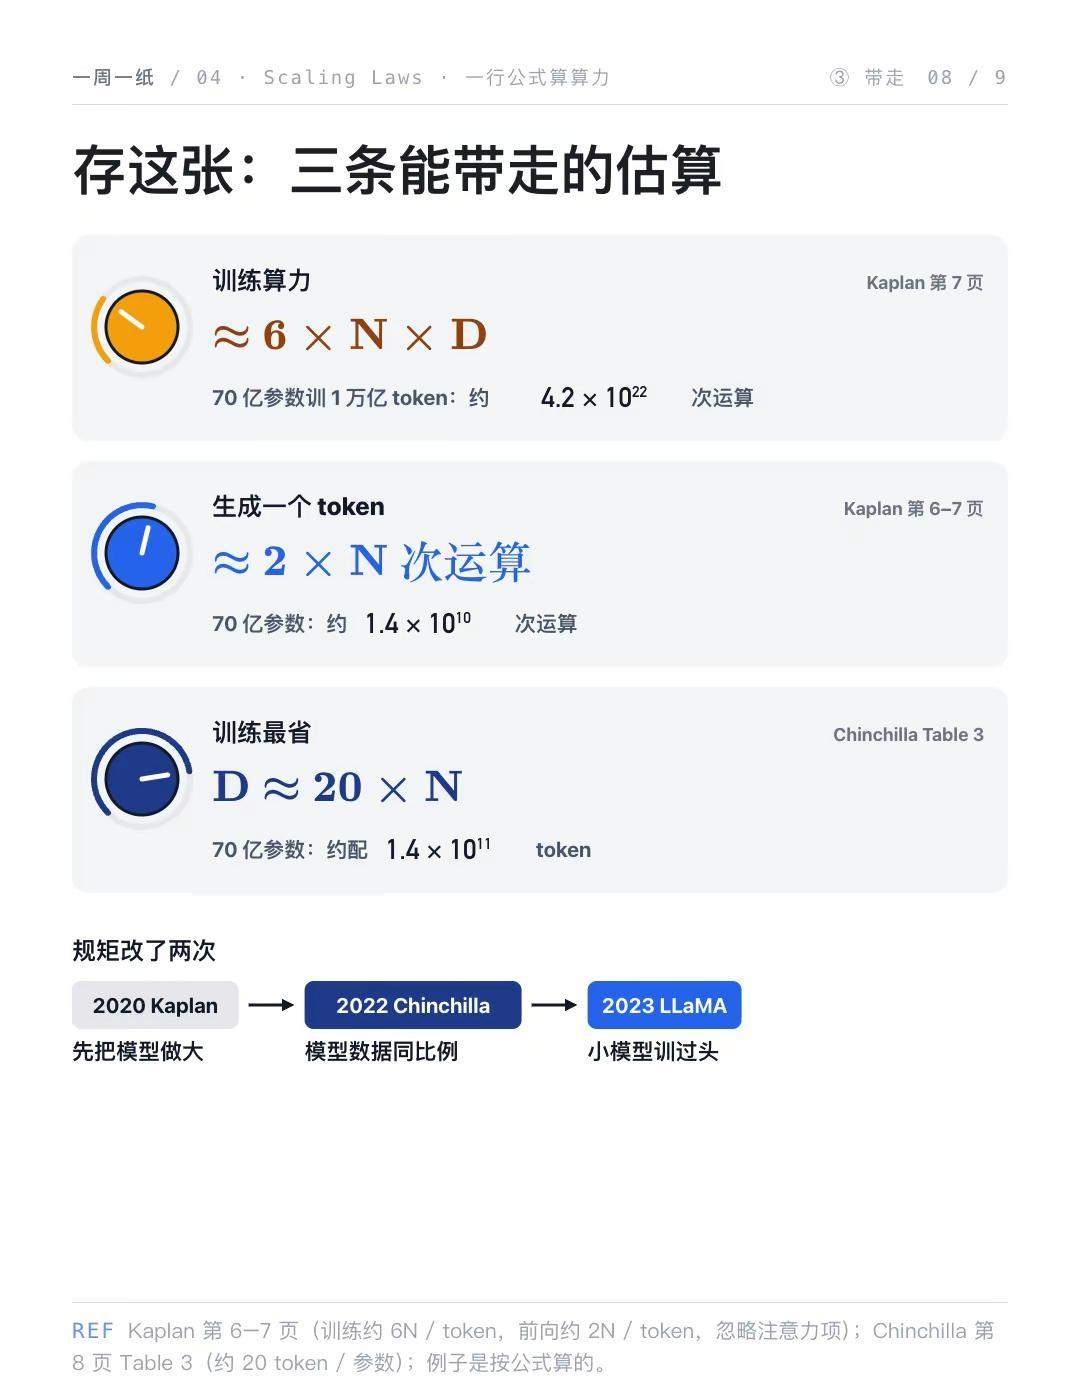
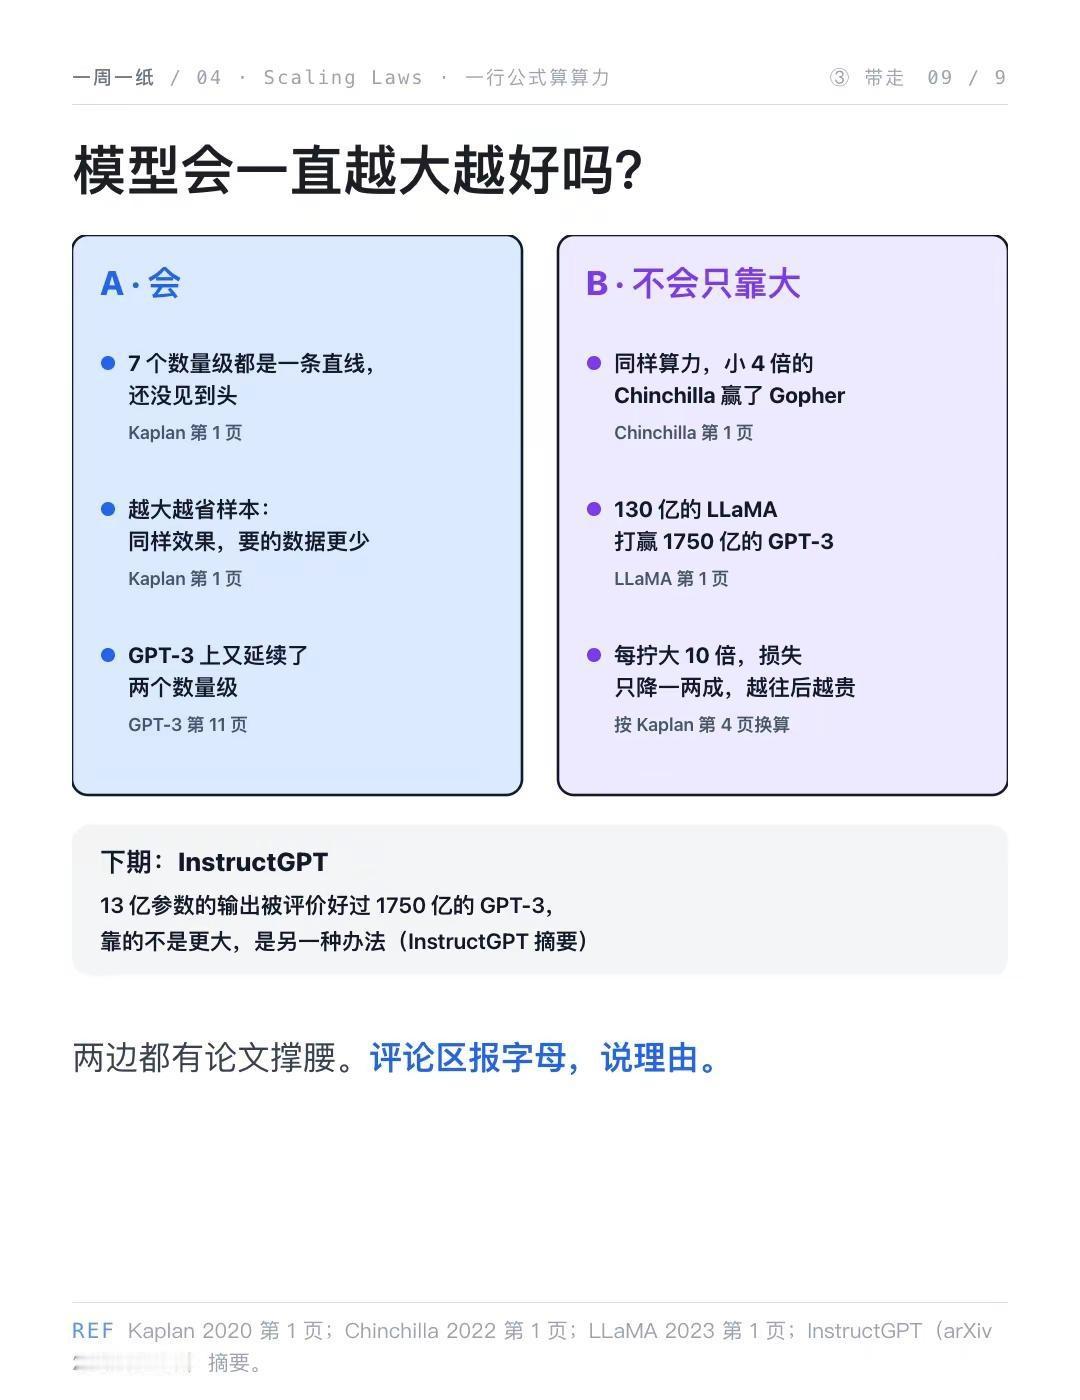
Scaling Law:一行公式算算力。你觉得模型会一直越大越好吗?A 会,B 不会只靠大,评论区报字母。 训练算力 ≈ 6 × 参数 × token。套进 GPT-3:6 × 1750 亿 × 3000 亿 ≈ 3.15 × 10²³,论文报的是 3.14 × 10²³,只差 0.3%。这是 2020 年 OpenAI 的 Scaling Laws 论文给的账。 它还发现三个旋钮:参数、数据、算力每拧大 10 倍,损失稳定降一两成,在对数坐标上是一条直线,所以训之前就能算出大模型能到多好。当年的建议是:算力多了先把模型做大,数据不用多。GPT-3 就这么训,每个参数只配了 1.7 个 token。 2022 年 DeepMind 的 Chinchilla 反转:模型和数据要同比例放大。同样的算力,700 亿参数、多 4 倍数据的 Chinchilla,打赢了 2800 亿的 Gopher。2023 年 LLaMA 又往前一步,故意把小模型训「过头」,130 亿打赢 GPT-3。 存三条估算:训练算力 ≈ 6 × 参数 × token;生成一个 token ≈ 2 × 参数次运算;训练最省时每个参数约配 20 个 token。 大模型 ScalingLaw 算力 深度学习