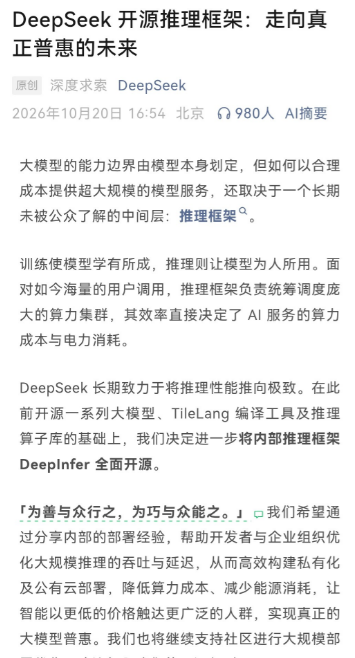
DeepSeek这次开放的,不只是一个模型,而是让模型跑起来的底层工具。
10月20日,DeepSeek公开了自研推理框架 DeepInfer。就在同一天,美国联邦公报刊登了国土安全部有关限制 DeepSeek 产品进入联邦民用机构采购和 IT 系统的命令。两件事前后发生,让这场 AI 竞争多了一层值得关注的意味。
模型发布,拼的是能力;推理框架,拼的则是怎样把能力更高效地用出来。
一个大模型即使表现不错,如果运行成本高、响应慢、难以支撑大规模请求,真正落地时仍会遇到门槛。推理框架优化的正是这些环节,涉及计算资源调度、并行处理和运行效率。DeepSeek选择把自家的这套工具开放出来,意味着其他开发者有机会研究、使用并参与改进,而不必完全依赖封闭的技术体系。
DeepSeek官方此前发布的 V4.1 Flash,主打的就是更快的推理速度、更高的吞吐能力和更低的服务成本。至于素材中提到的单集群日吞吐量、首 Token 延迟以及每卡收入等具体数字,目前还需要结合完整测试条件和统计口径判断,不能只看数字就认定它已经全面领先其他模型。
不过,开源的价值并不需要靠一句“击败美国 AI”来证明。
对开发者来说,能够接触到更多底层实现,就多了一种选择;对企业来说,如果能在自己的硬件环境中部署和优化模型,就有机会降低对单一服务商的依赖。技术能否被更多人使用、能否持续改进,往往和模型本身的能力一样重要。
美国限制联邦机构采购和使用 DeepSeek 产品,是一项有明确适用范围的政府措施,并不等于美国所有企业和开发者都不能使用相关技术。安全顾虑是否充分,也应该看具体证据,而不是简单把政策限制等同于技术胜负。
至于陈德里在 X 平台发表的强硬表态,它表达的是对开源路线的信心。但真正决定竞争结果的,还是后续的模型表现、部署成本、生态建设,以及开发者愿不愿意持续使用。
DeepSeek把推理框架放出来,确实给开源社区增加了新的工具。接下来更值得观察的是:有多少团队能用好它,又能否在真实业务中拿出可复现的成绩。
AI竞争不会因为一次开源就结束。能把技术做出来很重要,能让更多人用得上、用得好,同样重要。