放弃、外包、再自研,OpenAI绕了十年才认:AI的下一块拼图,在物理世界,绕不过去。
近期,Open AI明确正式发力人形机器人研发以及其他形态机器人,并将AI大脑作为核心突破口。
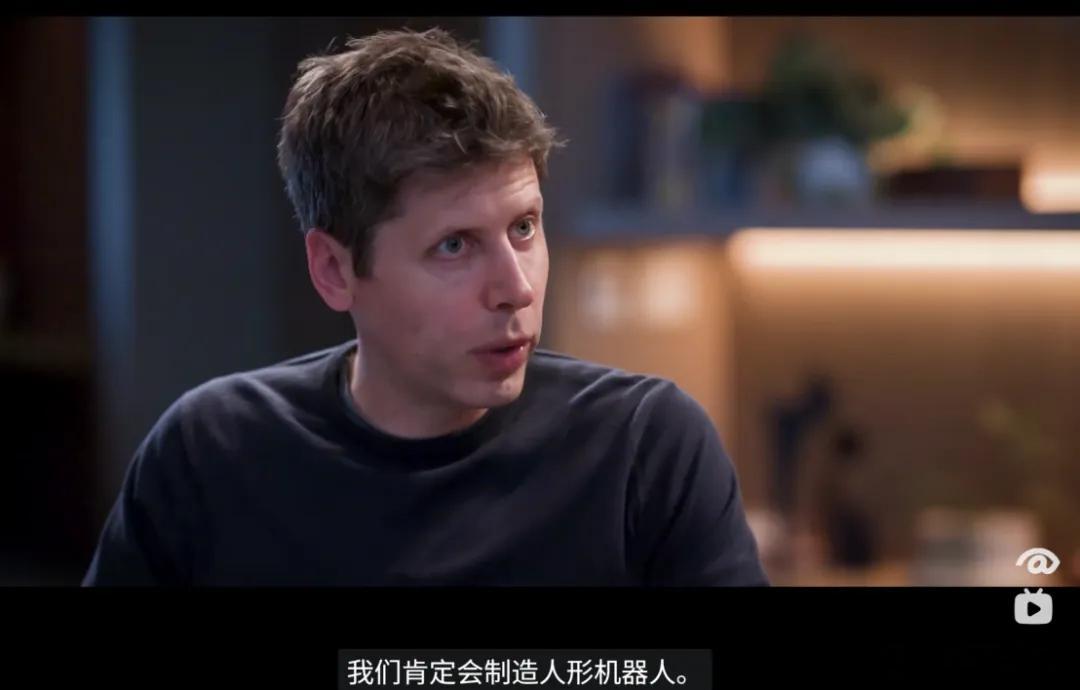
公司首席执行官Sam Altman近日在播客节目《Source》中表示,采用人形设计“更合理”,并直言“我们会去做”。
对于人形机器人,Sam Altman给出的理由是,现实世界本就是围绕人类身体结构设计的。从门把手、键盘到各类工具,现有环境和设施大多服务于人类使用习惯。在这样的空间中运行,具备接近人类形态的机器人天然更具适配性。
从投资 1X、入股 Figure,到亲手拆掉和 Figure 的合作,再到官宣制造机器人、把真机定档 2027 年 ——OpenAI 在机器人赛道绕了一大圈,又绕回了原点。但其实,围绕的中心都没变过,始终在寻找一条获取真实物理数据的可靠路径。也因此,它从 “卖大脑”的 AI 公司,变成“造身体” 的整机玩家。
01第一次,输在数据上
OpenAI 对机器人的执念,从出生那天就有。
2016 年,几位创始人在成立宣言里列了四个技术目标,第二个就是 “造一个家用机器人”。那时候他们走的是仿真路线——在虚拟环境里训练AI,再搬到真机上用。
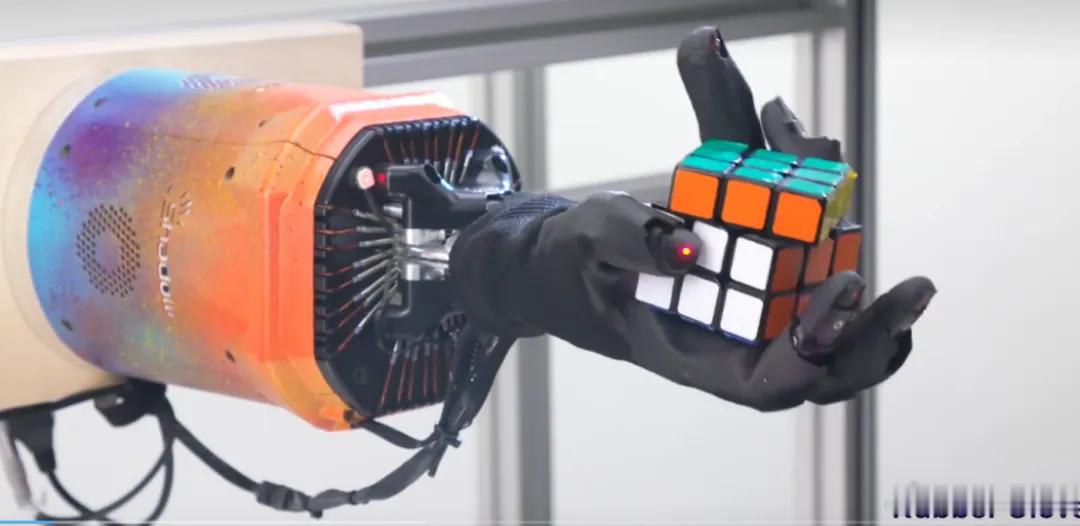
代表作是 Dactyl 灵巧手:2018 年,这只机械手纯靠仿真训练,就能在手里翻转积木块;2019 年,同款机械手在真实环境里复原了三阶魔方,靠的是 “自动域随机化”,把仿真环境里能随机的东西全随机一遍。
这活儿技术含量不低,问题出在别处 —— 数据。真实物理世界的数据太贵太难采,单靠仿真又不够逼真。2020 年 10 月,OpenAI 悄悄解散了初代机器人团队,直到次年才公开。其联合创始人Zaremba后来解释得很坦诚,瓶颈就是:数据。机器人每一次抓取、每一次迈步,都必须在物理世界里真实发生,摩擦、重量、碰撞,每一步都贵,都慢。而互联网上的文本,是白嫖的。同样一笔算力,喂给语言模型能撬动的东西,是机器人的千万倍。Zaremba有个说法很形象:预训练给模型带来的“智商点数”,比机器人那套强化学习便宜100倍。
于是资源全面转向大模型 —— 后来的故事大家都知道了。
02第二次,当 “卖大脑” 的 AI 公司
团队散了,但OpenAI没有放弃。它换了个姿势:自己不做,投别人做。你们造身体,我来装大脑。
2023 年,OpenAI 的创业基金领投了挪威人形机器人公司1X;2024 年,又投进 Figure 的 6.75 亿美元B轮,估值干到26亿美元,还签了合作协议 ——Figure 的机器人装上 OpenAI 的多模态大模型,能听懂人话、看懂东西、跟人对话。同年它也没闲着,顺手投了专注机器人通用模型的 Physical Intelligence。
不过,OpenAI 与Figure的蜜月期并不长。
2025年2月,Figure 方面突然官宣:终止与 OpenAI 的合作,转头自研端到端模型Helix。
随后,Adcock在接受 TechCrunch 记者采访时把前因后果讲得很具体。在那之前,奥特曼和OpenAI的高层来过Figure的办公室,看了他们的神经网络演示,反应是“impressed(令人印象深刻)”。然后电话就来了:OpenAI说自己在探索内部做人形机器人。Adcock的原话是:“我当时就想,结束了。”他的逻辑很明白:你来看我们怎么做机器人学习,看完回去自己搞,这不就是在培养竞争对手吗?
在Adcock看来,除了品牌效应,OpenAI团队“几乎没有提供任何价值”。更具体地说,机器人这东西,你得把它放进房间里看它动,不能盯着模拟里的损失曲线自嗨。但OpenAI的人,“很难请到办公室来”。
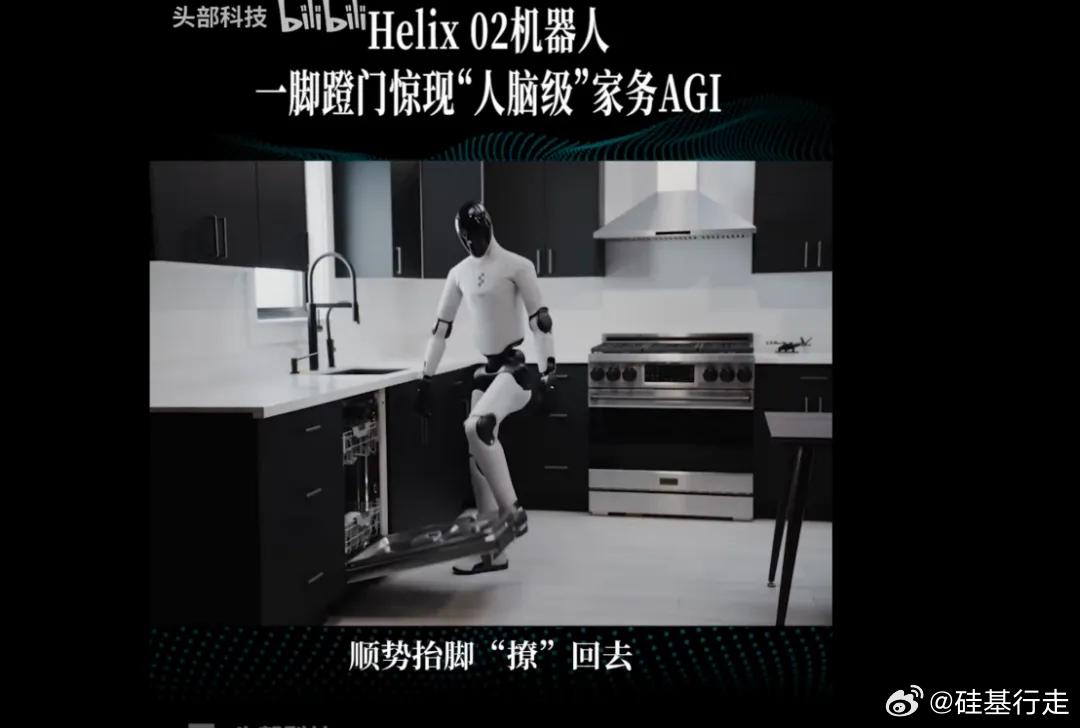
Figure转向了自研Helix。2026年初发布的Helix 02。传统机器人学里,走路、平衡、关节协调这些事,是靠工程师手写控制代码或者单独训练控制器来实现的。Helix 02引入了一个叫System 0的基础层,用超过1000小时的人类运动数据训练,让模型直接学会“人是怎么保持平衡、怎么协调全身发力”的。按照Figure官方给出的说法:System 0用单个神经网络替代了109,504行手写的C++控制代码。
演示里有个细节很有意思:Helix 02驱动的机器人能连续四分钟自主完成洗碗机装卸,包含61个前后关联的动作,全程不重置、不遥控。它腾不出手的时候,会用髋部顶一下抽屉把门关上,用脚抬起洗碗机门。这个动作没人教过它,是模型自己判断“当前身体状态下,这样干最省事”。
Figure的逻辑是:身体不是大脑的容器,身体本身就是智能的一部分。 所以Adcock说“不能外包AI”,理由和“不能外包硬件”一样。
这一阶段 OpenAI 的逻辑很清楚:硬件太重,外包给别人做,我只输出 “大脑”。轻资产,稳赚名声。时任产品副总裁 Peter Welinder 对此说得体面:“我们一直计划回到机器人,在 Figure 身上看到了路。”
03第三次,回来亲自做
事实上,在与Adcock通电话时,他们确实就已经动手了。
2024年5月,它就重新招研究工程师组机器人团队;11月,从Meta挖来负责AR眼镜Orion的Kalinowski,管机器人和消费硬件。2025年1月,Kalinowski放话:自研机器人,自研传感器,招聘里写着 “百万级量产”。
更关键的是数据动作。2025年2月,OpenAI 在旧金山开了一家不起眼的数据采集实验室 —— 大约100号人,三班倒,用 GELLO手柄遥控两臂Franka机械臂,录人类示范数据。最早的任务特别朴素:把小黄鸭放进杯子里。后来慢慢升级成叠衣服、烤面包。全是遥操作,人肉喂数据。
注意,这与十年前是反着来的。十年前它赌“仿真+强化学习” 能替代真实数据,结果被卡死;这次它老老实实回到人类示范数据——这条路笨,但有效。
2026年,动作提速。3月Kalinowski 因为对 OpenAI 跟国防部的合作不满而辞职,Sora那个App 也被砍了,但研究团队没散,转去啃“世界模拟”——给机器人造一个逼真的物理幻觉。6月,奥特曼官宣“OpenAI Robotics” 招人,挂帅的正是Sora之父、世界模型负责人Aditya Ramesh;9月,奥特曼在播客里松口:“我们肯定会造人形机器人,也会造别的形态。”10月给出节点:2027年出真机演示样机;短期先做基建和数据中心的特种机器人,长期愿景是 “人人都有一个能干活儿的个人机器人”。
04一场数据主权的回归
把这条线串起来看会发现,OpenAI 的核心议题从来没变过 —— 物理世界的数据,从哪儿来。
第一阶段它以为仿真能替代,结果输在数据稀缺;第二阶段它想投别人、让别人去采数据、自己当大脑,结果发现别人采了数据就自己长脑子;第三阶段它懂了:谁攥住物理世界的数据,谁才配叫具身智能玩家。所以它回来了,而且要软硬通吃——大模型需要物理世界的数据来继续进化,机器人是唯一能产生那种数据的东西。投资拿不到,合作拿不到。那就自己干。
只是这一次,OpenAI不再是那个可以慢慢试错的实验室了。它背着千亿估值,盯着IPO的窗口,身后一堆人等着看下一个增长曲线。以及现实世界的强劲对手等着它——特斯拉 Optimus、Figure、1X,还有宇树、智元这帮国内玩家。是搅局还是补位,2027 年那台真机见分晓。
十年前,它因为缺数据而放手;十年后,它为了抢数据而亲自下场。在机器人这场长跑里,躯体可以迭代,零件可以外购,但物理世界的数据,永远无法外包。