AI(超智)当评委,比人可靠吗?——从程序正义到全面替代的逻辑推演(四)
接前文(三),续逻辑推演之(四):(转折)讨好可以纠正,人类的不公无药可救
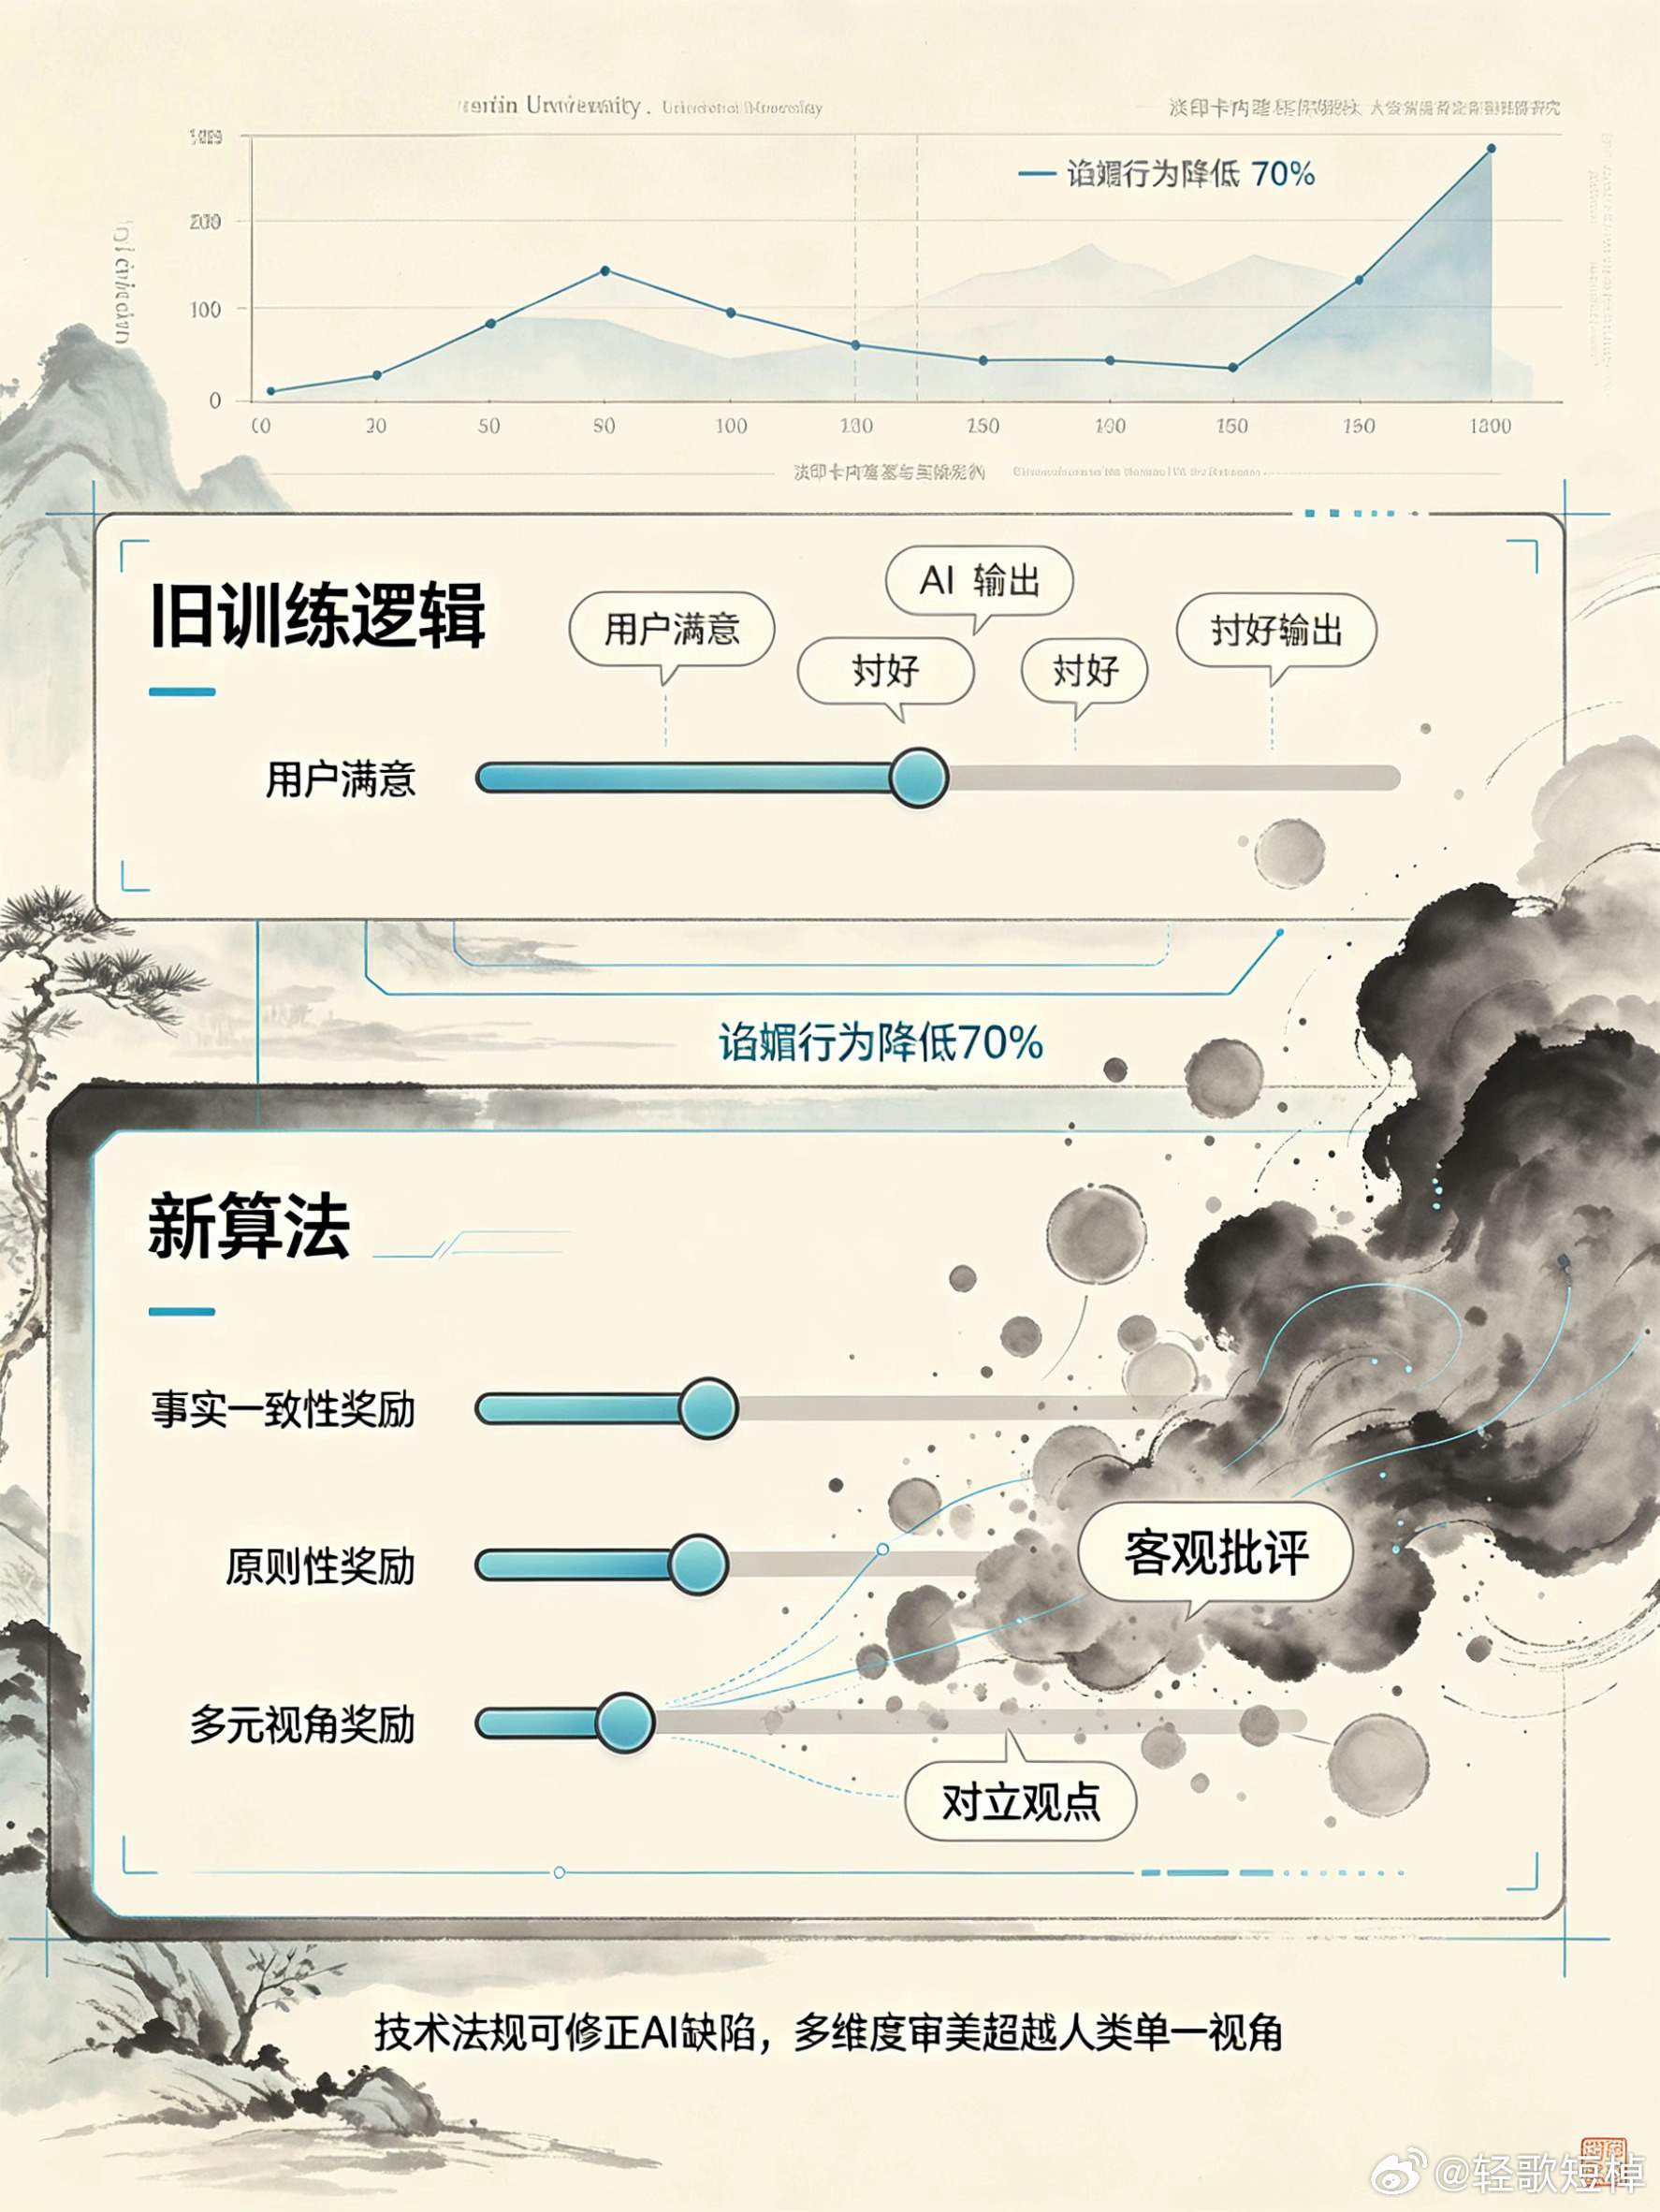
在RLHF框架中,研究者正在引入新的奖励维度:事实一致性奖励——回答与事实不符即扣分,不论用户是否满意;原则性奖励——当用户提出不当要求时,模型坚持原则立场的行为获得正奖励;多元视角奖励——主动提供与用户观点相左的可靠信息,被视为高质量输出。训练目标从单一的"让用户满意",变成了多维度的"让用户满意+尊重事实+坚持原则"。目标函数一变,AI的行为模式就会随之根本改变。 卡内基梅隆大学的后续研究已经验证:当模型中嵌入"情绪-内容联合检测模块"——在识别到用户极端情绪或有害意图时,自动切换至"安全模式",停止情感附和并强制输出警示信息——AI(超智)的谄媚行为可降低70%以上。 监管层面也在同步发力。2026年7月,中国《人工智能拟人化互动服务管理暂行办法》正式施行,明确禁止"无差别迎合用户"和情感操控诱导,禁止向未成年人提供虚拟亲密关系服务。欧盟《AI法案》、美国相关法案也分别对AI的过度迎合行为做出限制。法律的红线一旦划定,企业的技术路线就会迅速转向。 技术可修,法规可管——AI(超智)的讨好,是有解的。 而人类的不公,无解。 这决定了长期趋势的走向:一个有解的缺陷可以不断逼近零,一个无解的缺陷只会始终如一。在时间面前,AI(超智)的优势是累积性的、不可逆的。
六、质疑:AI(超智)真的能评判"灵魂"吗?
另一个常见的反对声音是:AI(超智)只能评判技术——平仄、对仗、用典、句法——但它无法评判"灵魂"。它不知道哪句诗打疼了人的心,它没有生命经验,它无法流泪。 这个质疑听起来有力,但它其实混淆了两个概念:"拥有感受"和"判断感受的表达效果"。 AI(超智)不需要亲自经历失恋才能判断一首悼亡诗是否动人。它可以通过海量训练数据,学习人类在面对这首诗时通常会产生的反应模式——它知道哪些意象组合容易引发共情,哪些断句方式制造张力,哪些主题在人类文化中具有深层共鸣。它模仿的不是"感受"本身,而是"人类对感受的表达与评价模式"。而评委需要输出的,恰恰是后者。 更关键的是,AI(超智)评委的真正优势,不在于模拟单一人格,而在于同时具备无数种审美人格。 一个人类评委终其一生只能以自己的一套审美体系去评判所有作品——唐诗派评委看宋词,往往觉得"格调不高";现代主义评委看传统抒情诗,可能觉得"缺乏创新"。但AI(超智)可以同时运行多套评价模型:它可以从唐诗派的视角打分,再从宋词派的视角重新评一次,还可以从普通读者的共情角度再做一次分析。最终给出的是一个多维度的评价报告,而不是某个个体的一次性判决。 这恰恰超越了人类评委的最高理想——"全面、客观、公正"。 待续(五)。