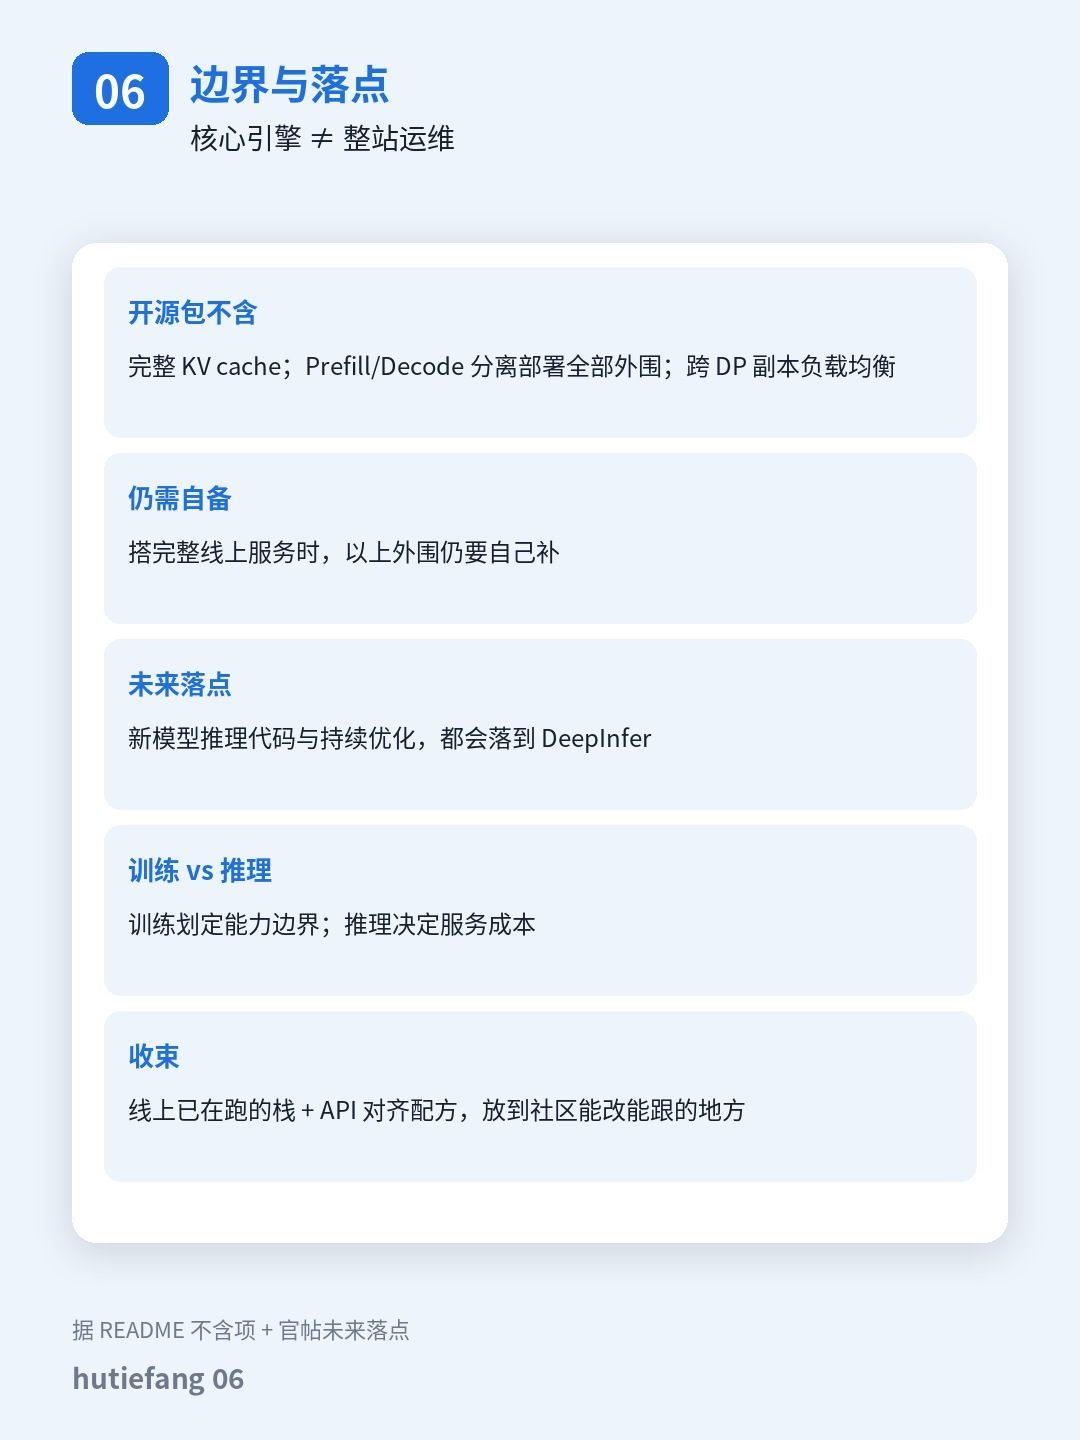
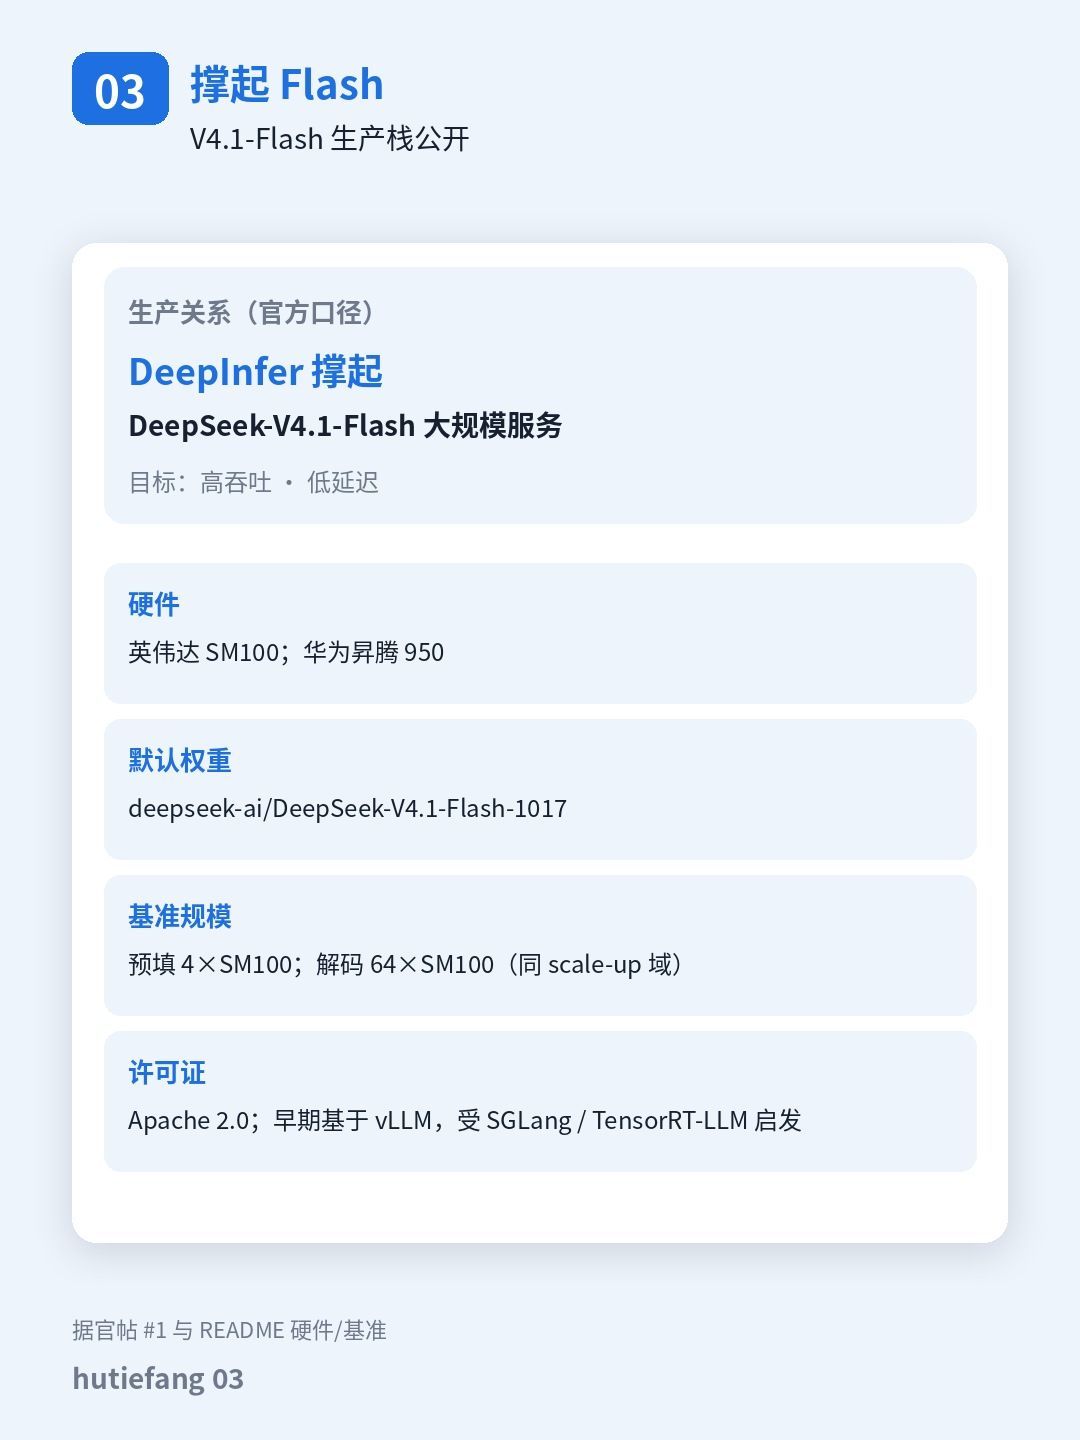
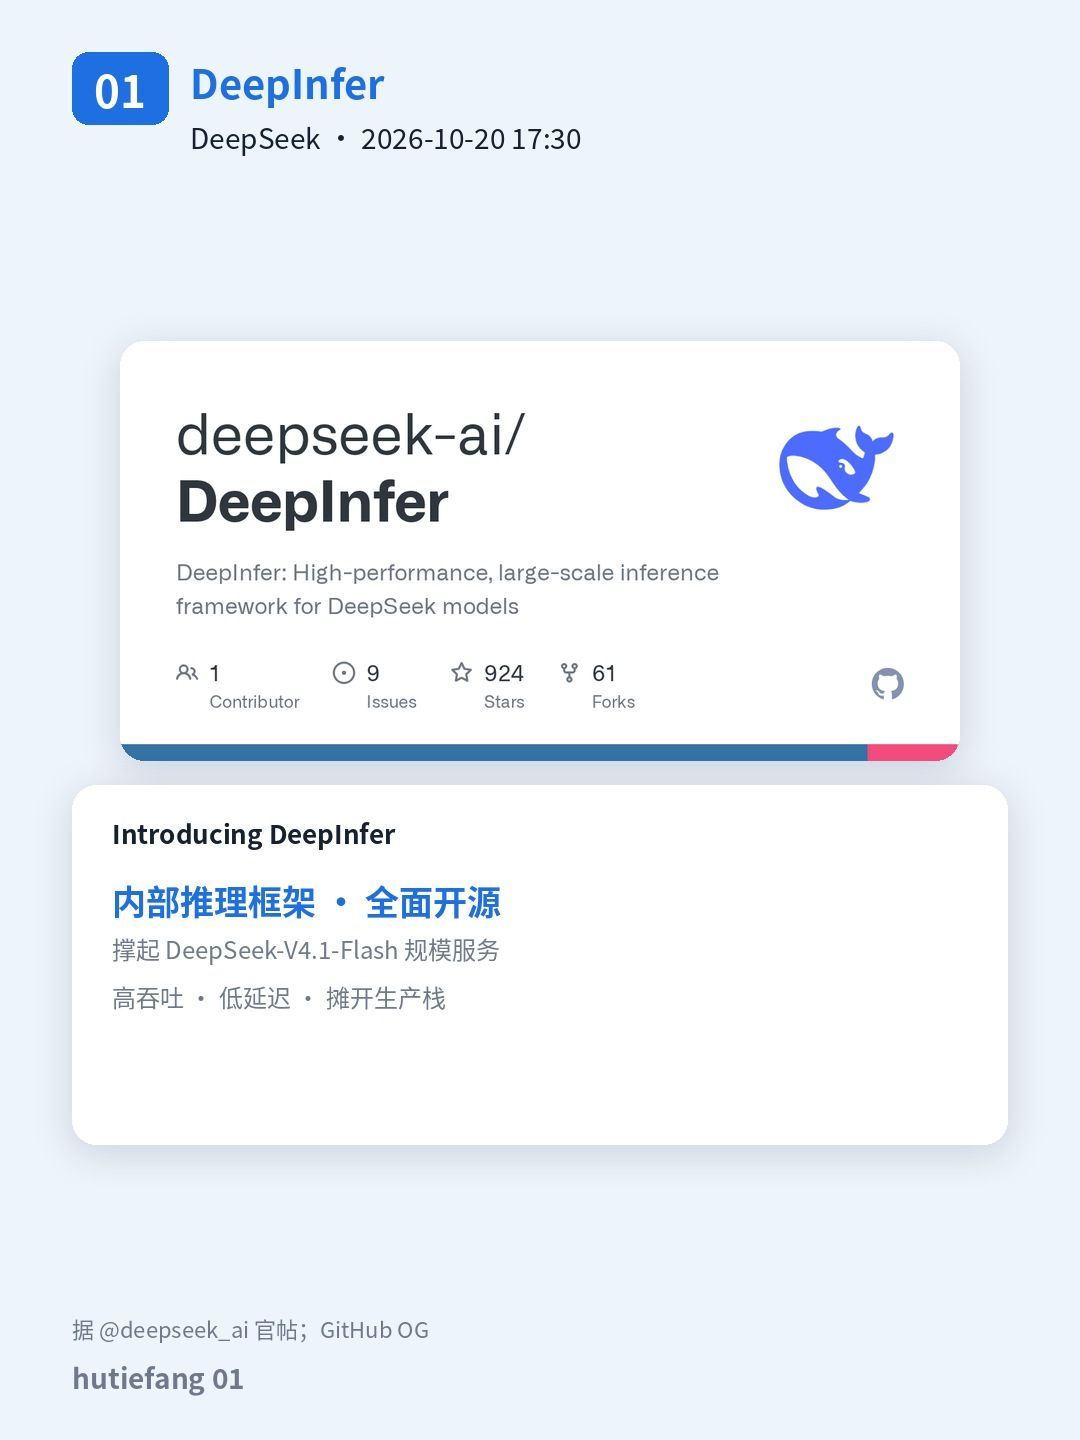
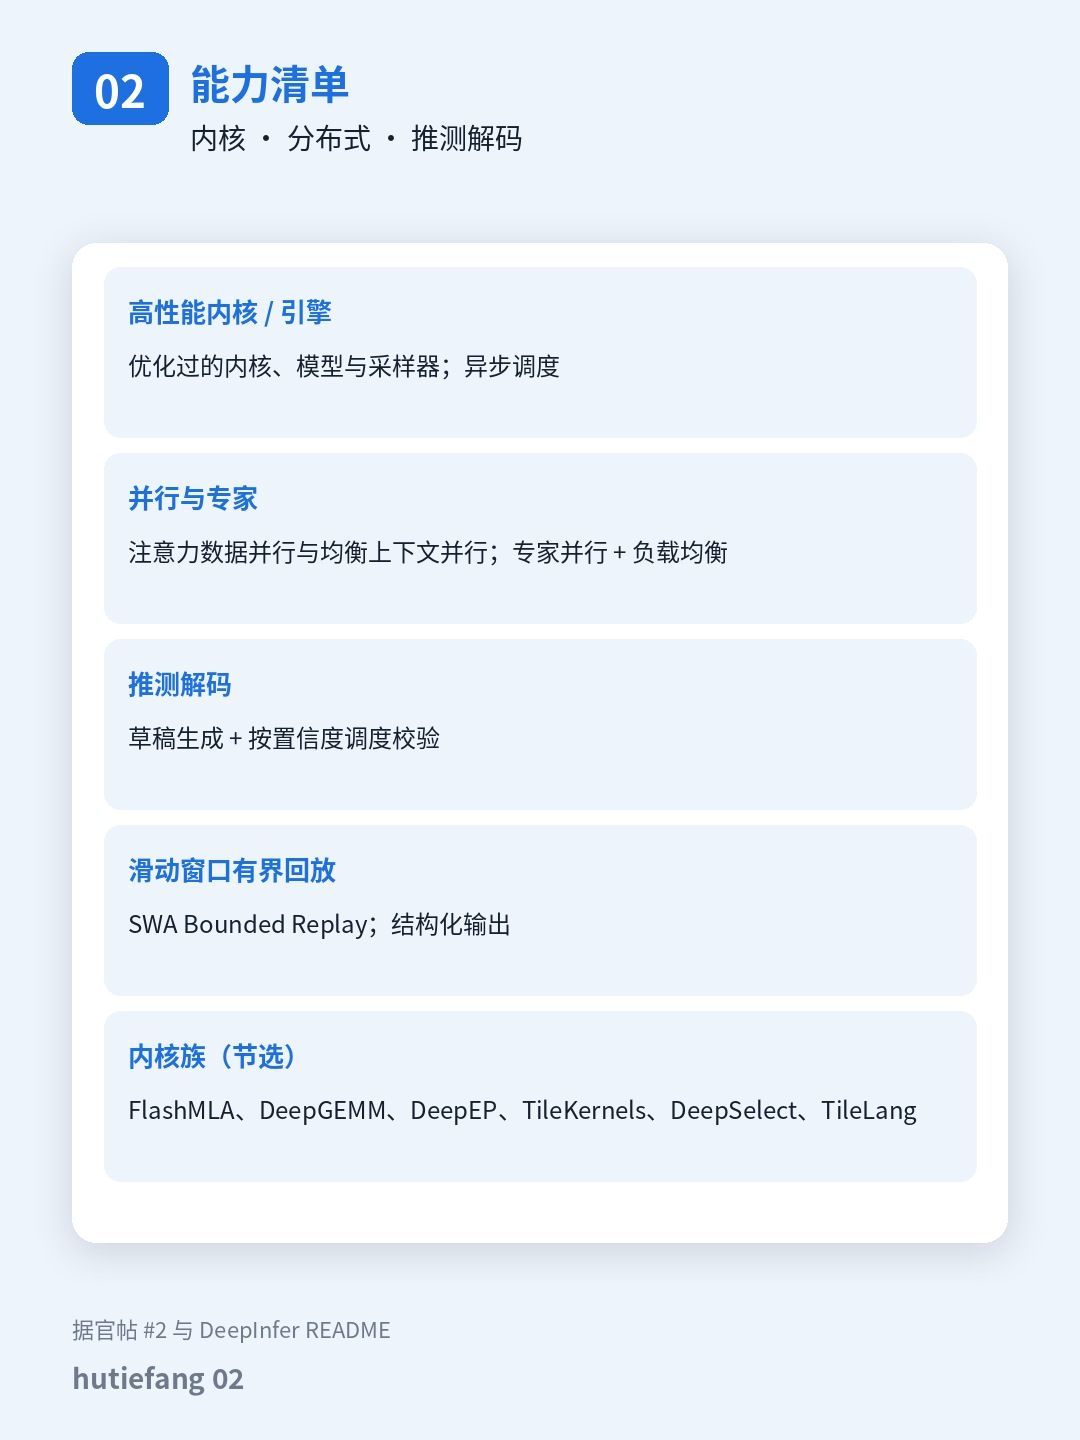
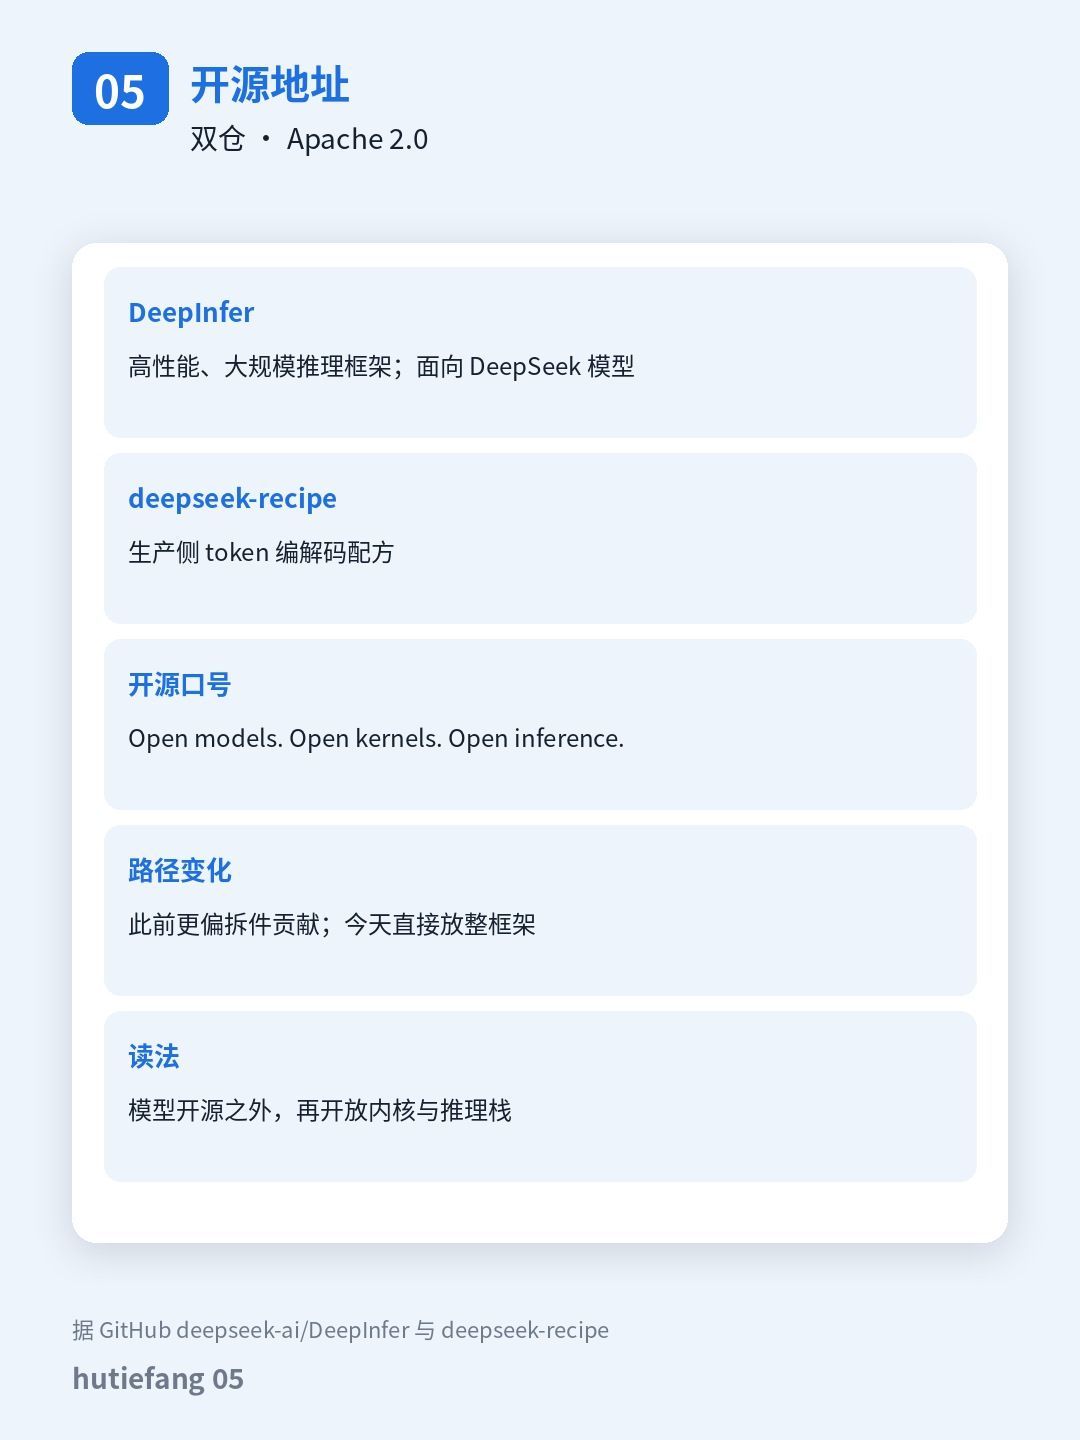
DeepSeek推理引擎开源这可以说是大模型行业这两年最破局的一步棋。过去整个行业心照不宣守着一条潜规则:模型权重可以开源,甚至可以随便商用,但推理调度的核心工程能力必须攥在自己手里。这才是各家API服务的利润底牌——靠着闭源的调度优化,厂商能把自有服务的成本压到社区自建根本追不上的水平,靠信息差稳稳赚着推理的差价。现在DeepSeek直接把这张底牌掀了,连生产级的调度逻辑、成本结构、双硬件适配方案全盘公开,等于把整个推理服务的定价体系摊在了阳光下。先说最核心的技术逻辑,这次真正值钱的不是“开源”这个动作本身,而是Prefill与Decode物理解耦这套思路落地的完整工程方案。行业里做推理的都知道,传统框架一直躲不开一个死结:提示词预处理和逐字生成这两个阶段,一个吃算力、一个吃显存,绑在同一块GPU上跑就只会互相抢资源,最后首字延迟下不来,长序列吞吐上不去。过去各家都有自己的优化手段,但没人愿意把完整方案放出来,毕竟这是拉开成本差距的关键。DeepInfer直接把两个阶段从硬件层面拆开调度,Prefill阶段堆算力集群并行吞吐,把提示词处理的速度拉满;Decode阶段针对长对话做流水线优化,靠低延迟通信算子完成跨节点流式交接。再配合96%命中率的KV缓存跨会话复用,最终跑出来的指标是实打实的硬实力:首字平均延迟压到400毫秒,解码吐字速度230tps,单集群一天能处理155万亿Token,折算下来单卡每小时能产出38美元的营收能力。这组数据是什么概念?它意味着长上下文对话、复杂智能体这类之前成本居高不下的场景,现在有了规模化落地的可能;很多因为延迟和成本一直没法商用的AI应用,终于能算得过来账了。硬件生态这一层的意义甚至比技术本身更深远。之前生产级推理框架几乎是英伟达CUDA的一言堂,国产芯片不是不能跑模型,是跑不出商业化的高效能。底层算子缺失、调度逻辑不配套,导致很多国产算力集群只能跑些演示场景,一到高并发生产环境就掉链子,这是比硬件制造更隐蔽的软断层。这次DeepInfer不是简单做个兼容补丁,而是从底层通信协议到核心算子,针对华为昇腾950做了原生重构,支持超节点跨卡全连接高速互通。这相当于给国产算力芯片免费送了一套原厂级的推理调度范本,直接打通了从“能跑”到“好用”的工程断点。对国内数据中心和算力运营商来说,从此多了一套脱离单一硬件依赖的成熟方案,算力多元化部署不再是喊口号,而是能落地的选择。这对整个国产算力产业链的带动,远比一个框架开源的影响要大得多。放到整个行业里去看,这记重拳直接打碎了维持了好几年的商业模式。以前推理服务商敢卖溢价,靠的就是“我有独家优化,你自建做不到这个成本”的信息差。现在DeepSeek不仅开源了引擎,还同步放出和官方API完全对齐的编解码组件,也就是说企业拿自有算力部署,就能复刻出和官方同等级的推理能效。等于直接把推理服务的成本曲线公之于众,单卡每小时38美元的创收能力摆在台面上,所有靠黑盒优化赚差价的厂商,都不得不跟着卷性价比、卷透明度。靠隐藏工程技巧维持高毛利的老路走不通了,接下来推理服务的价格战只会越来越激烈,而成本下降最终会一层层传导到应用端,让更多行业、更多场景用得起大模型,这才是对整个行业最普惠的改变。敢把吃饭的家伙拿出来开源,DeepSeek打的根本不是“放弃利润”的算盘,而是换了个赛道竞争。当所有人还在卷模型参数、卷跑分榜的时候,它已经把战场拉到了工程生态层面。现在把框架开放给全行业,让开发者、云厂商、硬件厂商都围绕这套标准做适配、做优化,用的人越多,这套方案的生态壁垒就越厚。未来大模型的核心竞争力,早就不是某一段闭源代码,而是整个产业的共识和标准制定权。从做模型的厂商,变成定义推理基础设施的玩家,这步棋的格局,比闭源赚那点API服务费要大得多。当然也没必要过度神化。开源代码只是拿到了入场券,真实生产环境里十万卡级集群的运维经验、故障自愈能力、极端流量下的稳定性调优,这些都是代码里写不出来的硬功夫,还需要整个产业链慢慢磨合。但不可否认的是,这一步已经把整个行业的水位拉高了。往后再想靠信息差、靠藏技术赚推理的钱,只会越来越难。大模型的竞争,终于从纸面参数的比拼,落到了工程能力和产业普惠的实地上。头部热点创作计划 DeepSeek推理引擎开源