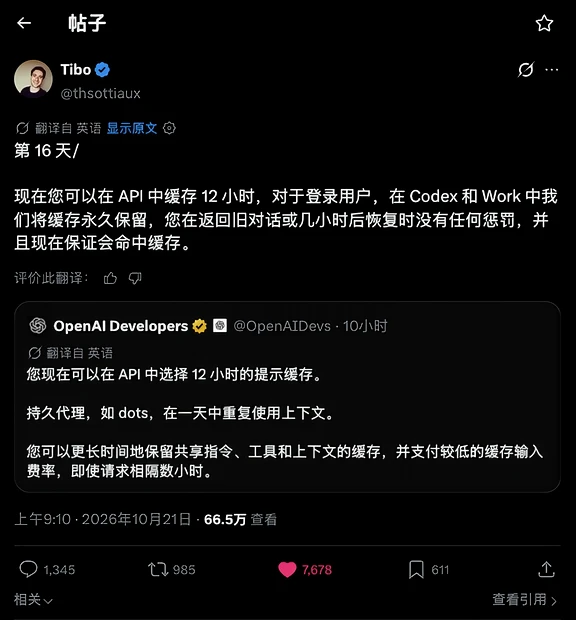
Tibo 的挑战到 Day 16 更新了个「永久缓存」,𝕏 上已经有说是牙膏挤爆了。咱也标题党了一把嘿嘿,但这里头还真有点门道!
很多朋友可能不太理解永久缓存是个啥啊,小小地聊一下。
做长任务的朋友可能比较有体感,有个活干一半,你出门吃个饭再回来继续,或许会觉得它反应比之前更慢一点。
是的,是真的可能会比你饭前慢,而且实际上消耗的 token 也可能会更多……
因为之前留在缓存里的东西,默认半个钟会过期。你吃完饭回来,相当于它其实半失忆了,想继续对话,AI 就得重新处理一遍之前的东西。
这里再补充说下提示缓存(Prompt Caching)。
咱新开一个对话,在你输入的提示词之前,其实还有很多你还没看到的内容,比如系统提示啦、工具定义啦这些。一般呢,AI 会把这一大堆东西,加上历史对话先处理一遍,生成内部状态(KV cache)放进缓存里。
下次你这对话发过来,欸,它发现是这不我之前处理过的提示词前缀(Prompt Prefix)嘛,这不直接在我的缓存(cache)里能找到嘛!那我就可以直接复用,这次只处理新增的那部分。从缓存里找到东西,叫缓存命中,命中的 token 费用是缓存价。与之对应的,普通正常输入的 token 价格,就是全价。
要知道,这俩价格是 10~20 倍的差别。比如 GPT-6.1 Sol,全价是 2 刀,缓存价是 0.1 刀(每百万 token,便宜 20 倍)。Astra 是 10 刀 vs 1 刀,便宜 10 倍。
那再回到 OpenAI 这个更新,中译中一下:
以前你吃完饭回来呢,不好意思缓存有效期过了,咱这个得重算,按全价再给你收一次费。不仅更慢,额度还消耗得更多。
现在,#OpenAI 大手一挥说,你随便休息不管多久,回来接着干活的时候,之前的东西我还给你放缓存里呢,还是按便宜的缓存价来,立省 95% 费用!
严谨点来说呢,立省的是缓存命中的那部分输入 token,不是整个任务,但对于动不动几十万 token 的长上下文任务来说,省下来的也不容小觑。
这就是永久缓存里「永久」的魅力啊朋友们,谁不喜欢额度消耗得少少的呢!对了,这个是对 Codex 和 Work 里的永久,API 的缓存是可选为 12h。
所以说呢,这次的更新之后,大家的额度理论上会变得更耐用一些~不多说了,我去猛蹬了,祝大家蹬得愉快!
#Tibo #ChatGPT #vibecoding #AI