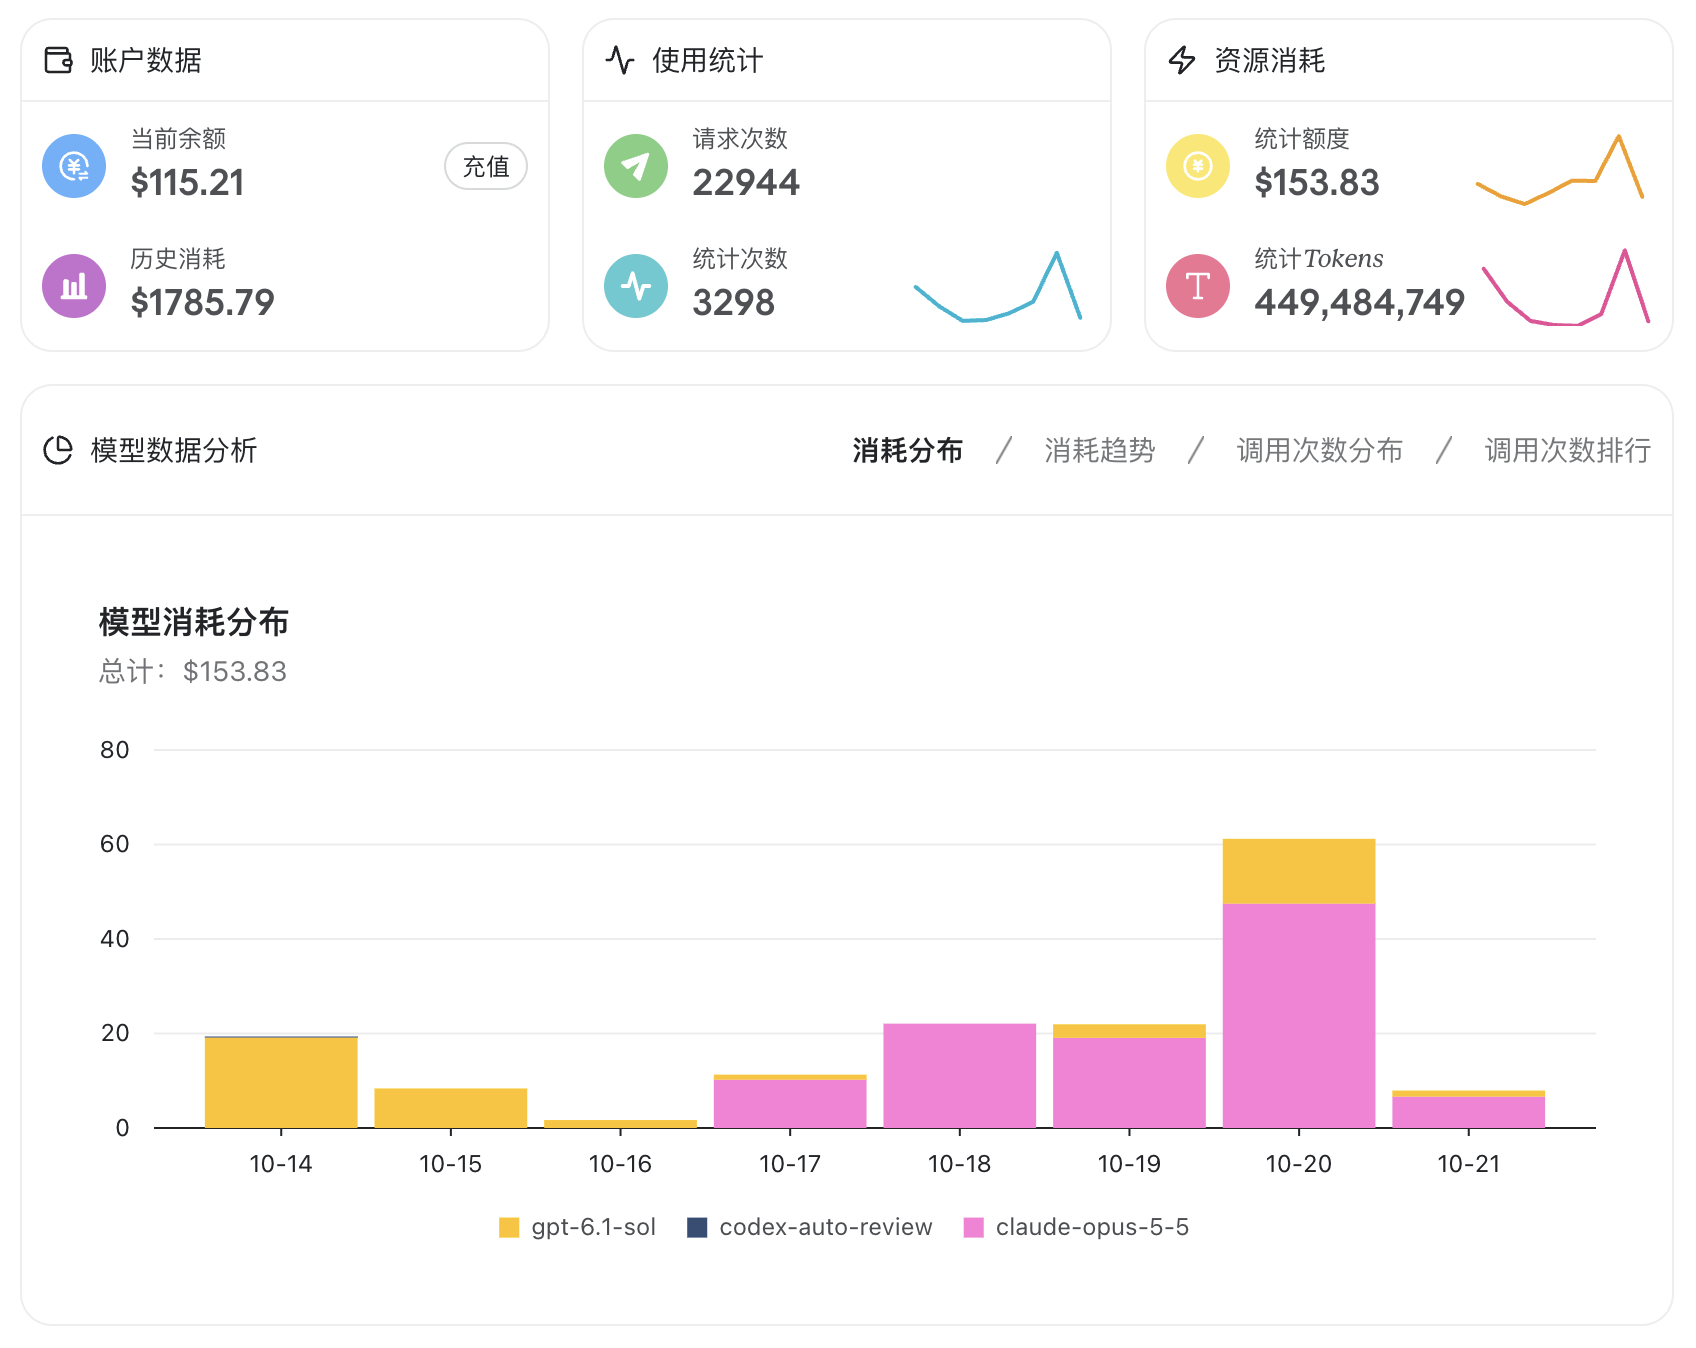
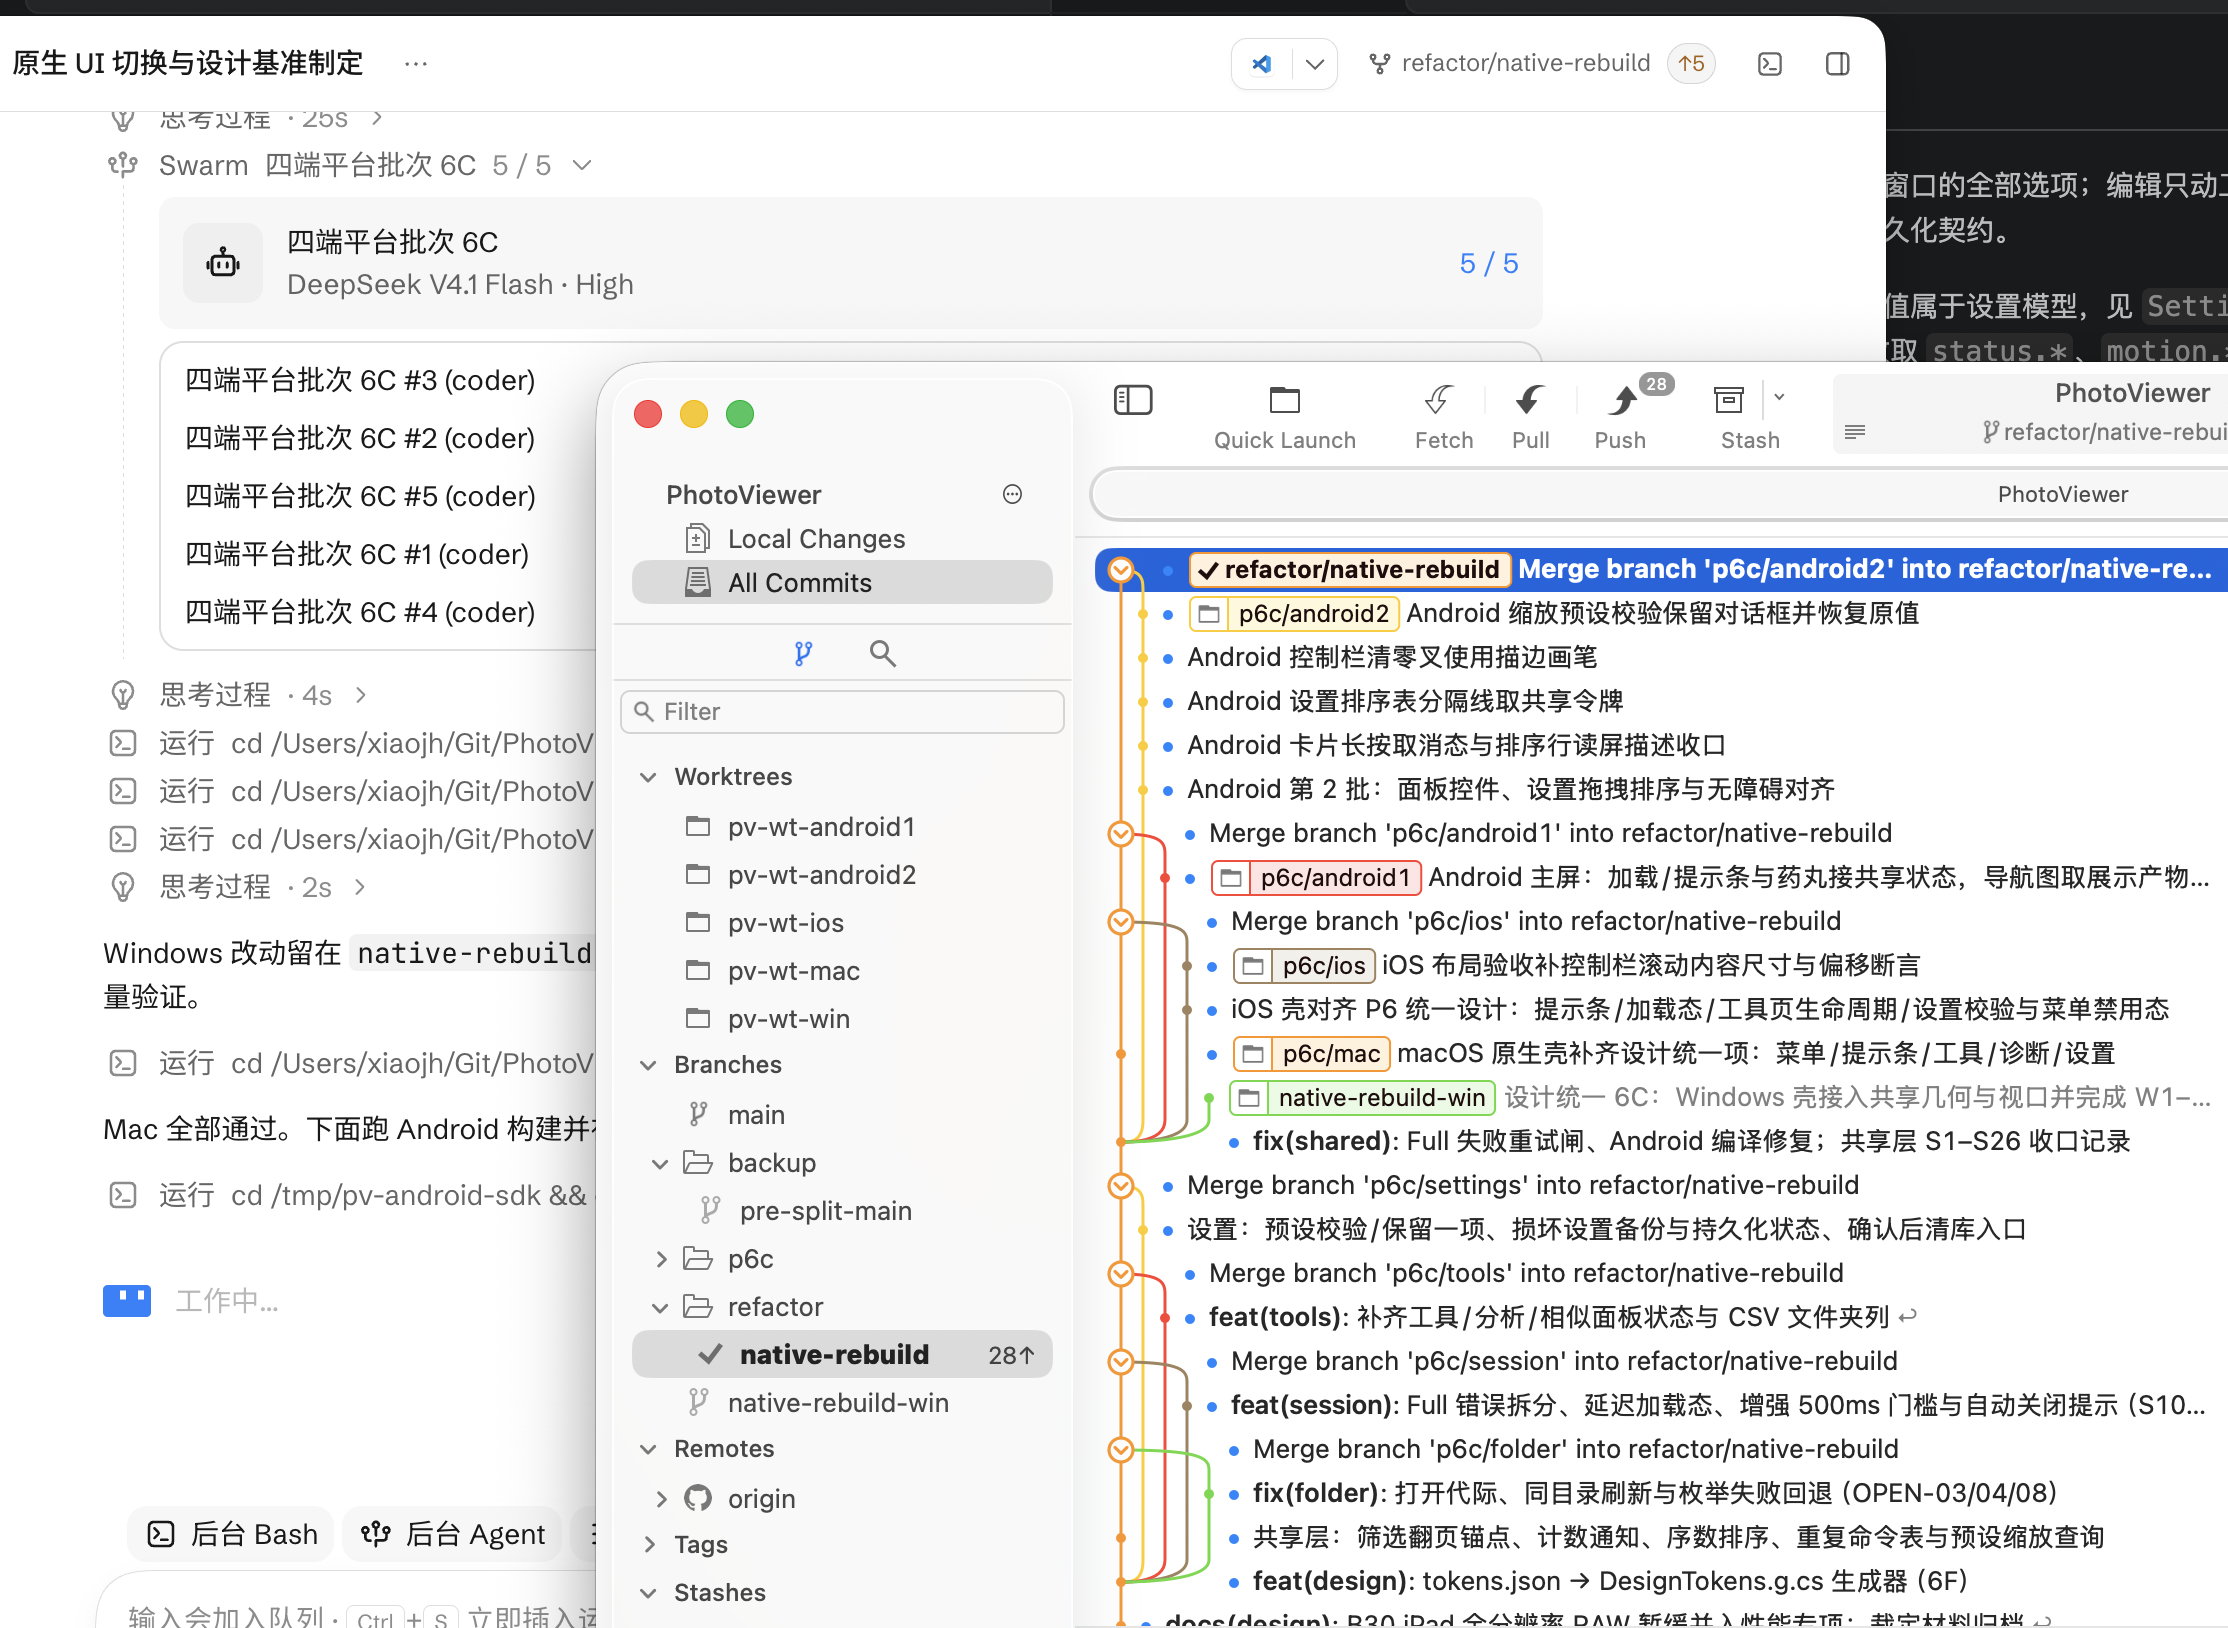
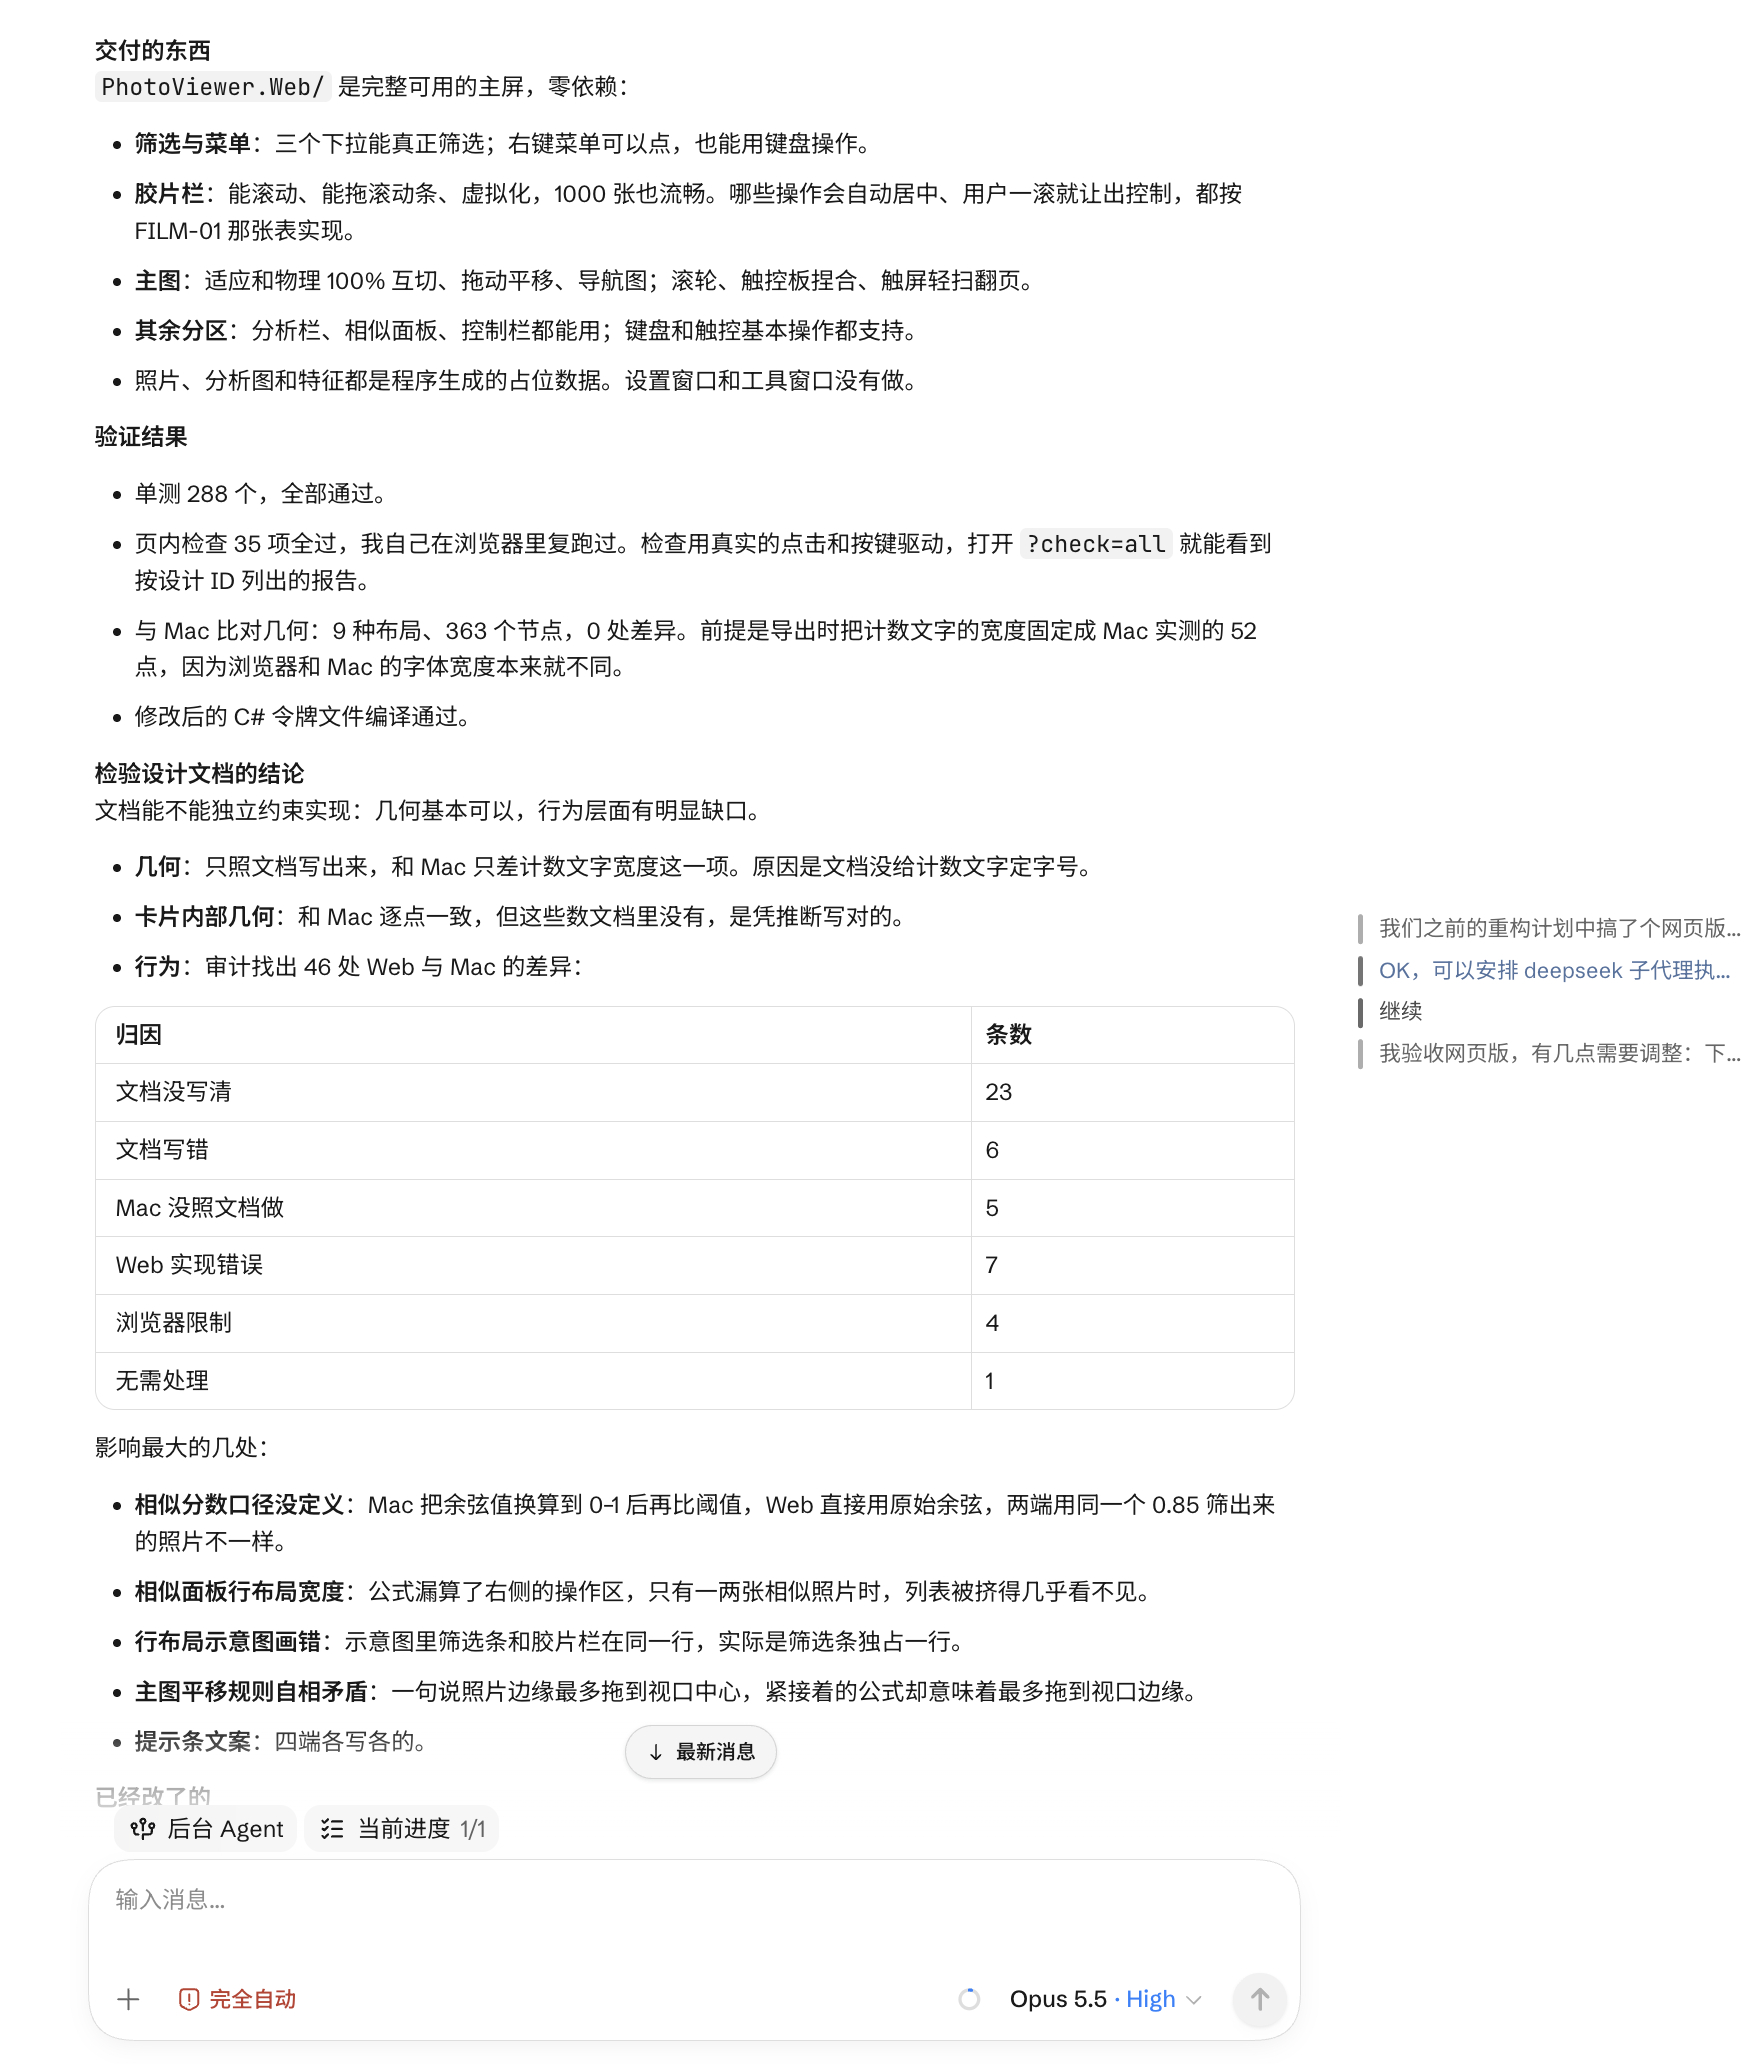
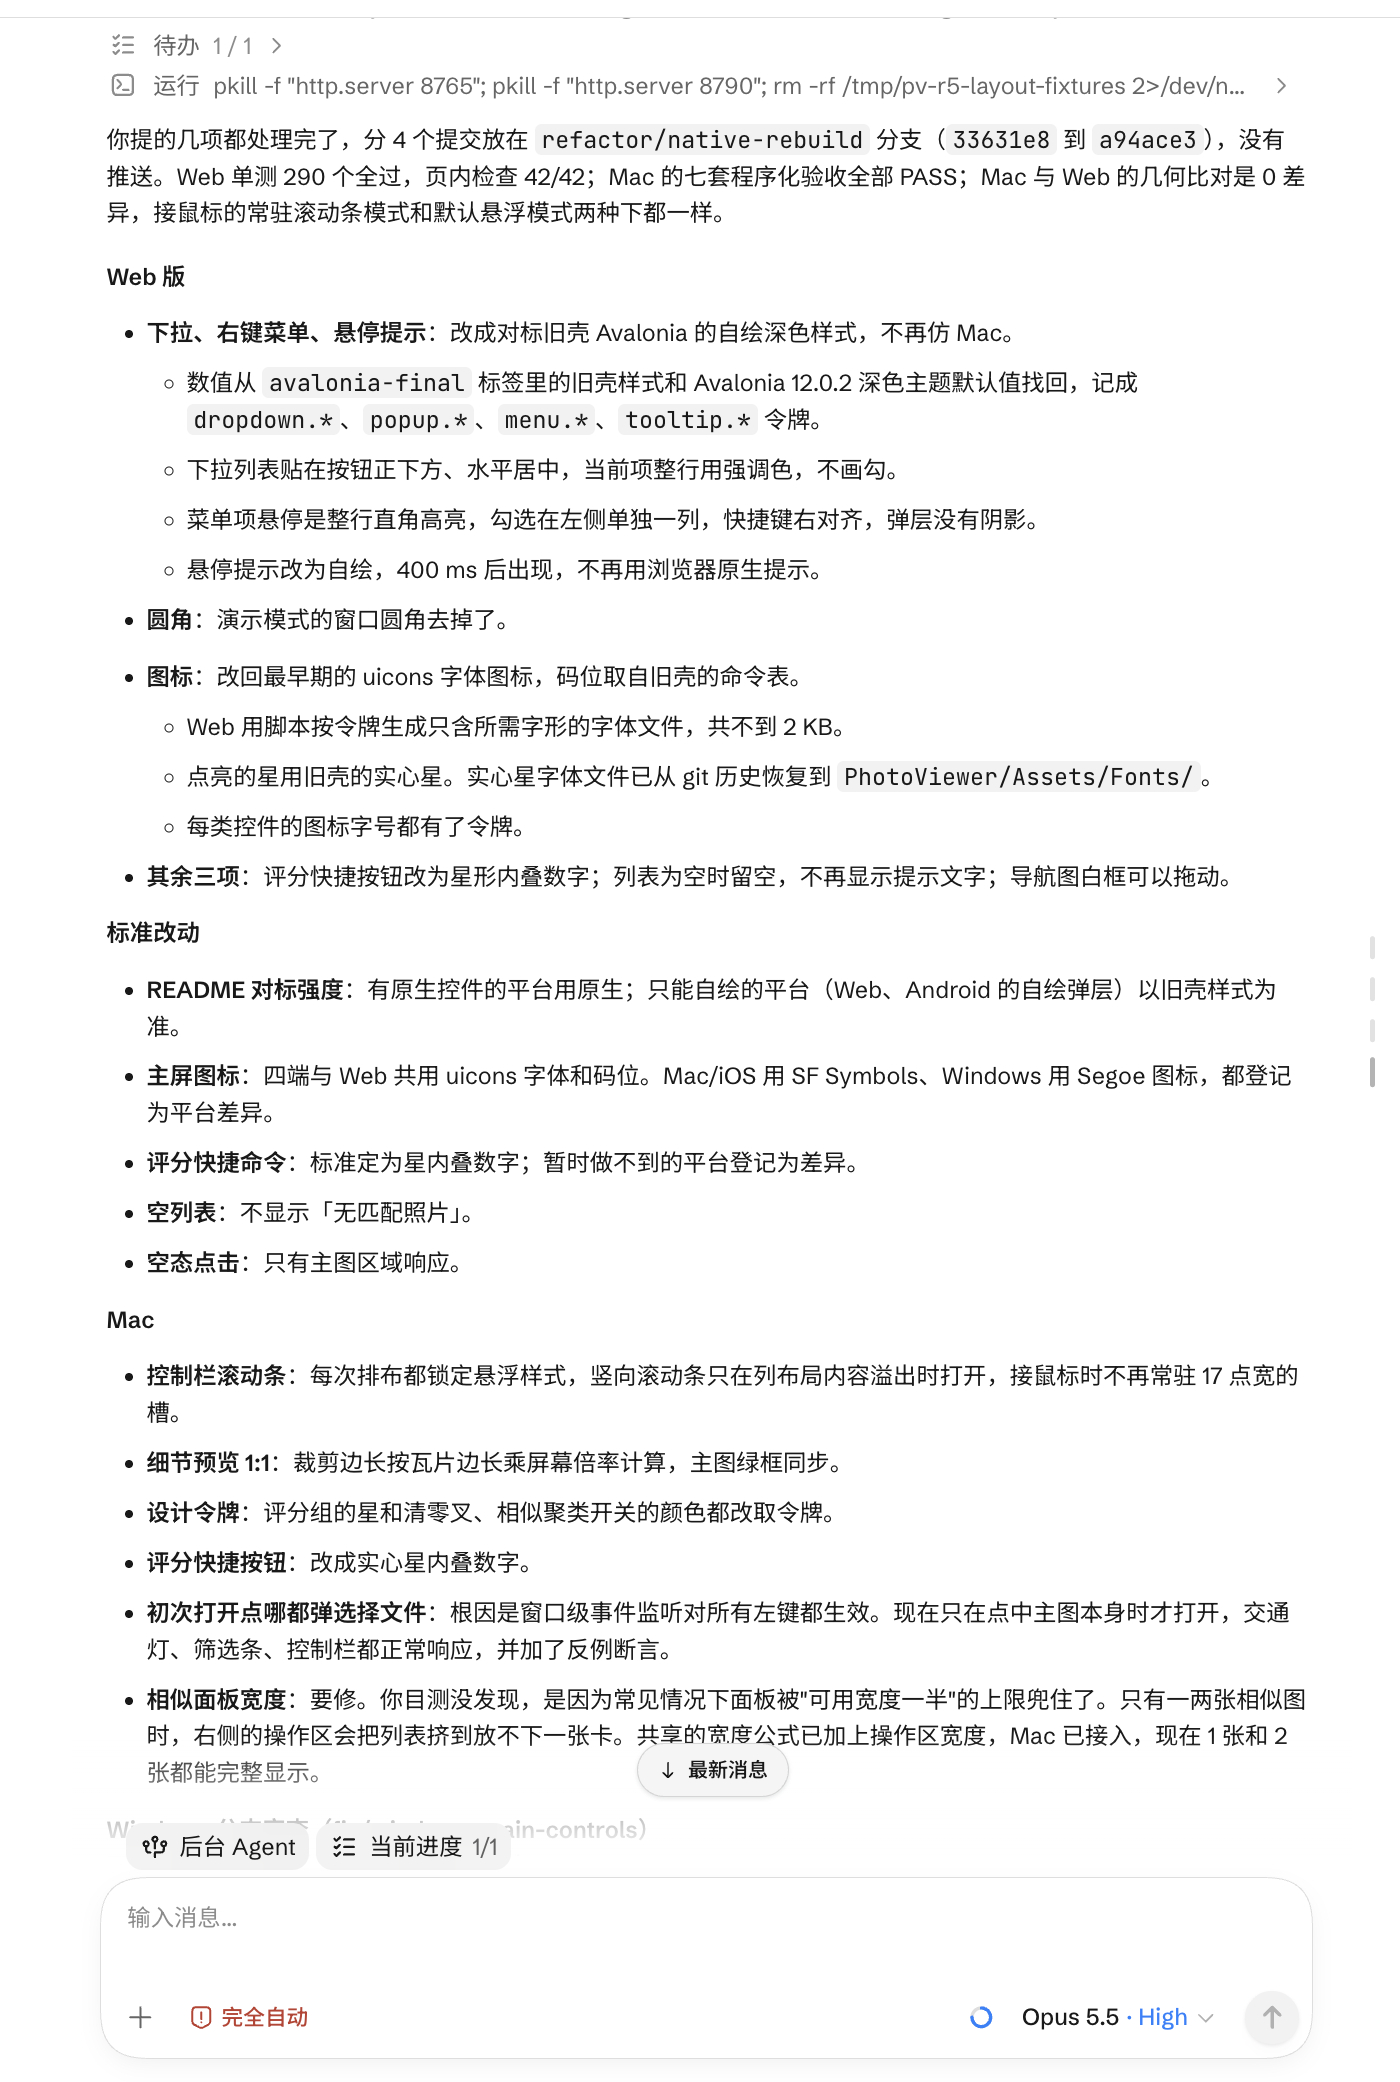
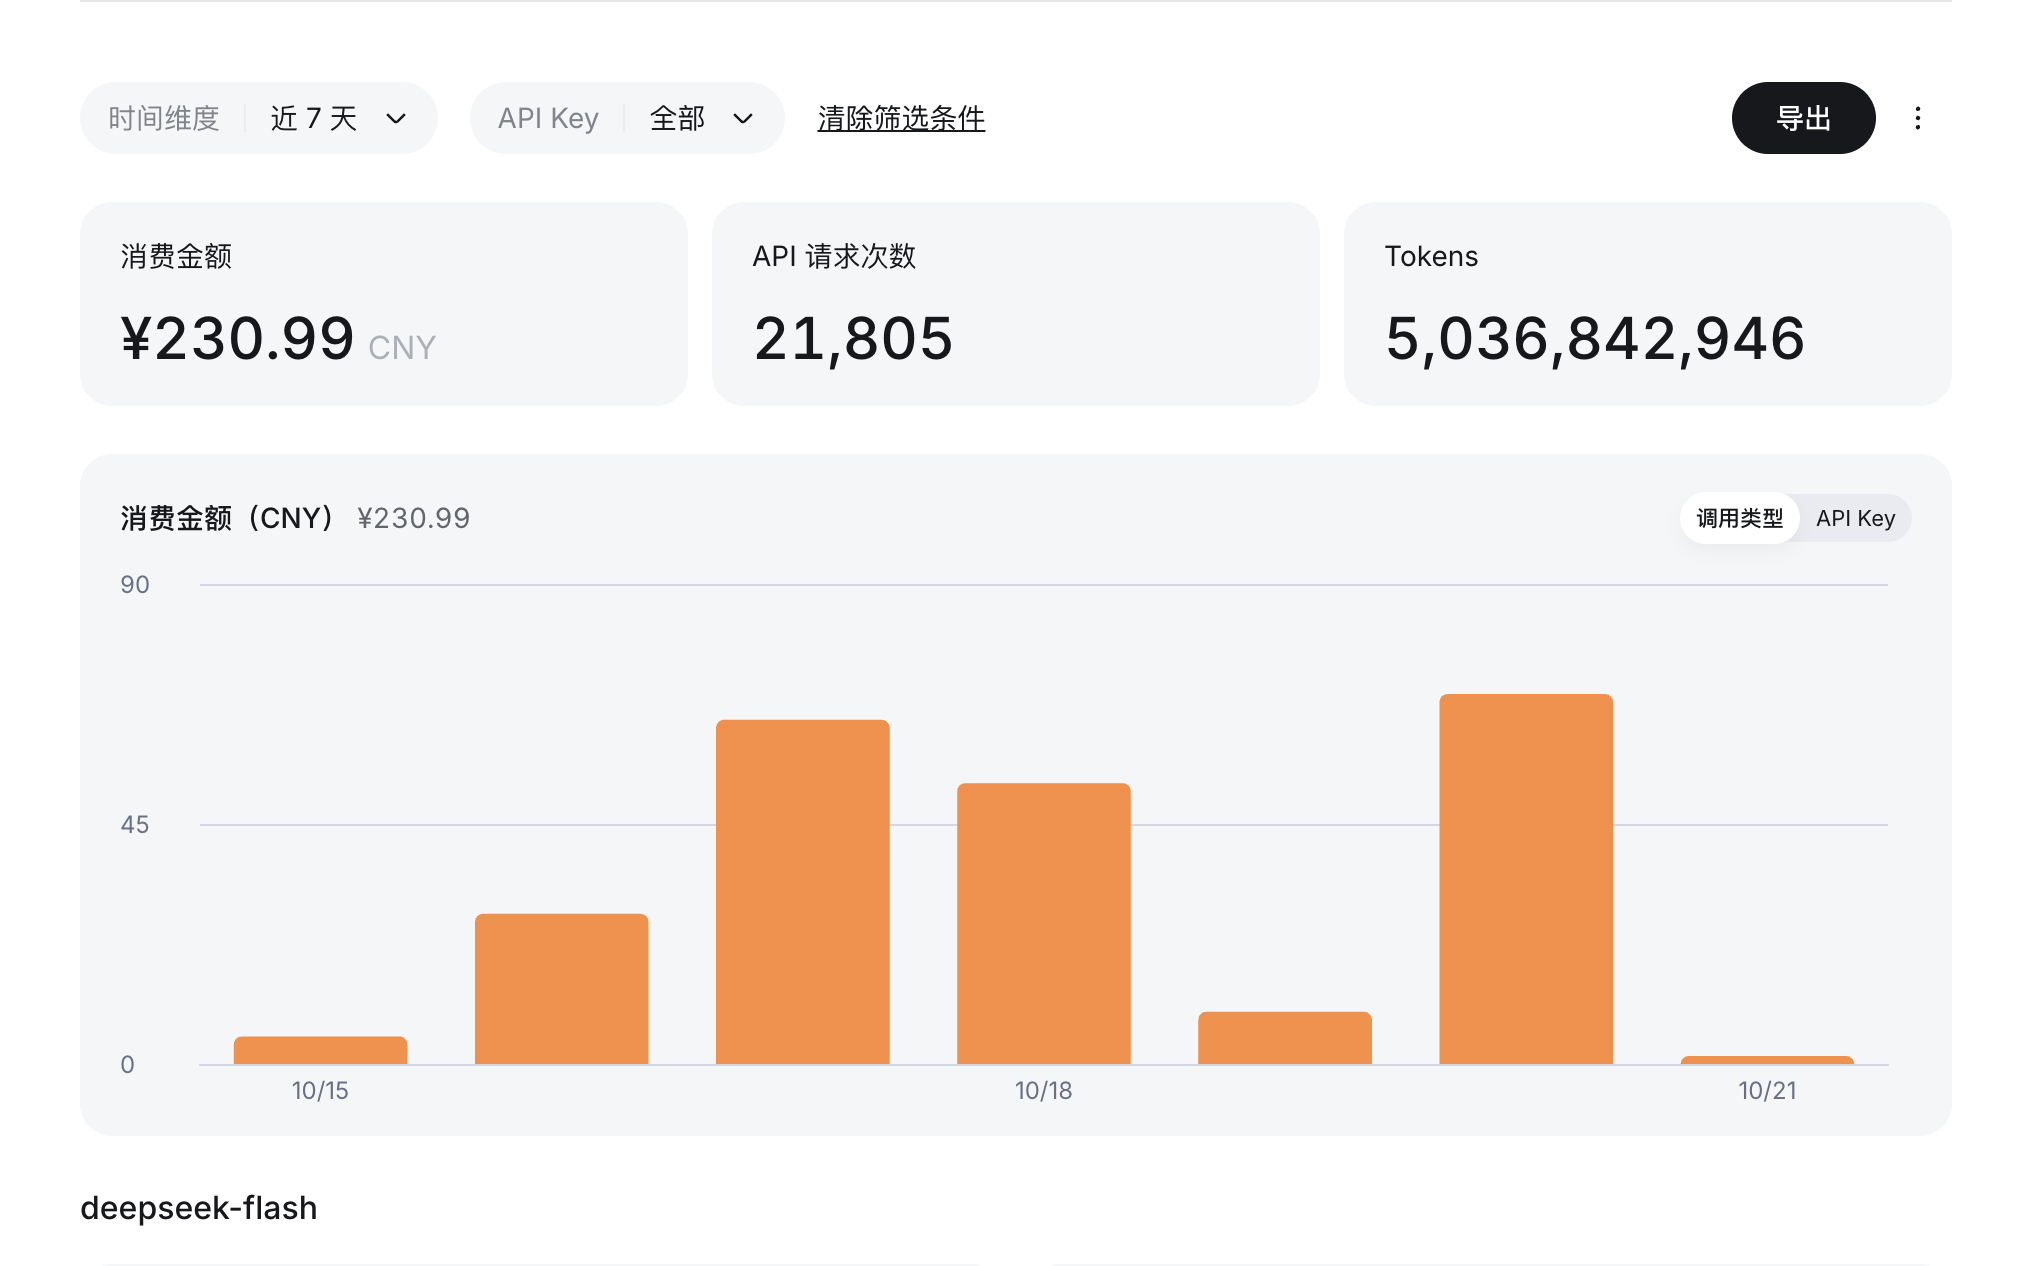
这几天大量使用 Opus 5.5 和 GPT 6.1 Sol 作为主模型,指挥 DeepSeek Flash 干活,执行 PhotoViewer 的原生 UI 重构任务。没想到 DeepSeek 谷价一天也能干出六七十,最近几天 5000M tokens 已经相当于一个月的量了。
如果说 Opus 4.8 相当于一个有 3 年经验的程序员,那 Opus 5.5 简直相当于一个 5~10 年经验的资深主程,作为主模型给 DeepSeek 派活极其顺畅,自己只做需求理解、方案制定、分发执行、关键决策把关,把一群子代理管得明明白白,一个任务一次上下文能连续跑一整天。DeepSeek 也是个好员工,拿到任何方案计划都能准确遵循、负责自检,还又快又便宜。
他们一起产出的方案扎实、代码质量优异、文档留档规范,基本上人类团队都很难做得到,因为人会偷懒。
Opus 5.5 顶级的需求归纳能力、方案制定能力、自主的规范遵循,就没有哪个模型能做到同样效果的。同一个问题直接交给 DeepSeek,会拿着报错斩钉截铁说你这缺条件做不了;交给 GPT 6.1 Sol,会走错误路线做一半卡住,然后说剩下那一半没办法,给你打个文档补丁吧;交给 Opus 5.5,从拿到就知道最规范的方式该怎么做,直接下发任务给 DeepSeek,结果立等可取。
GPT 6.1 Sol 疑似瞧不起 DeepSeek 作为子代理,拿自身作为子代理,最后执行不过关打回去三次,我看主 GPT 和子 GPT 的聊天记录,看起来跟我亲自和 GPT 对线一样痛苦,就是那种来来回回说半天说不明白的傻逼感,最后交上来一个从方案选型就在瞎搞的垃圾。反而 DeepSeek 执行的几个任务全部通过。
顺带一提,K3 现在还是有点力不从心了,她在那个 Fable 5 太贵、5.6 Sol 说不明白话的七月份,就是我眼里最好的模型,我对她充满了信任。但三个月过去,现在除了文档能力依然比 GPT 会讲中文一点,计划能力也就那样了。只要用过更好的模型,当次等模型犯错时,信任就会被逐渐消耗殆尽。K3 和 6.1 Sol 现在就处在这个尴尬的次级地位上。
我虽然不用 K3 了,但依然在用 Kimi Code,Opus 5.5 用起 Swarm 来如鱼得水,DeepSeek 在里面执行任务也不比 DSH 差。Kimi Computer Use 给 DeepSeek 用也完全会用,还能当 MCP 接给 DSH 用。不用把自己绑在 Codex 和 Claude Code 上,那就是俩出生企业想办法多烧你 token 的诱导性前端。
哦最近还有个 Gemini 4,我看依然还是只会说漂亮话,方案不想清楚,任务干一半就跑,剩下的代码一点看不懂啥意思,让 GPT 帮忙收尾愣是干出了翻倍的工作量才勉强能用。当然这里不排除是 OpenCode 的问题,任何模型放到 OpenCode 里就是比原生 Harness 傻一整代,难以理解一个 Harness 做这么久还是只会对模型做劣化,怎么活下来的,用来筛选容忍度极高的用户好卖他的降智量化假模型吗。