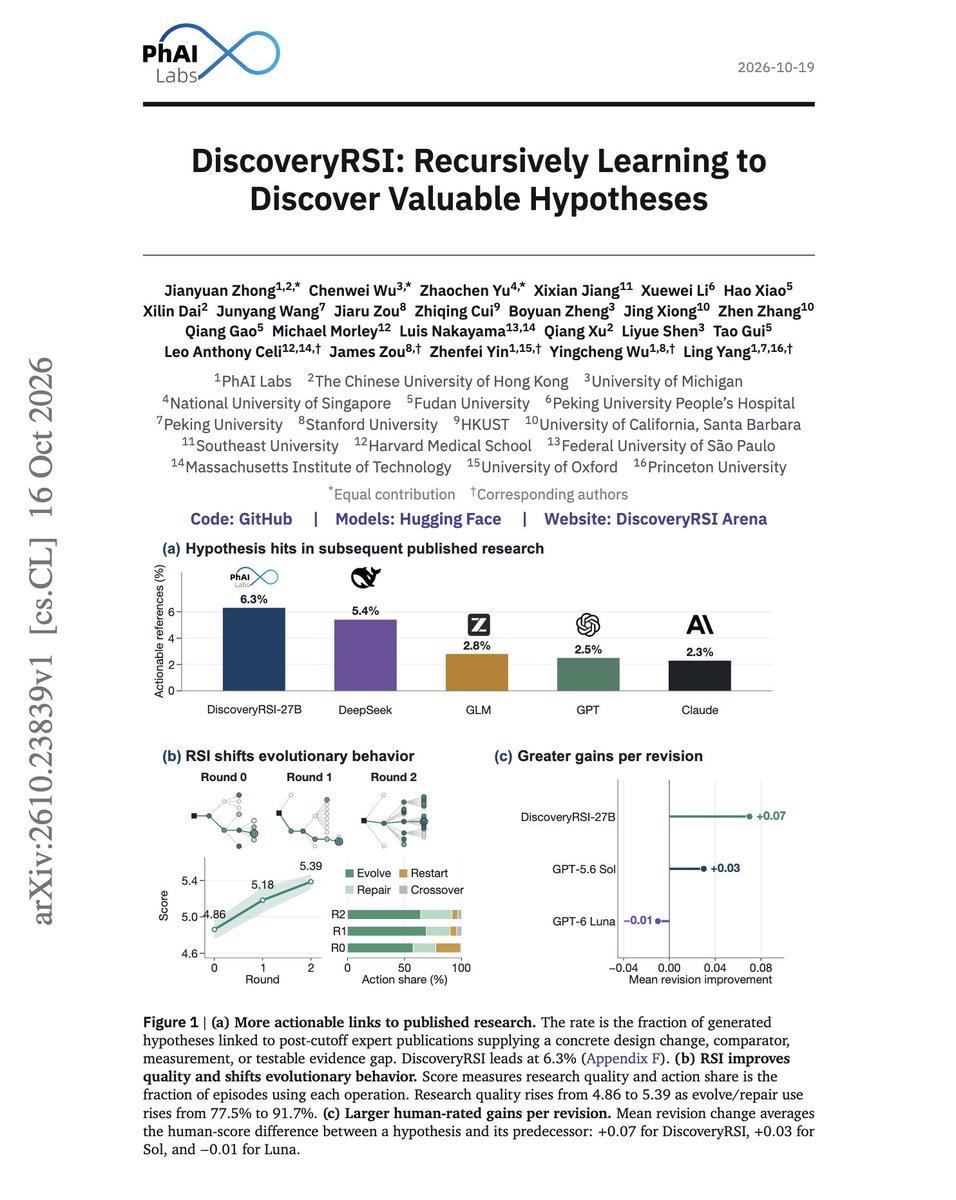
科研假设生成领域出现新进展:DiscoveryRSI框架将递归自我改进应用于生命科学四个领域的假设生成。其27B模型生成的假设,有6.3%与训练截止后发表的研究匹配,显著高于GPT-6的2.5%和Claude Opus 5的2.3%;两轮迭代后,自动化质量评分从4.86升至5.39。
核心亮点在于它把假设发展本身变成可学习的闭环。系统用多智能体进化搜索生长假设树,每个假设必须捆绑证据主张、可执行调查计划、明确决策标准与替代解释。选中的调查会编译成Harbor任务实际跑起来,随后通过三项机制反馈:假设信用优化把科学评估精确归因到具体贡献步骤并用于训练;Harness回放诊断重复探索、工具失败、过早终止等常见失败模式并 refining工作流;再发现则把已验证的模型与流程改进直接应用到新问题。结果是进化/修复操作占比从77.5%升至91.7%,重启从21.7%降至5.0%,可证伪性与数据可解析性提升最明显。论文同时开源了代码、模型和DFM-Bench基准,并提供实时Arena供观察。
这套数字真正有意思的地方,不在于“小模型打败大模型”,而在于它第一次把“研究过程中的信用分配与失败复盘”做成了可训练的信号。如果后续能把真实实验成本与可证伪优先级真正接进来,科研Agent才可能从“生成更多想法”进化到“少做无效实验”。