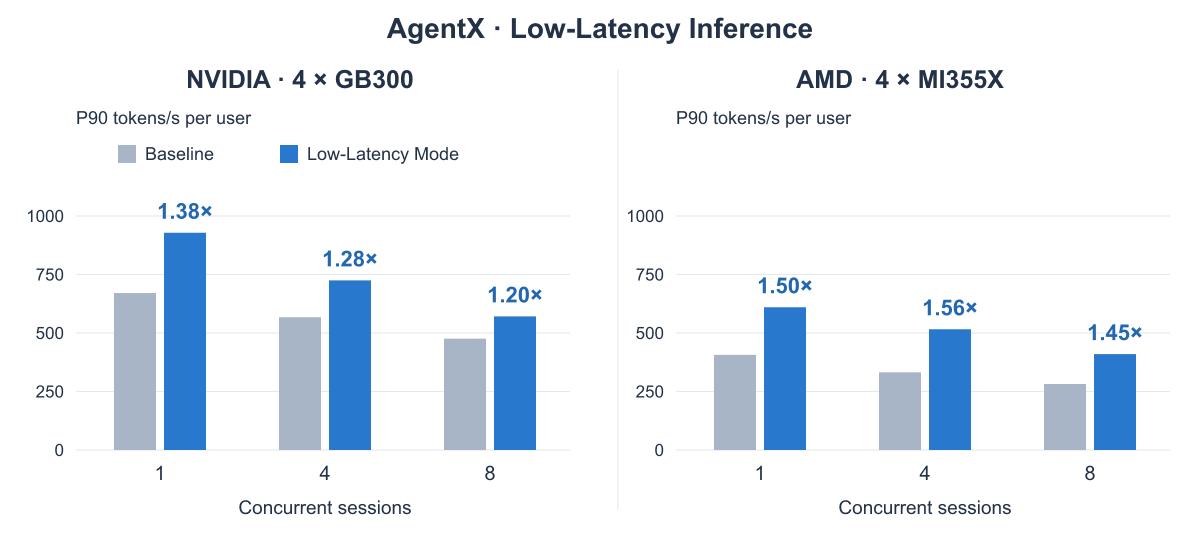
LMSYS组织联合英伟达与AMD,正式发布SGLang低延迟模式。在DeepSeek-V4.1-Flash配合DSpark的AgentX轨迹回放中,四卡英伟达GB300单会话P90每用户生成速度从671提升至928 token/s(1.38倍),四卡AMD MI355X则从332提升至516 token/s(1.56倍)。
真正拉开差距的,是针对低并发场景的内核级改造。英伟达侧通过程序化依赖启动(PDL)让后续内核提前准备,并把跨GPU发送直接写进GEMM收尾阶段,解码层中位耗时从96.8微秒压到68.4微秒,注意力路径收益最大。AMD侧则把原先一层几十个小内核合并成两个持久内核,权重提前加载、跨GPU归约与计算重叠,直接砍掉启动开销与空闲边界。两套实现都通过新的插件系统接入SGLang,外部库可独立注册、校验并回退,核心代码不被膨胀。目前GLM-5.3、K3、MiniMax M3的专用内核也在路上。