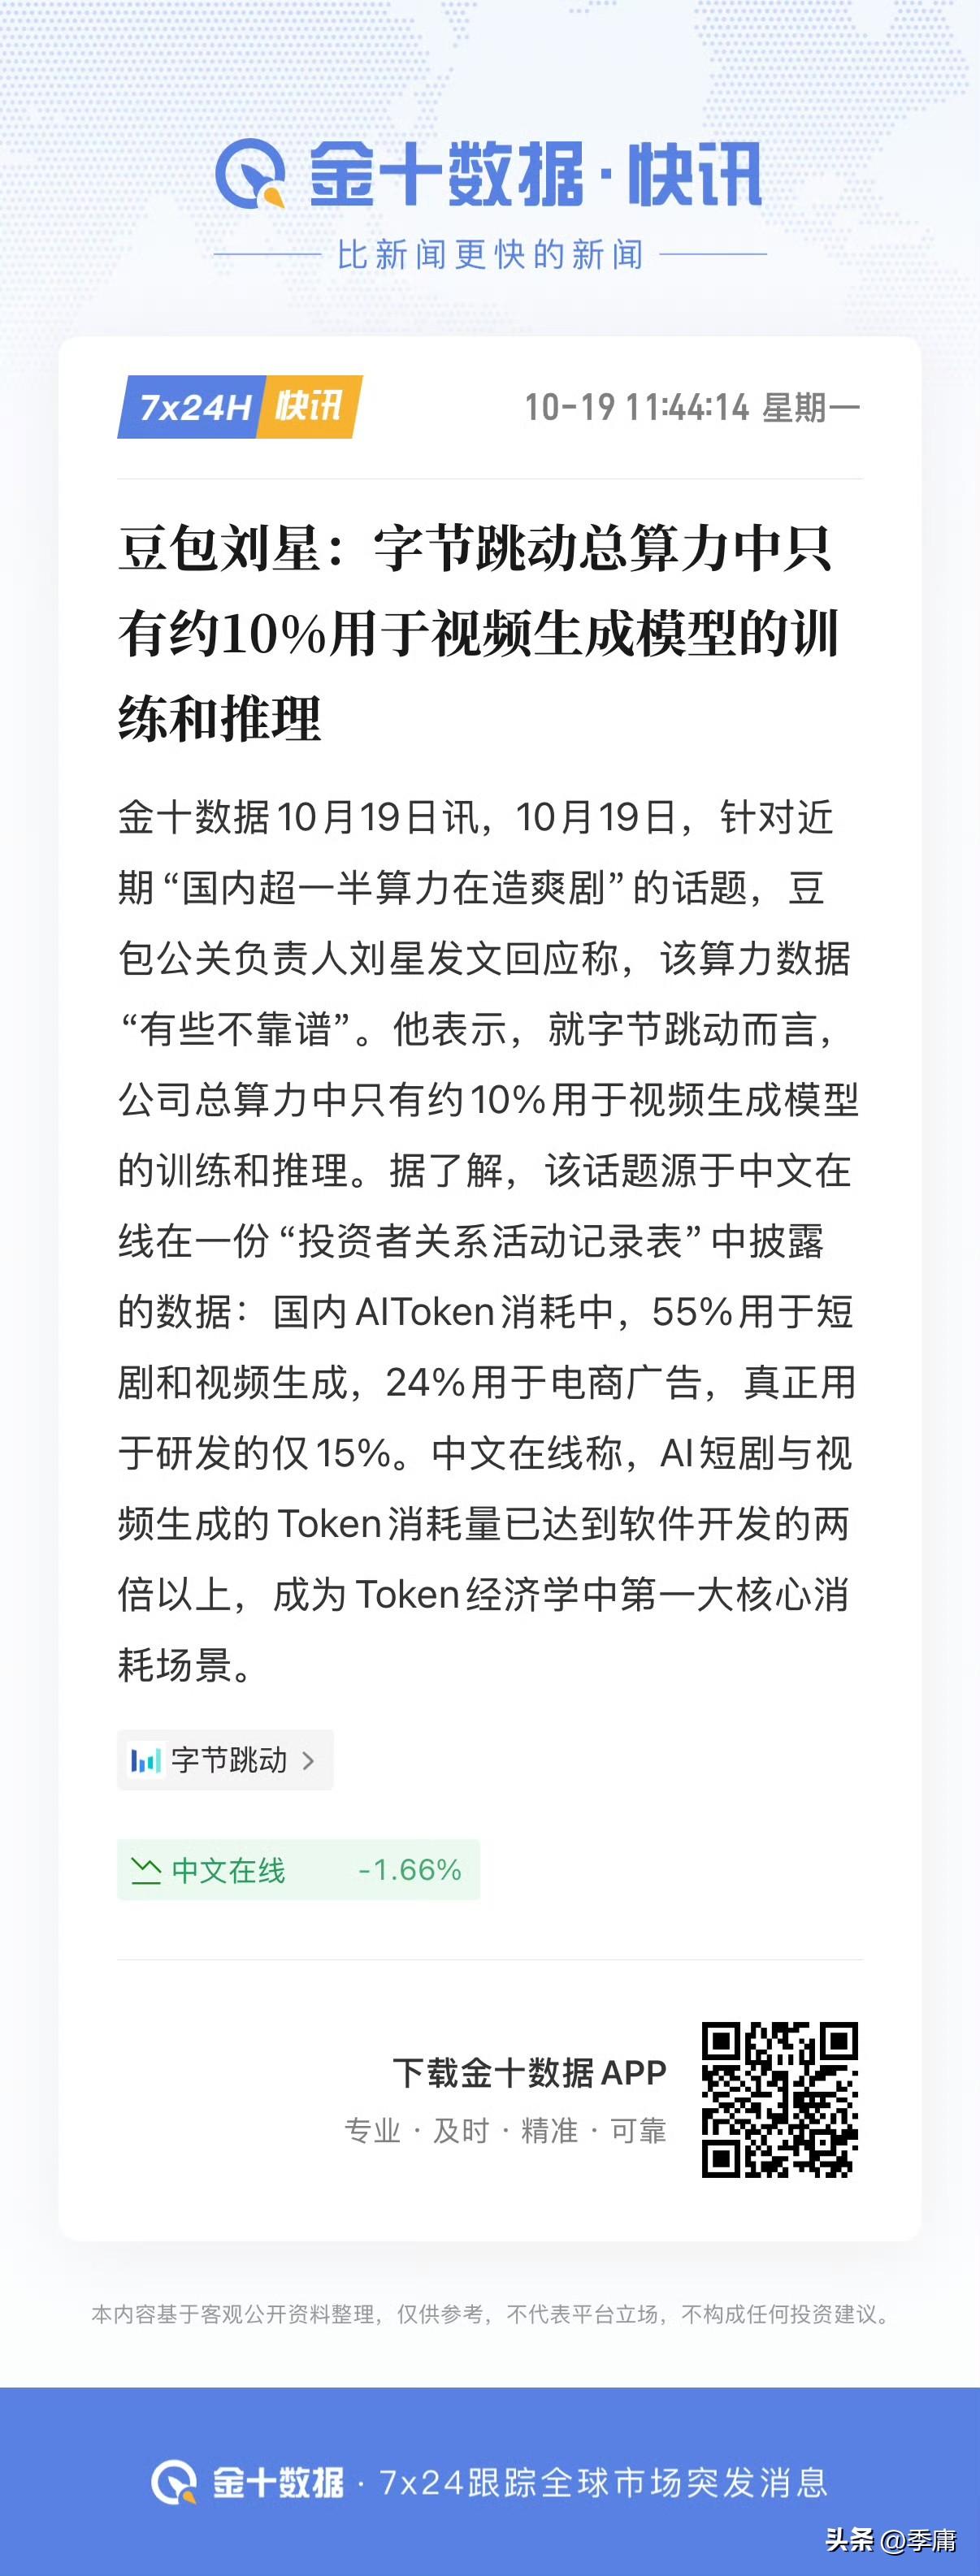
国内超一半算力在造短剧?豆包出来辟谣了:“该算力数据有些不靠谱!”
根据金十数据10月19日报道,近日中文在线披露了一份数据,说我们国内AI Token数据消耗中,有55%用于短剧和视频生成,24%用于电商广告,真正用来进行研发的只占15%。这个数据一出来,立刻引起热议,很多人因此都觉得国内这些公司不务正业,不像美国那样把大部分AI Token数据都用于研发中,并且还引发了一些大V进行所谓的“反思”,说中国科技又如何如何不行了之类的话。
结果,没有想到,10月19日豆包公关负责人刘星直接出来辟谣了,明言这个数据不靠谱,并且还给出了翔实的数据。比如说字节跳动旗下,整个公司就只有10%的算力资源用于视频生成模型的应用和推理。字节跳动如此,其他公司估计也不会差到哪里去,毕竟目前最火的视频生成模型Seedance就是字节跳动旗下的,字节跳动都只用了10%的资源在这上面,其他公司只会更少。
所以说,这一个“国内超一半算力在造爽剧”的说法,很有可能就直接是一个错误数据。一个错误数据却引起了这么大的波澜,并且让中国的AI产业站上风口浪尖,成了被嘲讽的对象,这值得人们的深思。
实际上,现在国内AI产业正发展得如火如荼,表现非常亮眼。在美国限制出口高端算力芯片的背景下,我们在全球最大的AI大模型聚合平台OpenRouter上面,国产大模型的Token调用总量已经是美国大模型的4.5倍,并且已经连续24周高于美国大模型。DeepSeek旗下所有大模型加在一起,更是占据了整个平台24.5%的Token调用量,远远超过第二名OpenAI(18.6%)、第三名Google(17.8%)。
这才是最真实的数据!
对于我们的AI产业,无须担心,从DeepSeek到月之暗面,从阿里巴巴到字节跳动,从长鑫存储长江存储再到华为,等等,大大小小这么多优秀企业,又如何会“不务正业”呢?只需耐心就行,未来我们定会实现全面的超越!