为什么老款小爱音箱不能升级“超级小爱”?中午吃饭,朋友问起这个问题。
大模型明明跑在云端,小爱音箱说白了不就是“收音+播放”吗?为什么几年前买的小爱音箱,不能直接通过OTA升级成“超级小爱”?
看起来像小米逼着用户换新,实际没那么简单。
首先要搞清楚一件事,传统小爱和现在的超级小爱,根本不是同一种交互方式。
早期小爱基本是“回合制”。你喊醒它,说一句话,音箱把录音传到云端,等服务器处理完,再把整段答案播放出来。
超级小爱则越来越接近真人聊天。
它要边听边理解、边生成边说,还要支持连续对话和随时打断。你在它回答到一半的时候插一句,它得立刻知道你是在对它说话,而不是把自己扬声器里正在播放的声音重新识别成指令。
这就不是单纯把“大模型API接上去”那么简单了。
第一个卡点就是内存。
早期小爱为了把价格做到几十、一百多元,硬件能省就省,一些mini、Play等型号RAM只有几十MB,Flash也只够跑基础固件。
而流式对话需要维持长连接、音频缓存、加密认证和更多协议栈。现在看很普通的功能,放在七八年前的廉价IoT芯片上,可能连稳定运行都困难。
第二个卡点反而更重要,就是声学能力。
超级小爱最自然的体验,是“能打断”。
但音箱在大声播放的时候,要同时从麦克风里把自己的声音消掉,再把你的声音准确提取出来,这依赖AEC回声消除、VAD语音检测以及本地DSP算力。
老音箱当年设计时,目标只是安静等你喊一句“小爱同学”。让它一边自己说话、一边继续听你说话,硬件本身就没为这件事准备。
第三个问题,是系统代差。
今天的超级小爱已经和HyperOS、Xiaomi Vela以及新一代米家IoT体系深度绑定,不只是回答百科,还要一句话控制多台设备、创建自动化,甚至未来跨设备执行任务。
而早期小爱音箱大量使用不同供应商维护的定制Linux系统。有些芯片SDK可能早就停止维护了。
想让这些机器支持新架构,不是写个App,而接近重新做一遍底层系统。
还有一个不能回避的问题,就是钱。
以前一句“小爱同学,明天天气怎么样”,背后调用规则库和轻量NLP,成本几乎可以忽略。
今天一句大模型问答,背后是真金白银的GPU和Token。
如果给数千万台已经卖出去多年、售价可能只有几十元的老音箱全部无限开放大模型能力,小米不仅需要投入大量工程师重新适配固件,还要长期承担云端推理成本。
这笔账显然不划算。
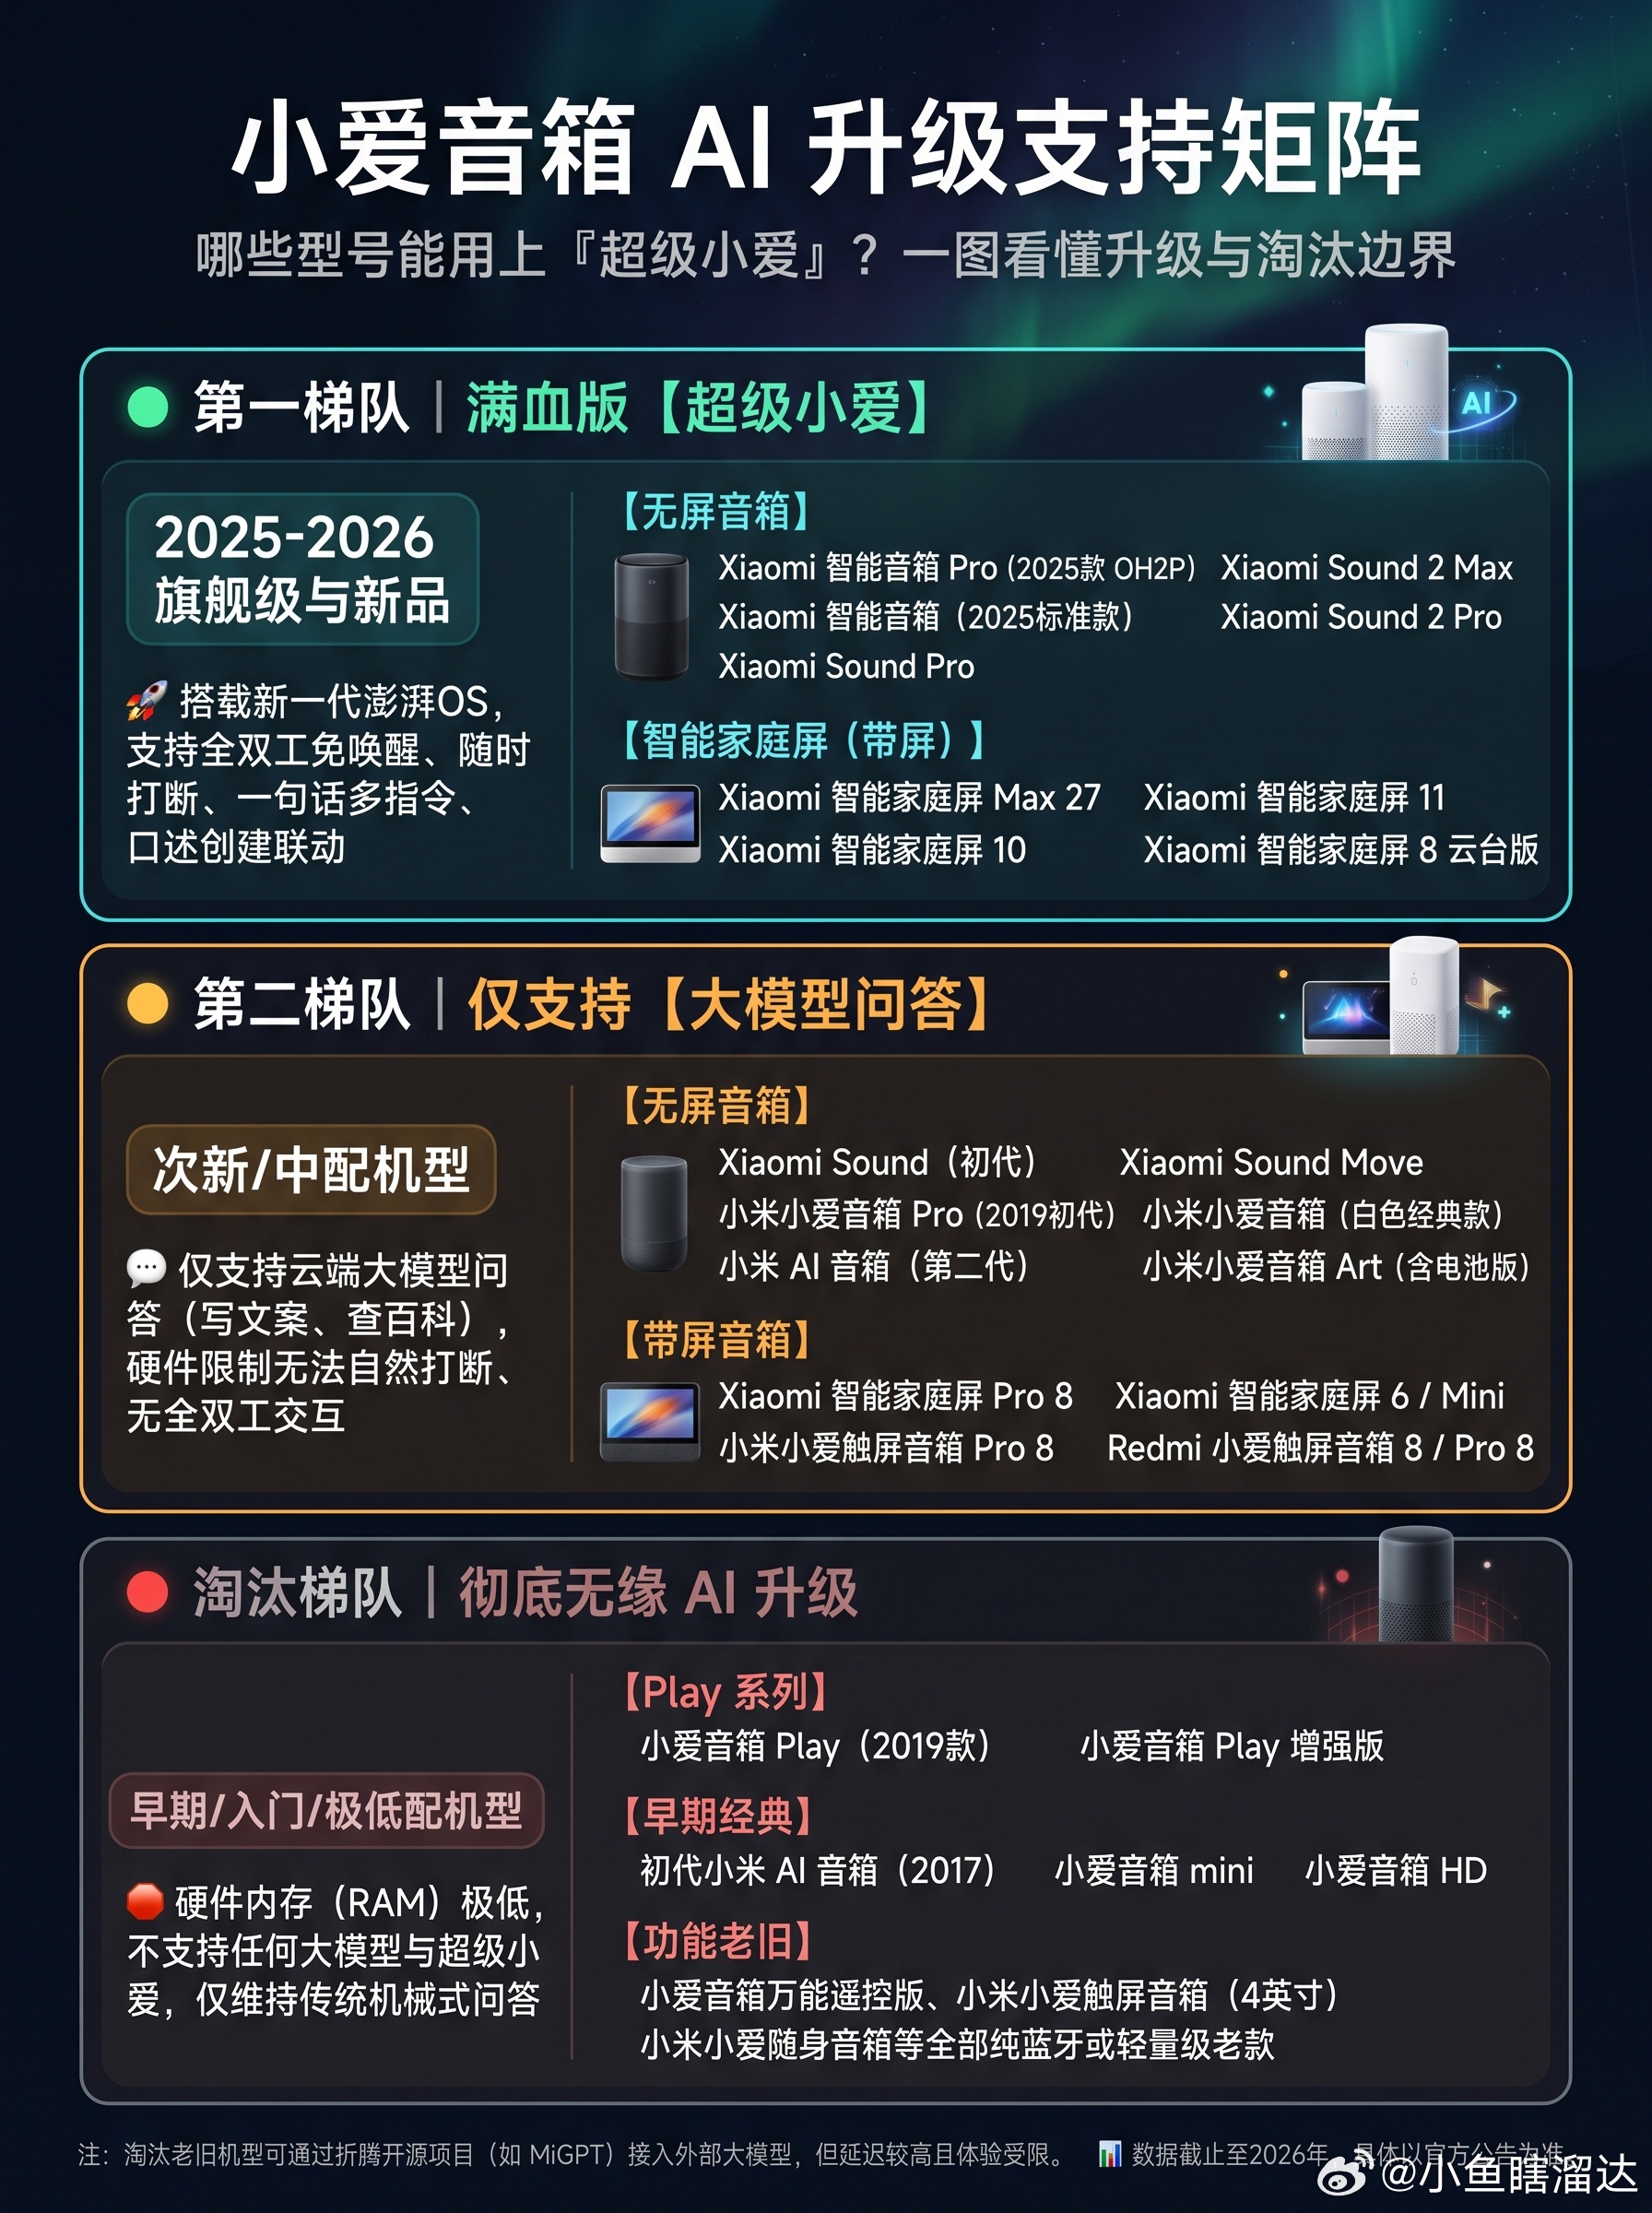
所以目前小爱音箱其实已经形成三档。
2025—2026年的新款智能音箱Pro、Sound 2系列以及新的家庭屏,属于“满血版超级小爱”,能够体验完整的流式对话、打断和新IoT能力。
再早一些的Sound、老款Pro、AI音箱二代、Art等,可以获得基础“大模型小爱”,问答能力升级了,但交互框架还是老一代。
至于初代小米AI音箱、小爱mini、Play系列等更早产品,基本已经停留在传统语音助手阶段。
当然,从技术上说,让老音箱“回答大模型”并非完全做不到。
现在已经有MiGPT、xiaogpt之类的开源方案,通过监听对话、调用外部大模型再把结果播回来。问题是延迟往往三五秒,不能自然打断,也很难获得原生的跨设备控制体验。
所以这件事最后还是要分清两件事。
“能不能接大模型”和“能不能做好AI音箱”,完全不是一回事。
过去智能音箱拼的是麦克风、扬声器和价格。
大模型时代以后,它开始变成一个真正的AI终端。
这也意味着一个有点残酷的现实,AI正在重新定义硬件的寿命。
以前一台音箱只要喇叭不坏,可能能用十年。
现在硬件没坏,但因为内存、芯片、操作系统跟不上新的AI交互方式,它可能已经提前进入上一代了。