深夜,两条消息几乎同时弹出来,AI算力两大顶尖玩家有了新故事
不是财报,不是模型,而是AI算力竞赛两个最核心的玩家,同时扔出了改变游戏规则的东西。
第一条,AMD推出Helion开放式机架级AI架构。 支持最高32768个CPU核心的纯CPU机架,面向超大规模智能体部署;以及整合EPYC CPU、Instinct MI350P GPU和通用计算的混合机架,面向企业级应用。基于OCP开放规范,11月推出。
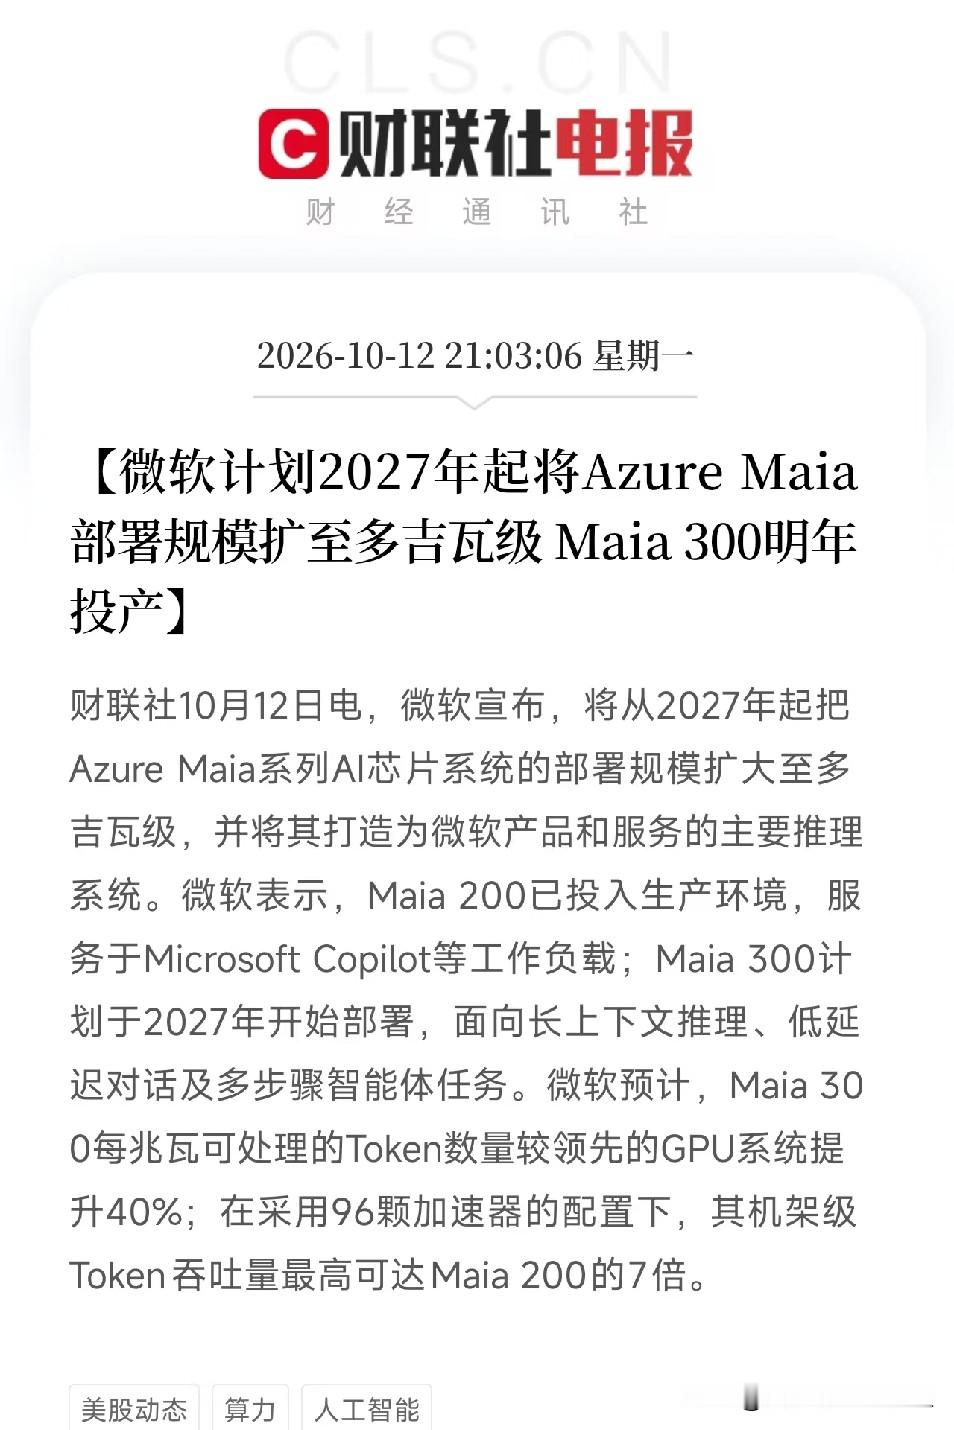
第二条,微软宣布Maia 300明年投产,并从2027年起把Azure Maia部署规模扩至多吉瓦级。 关键数据:每兆瓦可处理的Token数量,较领先GPU系统提升40%。96颗加速器配置下,机架级Token吞吐量最高可达Maia 200的7倍。
算力竞赛的重心,正在从谁的芯片更强,切换到谁能用最少的电,产出最多的Token。
这把火,烧穿了当前AI算力竞赛底层的那根逻辑。我们反复拆解,从英伟达DGX SPARK把千亿模型塞进桌面,到微软说未来两三年算力供不应求、要扩至多吉瓦级,到中信证券说高利率在AI投资周期拐点前是常态。所有的碎片,今天被这两条消息拼成了一个完整的图景:AI算力正在从买GPU,转向自建系统;从追求峰值性能,转向追求单位能耗的Token产出。
而这两条消息里,藏着两个比较关键的信号。
第一个信号,是AMD的纯CPU机架。 32768个CPU核心,全部用来跑智能体。这说明,在智能体时代,CPU的编排和调度价值正在被重新发现。过去大家只盯着GPU的浮点算力,但智能体需要的是多任务协同、工具调用、数据流动——这些恰恰是CPU的强项。AMD用EPYC去卡这个位置,跟之前英伟达Vera CPU专为代理工作负载设计,是同一个逻辑:AI竞赛的下半场,CPU不是配角,是智能体的交通警察。
第二个信号,是微软的每兆瓦Token提升40%。 这个指标太狠了,它量化了每度电能产出多少AI。当高利率成为常态、当电力成为AI数据中心最大的瓶颈,谁能用同样的电费产出更多的Token,谁就能在成本上碾压对手。微软敢把Maia 300推到多吉瓦级部署,说明它在“Token能效”上,已经找到了比通用GPU更优的路径。这跟Meta从每笔交易中抽成、Kimi做金融解决方案、DeepSeek开源Harness,是完全一致的逻辑:AI商业化的核心,正在从算力规模,切换到算力效率。
而这两条消息背后,是同一个物理底座的需求。不管是AMD的Helion,还是微软的Maia 300,它们都需要更高速的光互连、更高效的液冷散热、更稳定的电源管理、更高密度的PCB。谁在给这些Token工厂供核心硬件,谁就吃到了这轮系统级AI竞赛的大红利。
掏心窝子的话放这儿。别再只盯着英伟达的GPU参数了。AI算力的竞争,正在从单芯片跑分,切换到系统级Token产出效率。
去翻一翻,谁在给这些机架级架构供光模块和光互连,谁在做液冷和电源管理,谁又在高阶PCB和先进封装上卡住了位置。那才是这场Token能效革命里,真正被产业趋势托着走的卖水人。
AI算力行情