微软终于不装了,直接把刀砍向了老黄的利润率。
微软官方下了一道硬指令:从明年开始,自研的Maia系列芯片将启动吉瓦(GW)级的大规模部署,正式接管微软自家所有产品和服务的AI推理大权。
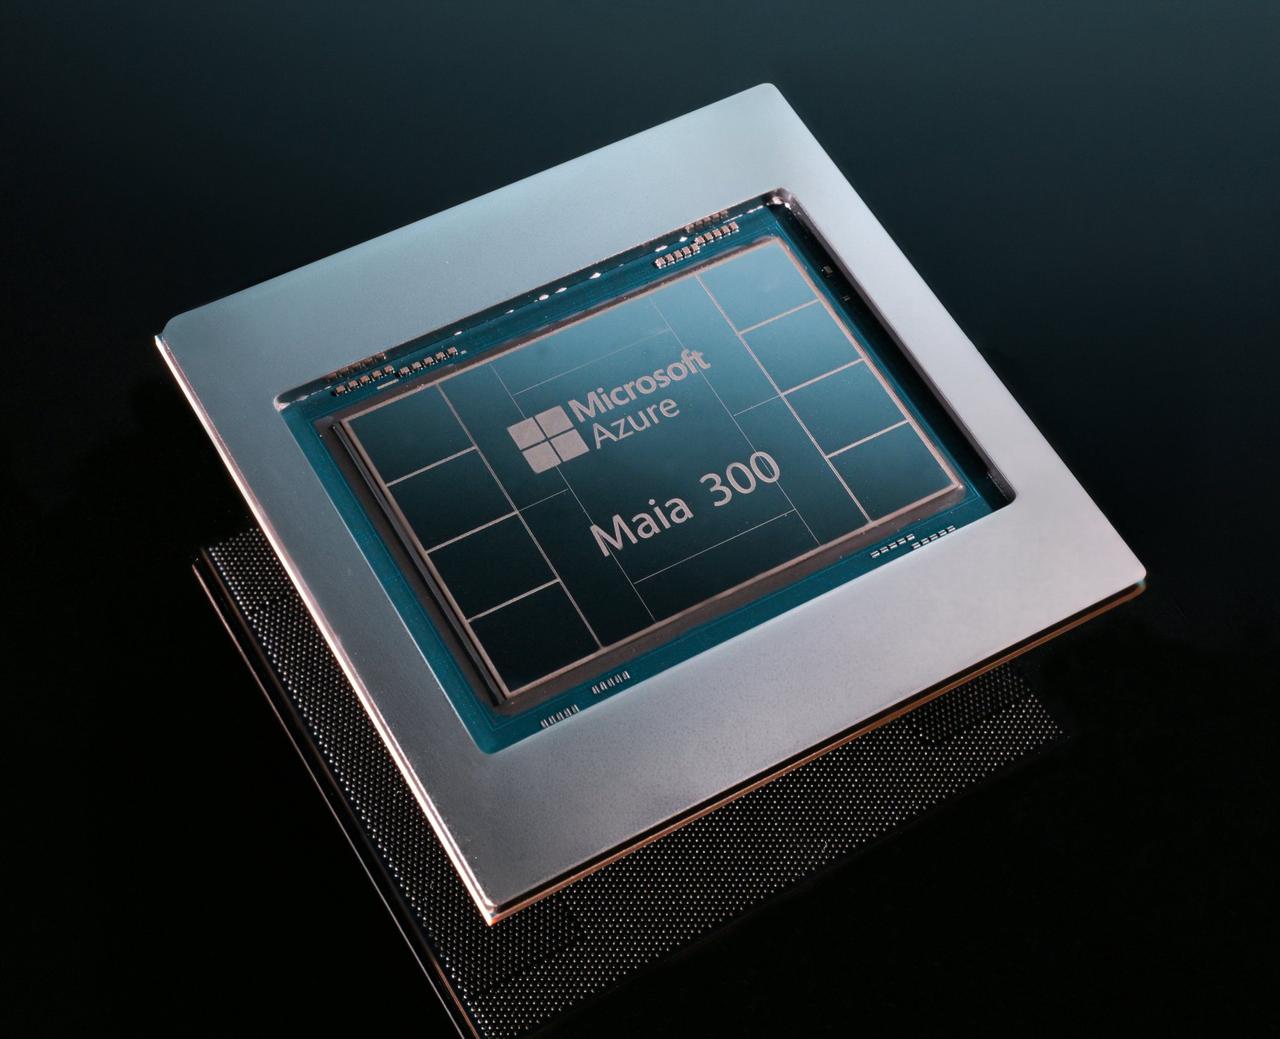
这次亮相的微软Azure Maia 300芯片,玩的正是精细算账的招式。
根据官方公布的数据,Maia 300每瓦特能产出的Token数量,比目前主流的GPU系统整整高出了40%。而早已暗度陈仓部署在美洲、欧洲和澳洲的Maia 200,在Teams和Copilot的实际体验中,能效比提升更是高达1.7倍。
这背后的算力逻辑非常清晰:
大模型打到下半场,拼的根本不是谁能砸钱训练出更大的模型,而是谁能以更低的电费把模型跑起来。
模型训练是一次性买卖,贵也就贵那几个月;但每天几亿人在Copilot里改PPT、在Teams里总结会议,这种高频、长尾的AI推理,每一秒钟都在狂刷数据中心的电费账单。
所以微软这次开口闭口都是“每瓦特Token数”和“吉瓦级部署”。当AI的竞争演变为“电力与能效”的博弈时,光靠堆通用GPU的暴能打法显然难以为继。用专用的自研ASIC芯片做推理,既能免去给英伟达缴纳高昂的硬件溢价,又能把数据中心变电站的每一度电挤干吃净。
当然,微软也没打算跟英伟达彻底撕破脸,底层训练依然离不开黄老板的顶配显卡。但把日常最消耗电能的推理业务拿回自己手里,无疑是给所有云巨头发出了最现实的示范:地主家也没有余粮,高昂的生态过路费,能少交一点是一点。
当硅谷巨头们纷纷从“买显卡”转向“造芯片+抢电厂”,算力霸权的外衣正在被一步步剥开。真正的算力自由,从来不是看你手里握着多少张昂贵的显卡,而是看你能不能把电网送进来的每一瓦特电,都精准转化成屏幕上的每一个Token。