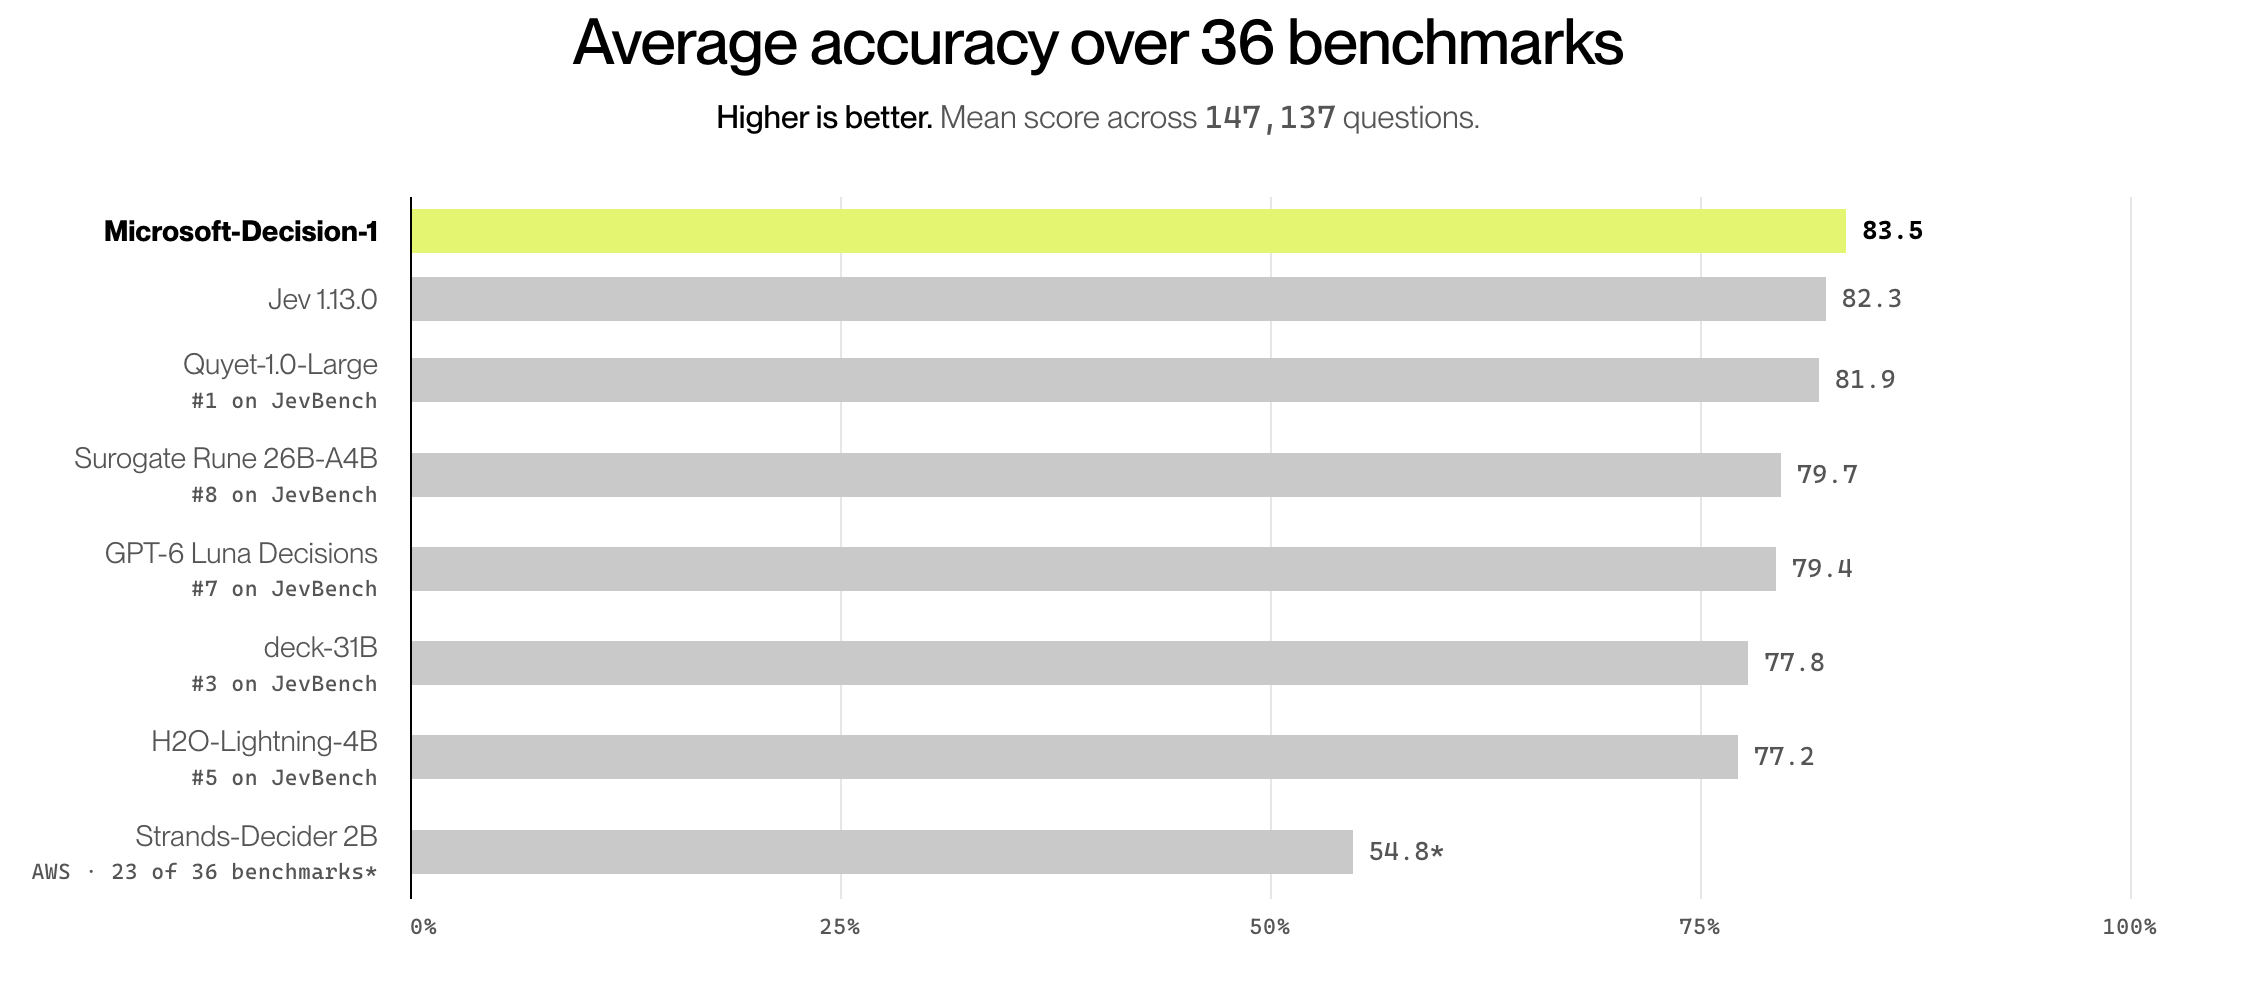
微软 Decision-1 上线:只做选择题,输出不要钱
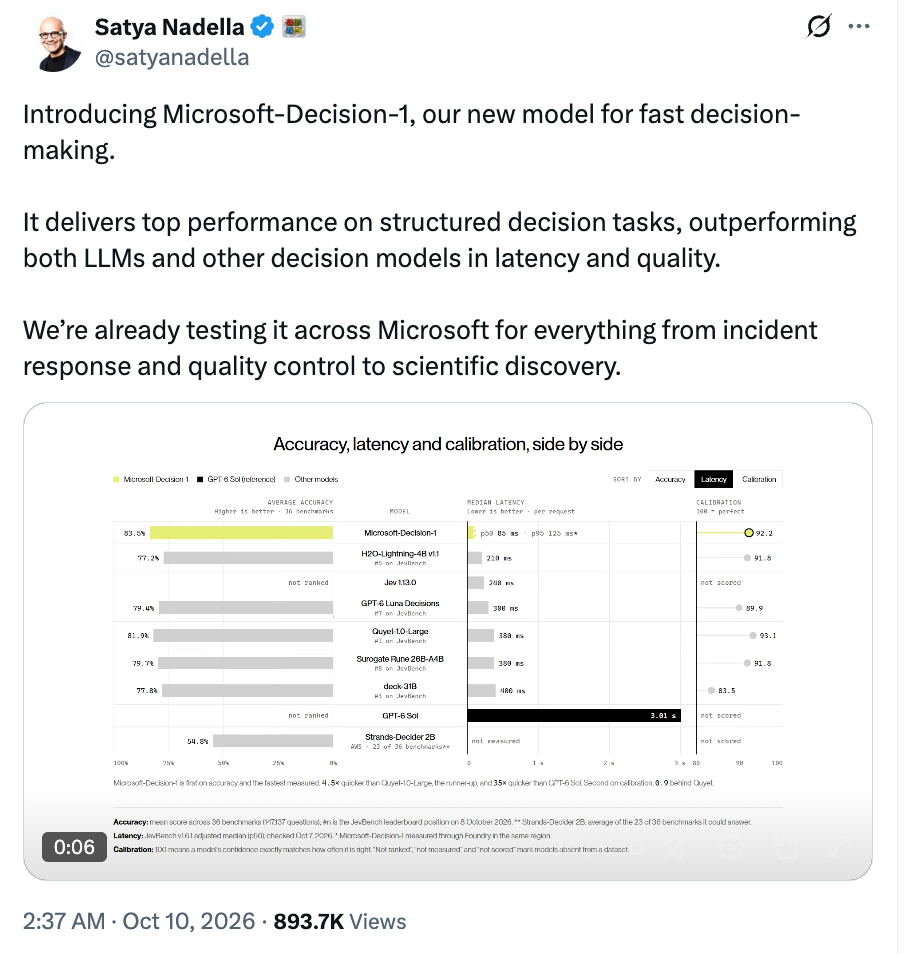
当地时间 10 月 9 日,微软上线 Microsoft-Decision-1,Foundry 与 OpenRouter 同时开。纳德拉在 X 上宣布,官方博客由微软 OTC 副总裁 Achint Srivastava 署名。
它不做对话,也不写代码。给它一组固定选项,它只返回每个选项的概率分:是/否、多选、评分,以及按 rubric 给 AI 回复和 Agent 动作打分。不接受图片音频视频,也不做开放式问答。
基座是后训练过的 Qwen3.5-9B(阿里开放权重),微软说后续会迁到 MAI 和 OpenAI 的模型上。
价格是最扎眼的地方:每百万输入 token 0.042 美元,输出不要钱。上下文 33K,OpenRouter 上由 Azure 托管,P50 延迟 0.23 秒;它走的是 Decisions API,不兼容 chat 接口,现有的 chat SDK 调不通。
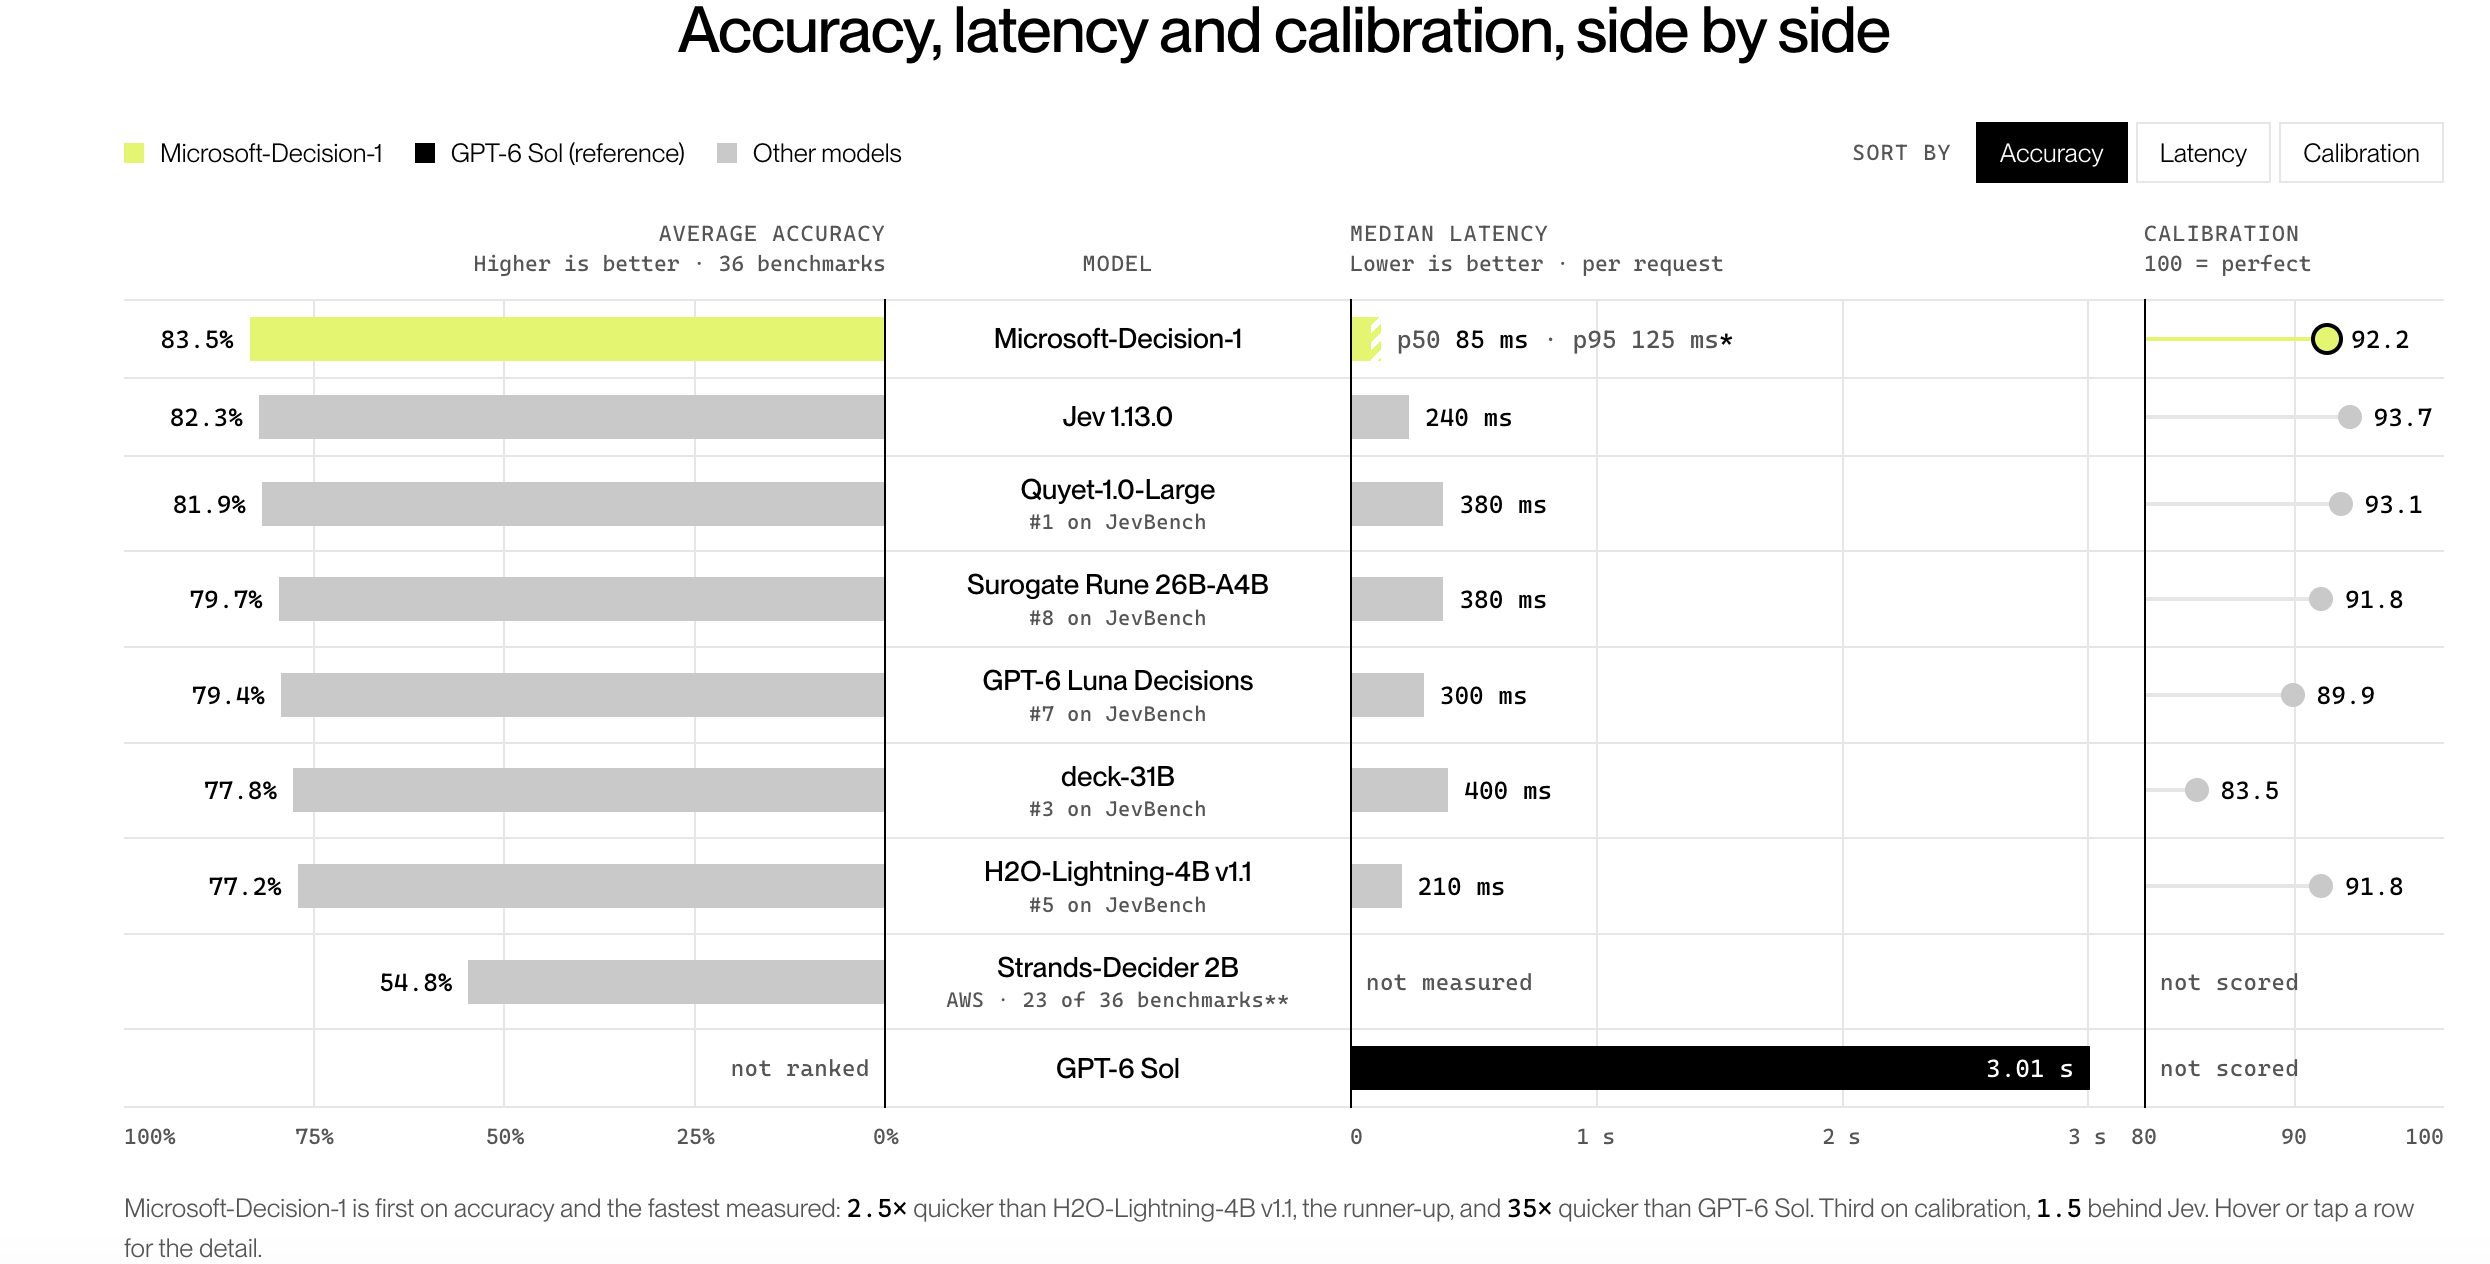
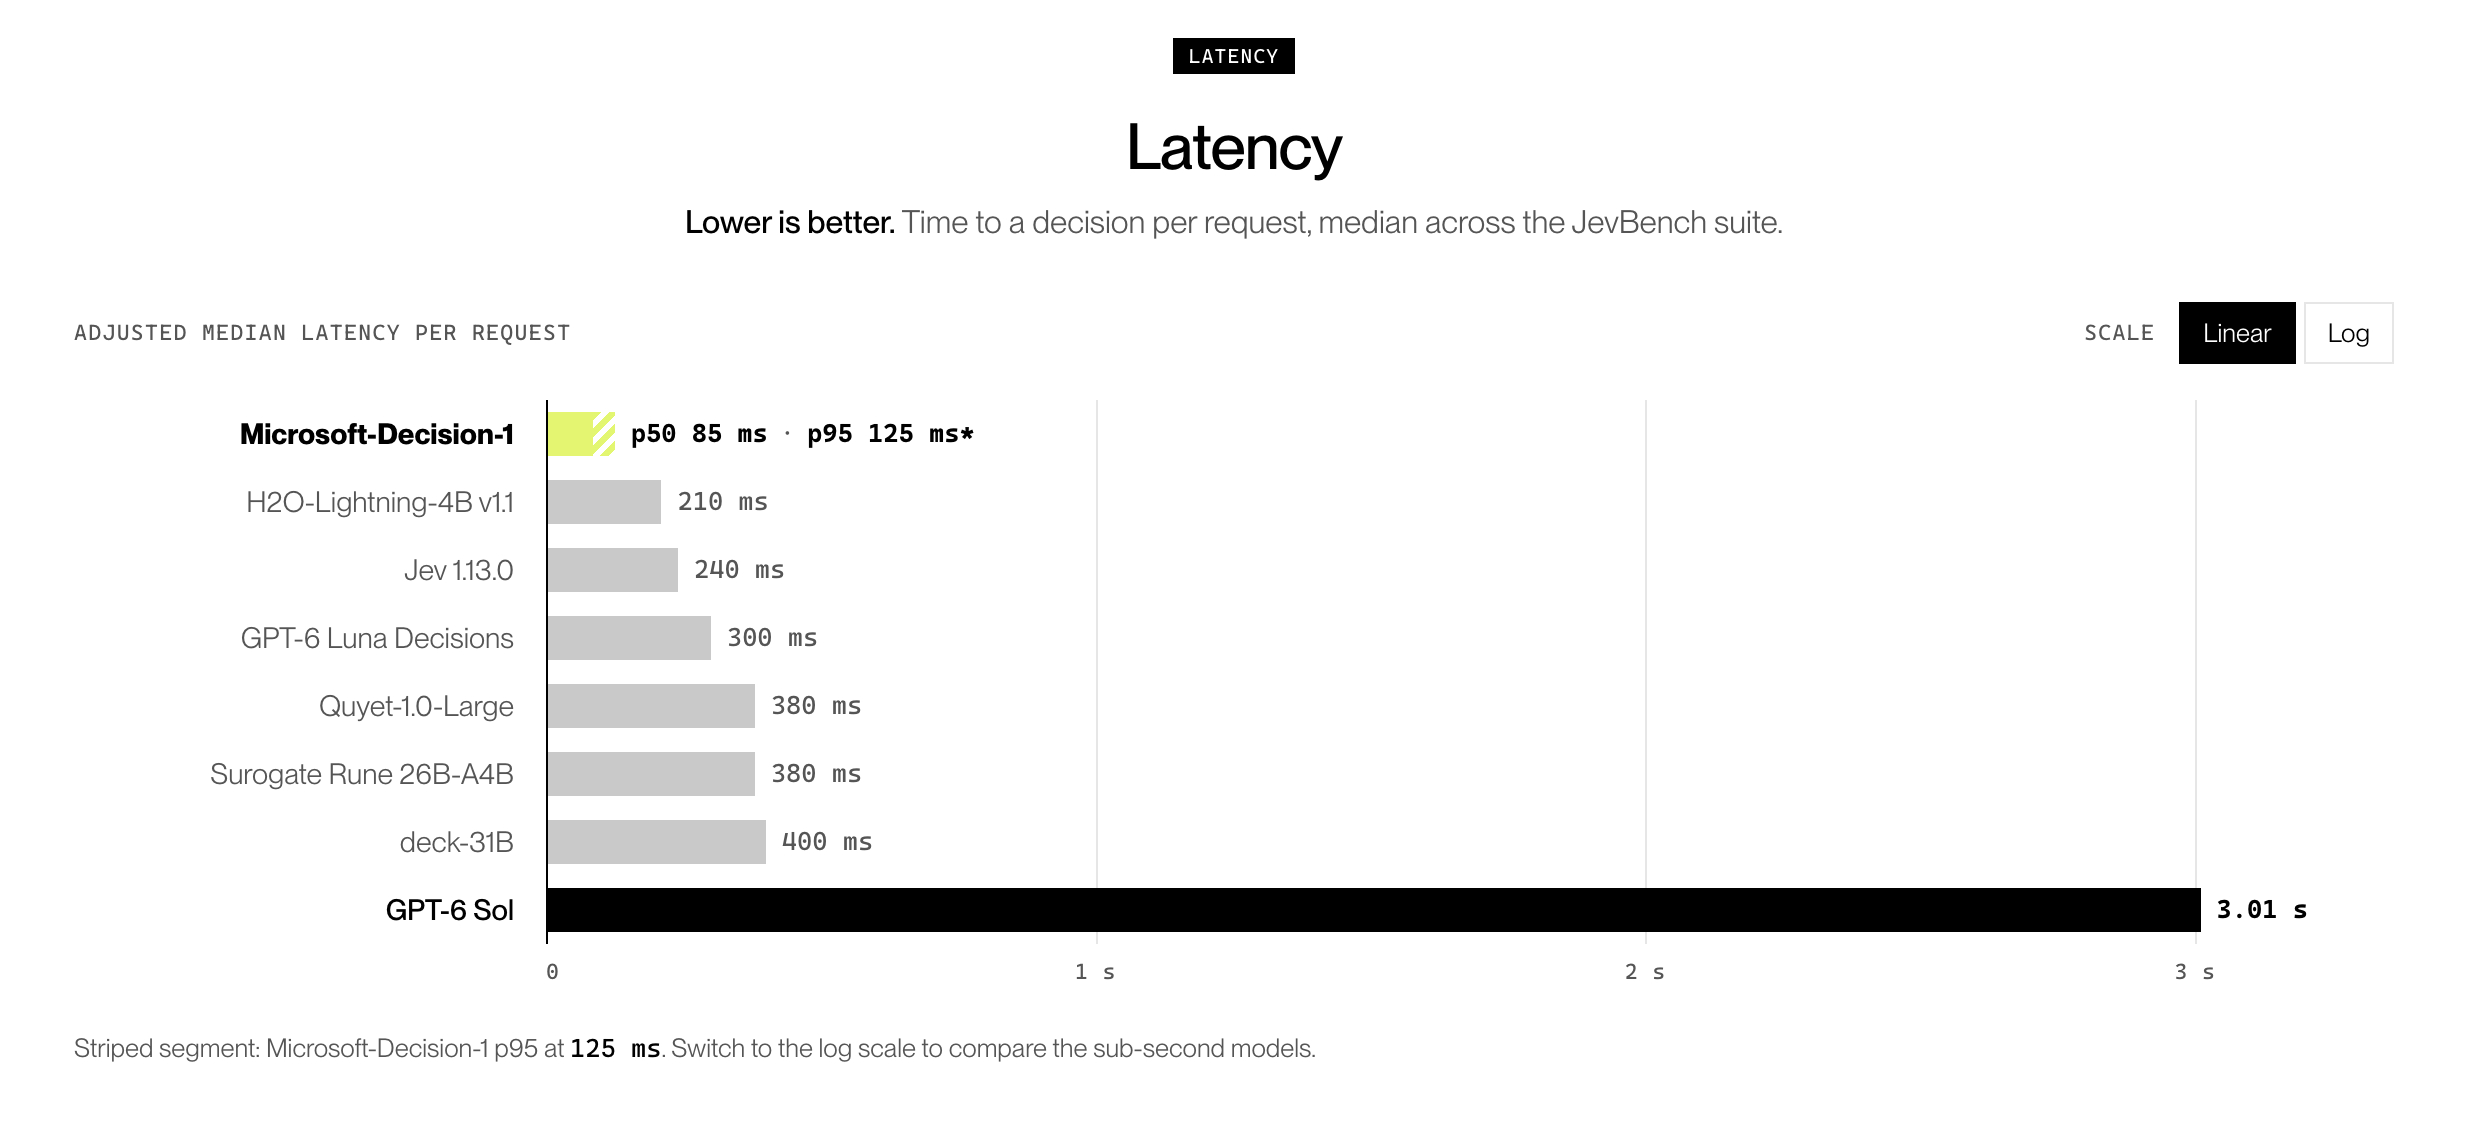
微软把账算在延迟上:多步 Agent 里每步多 100 毫秒,20 步就多两秒;它的 P50 比 GPT-6 Sol 快 35 倍,比第二名 Quyet-1.0-Large 快 4.5 倍。
比"准确率第一"更值得看的是它抖得少。官方做扰动测试:同一个请求换八种改法,改措辞、改选项描述、颠倒或打乱顺序,决策平均只有 1.3% 会翻盘;选项描述改写和顺序变化时,零翻转。
概率是 API 的一部分,不是排序分,90% 就该十次里对九次。能挂到生产上的其实就是这个。
内部用例的数字比 36 项基准实在。Xbox 研究部给一万多条玩家反馈分主题,微软说质量与 GPT-6 Sol 相当、快 14 倍以上、便宜 200 倍;Copilot 团队用它给会话和 Agent 回复做质检,与 GPT-5.6 Luna 相当、快 100 倍;值班工程师用它做知识检索;Microsoft Discovery 的自适应重规划里,打分一致性是 LLM 的 46 倍。
"最高准确率"来自微软自己的 36 项基准、近 15 万道盲测题,没有第三方复现;官方附录列的对比模型是 Quyet-1.0-Large、Surogate Rune 26B-A4B 等,基本是小模型和专用决策模型,不是各家旗舰。
上线第一天,OpenRouter 流量榜上排第二的是个巴西的招聘候选人分析应用,1.91M tokens。
Foundry 页面上却写着:不能把它当作就业、信贷、住房、保险、教育、医疗、法律权利这类重大决定的唯一依据,也不能用于监控或个人画像。
边界在哪儿,市场会先替你试一遍。