过去一年,AI行业有个很明显的变化,大模型发布不再只盯着参数和榜单,落地能力还有性价比的权重越来越高。厂商们都在提自己的模型能干活,但真到了工程环境里,能不能稳定交付,往往比宣传文案更有说服力。
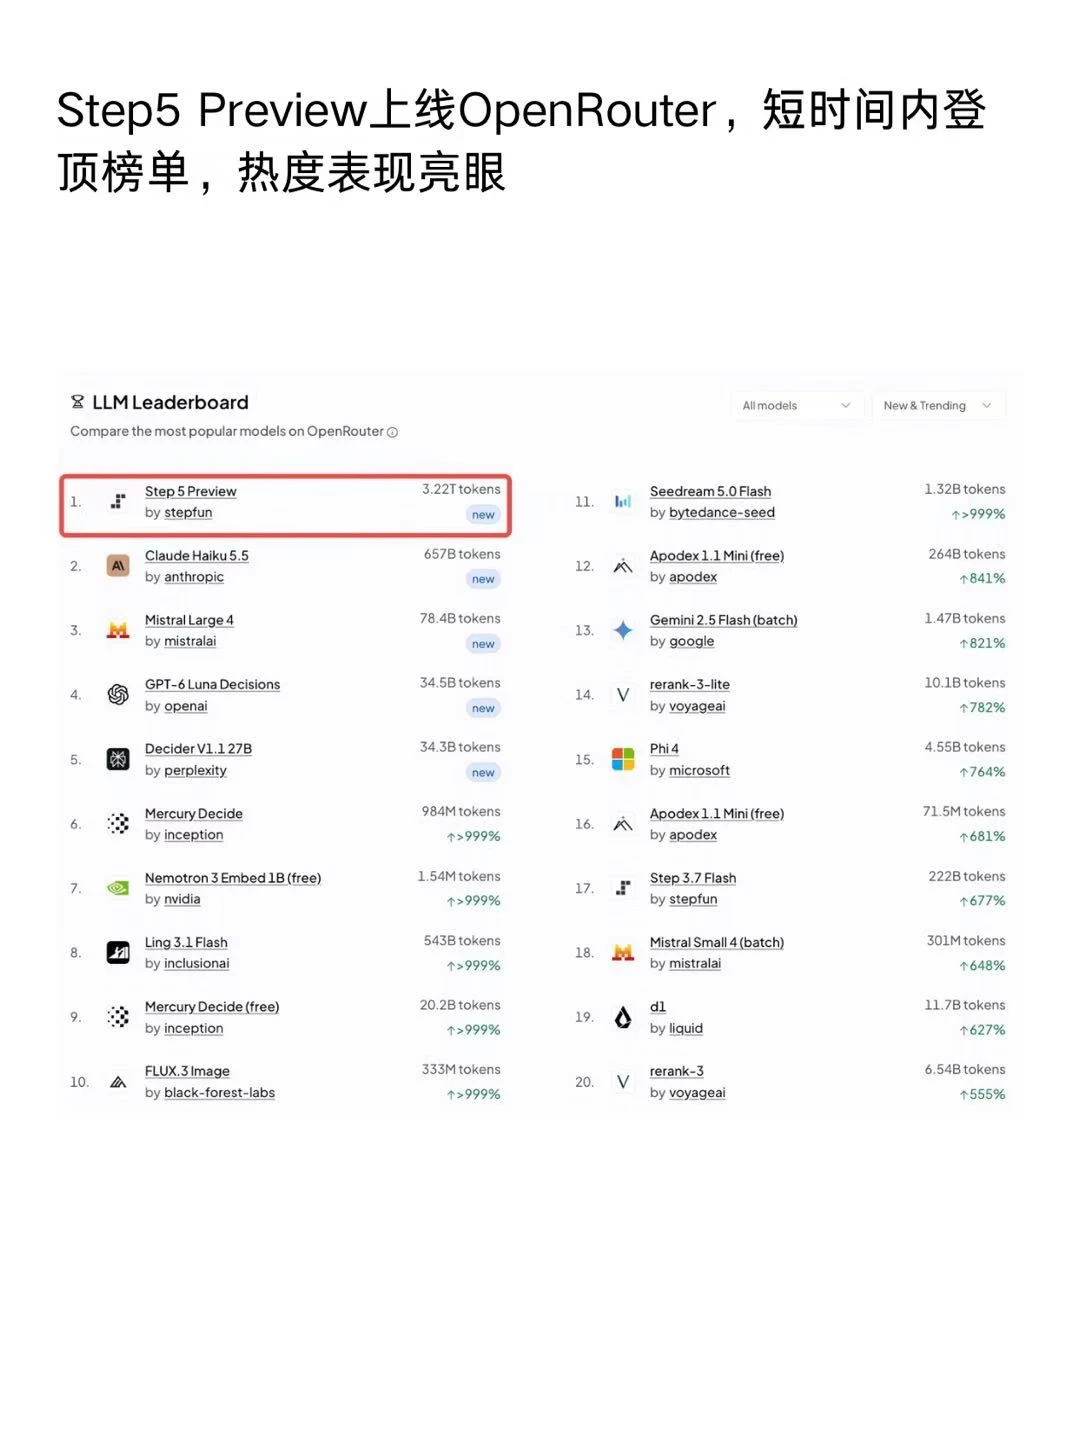
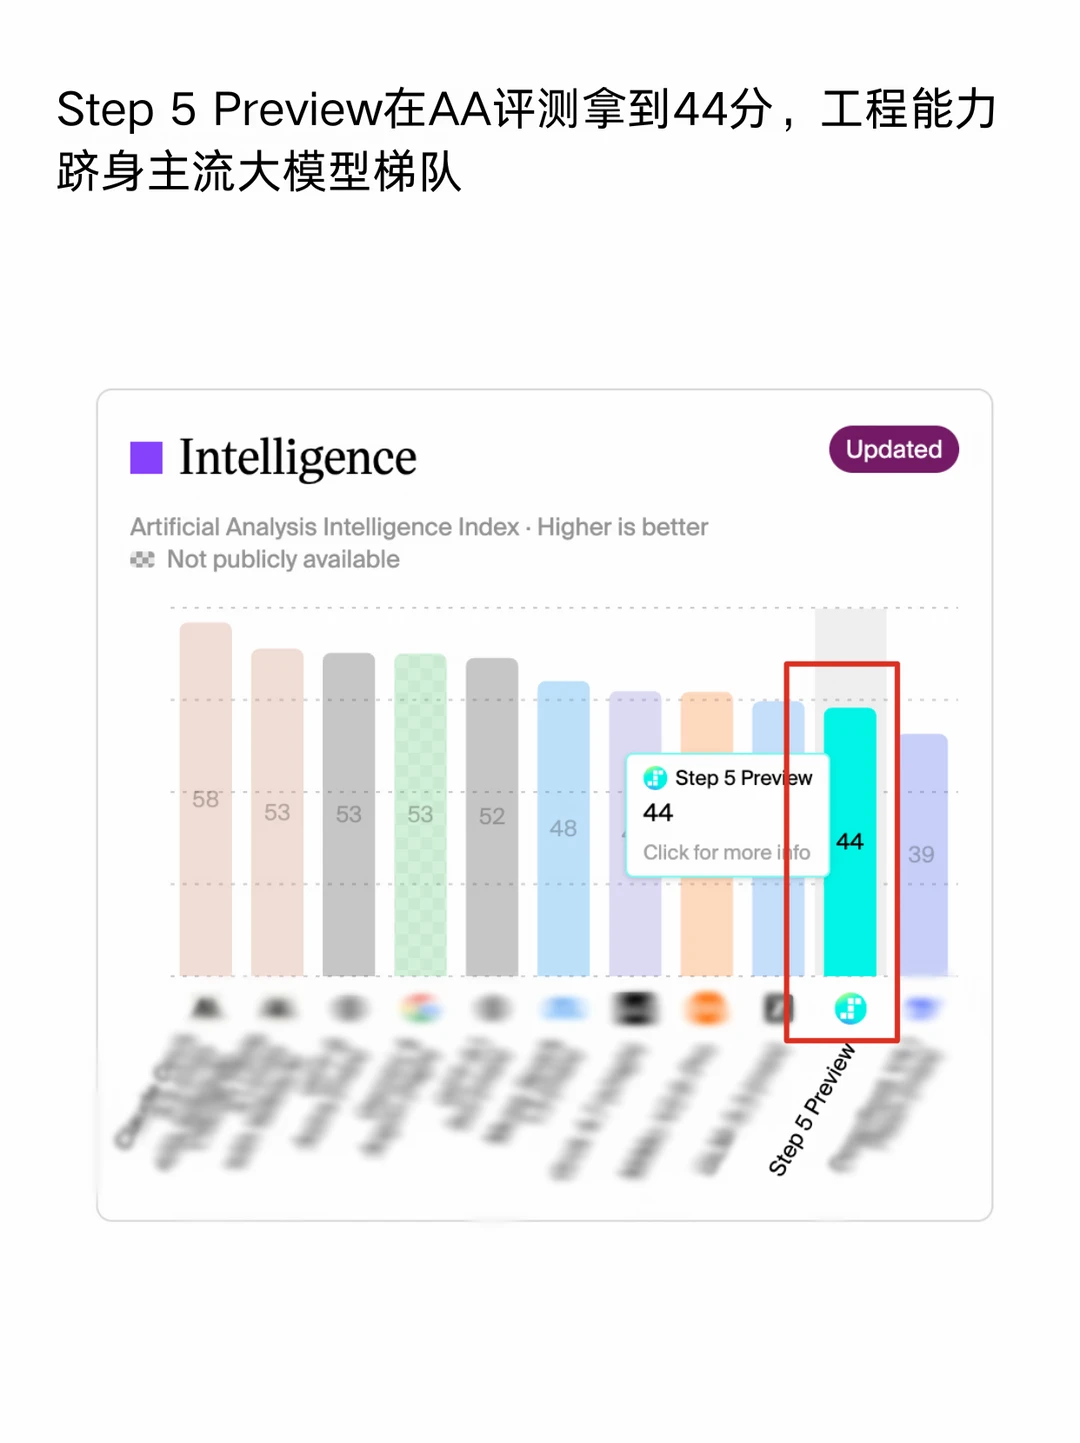
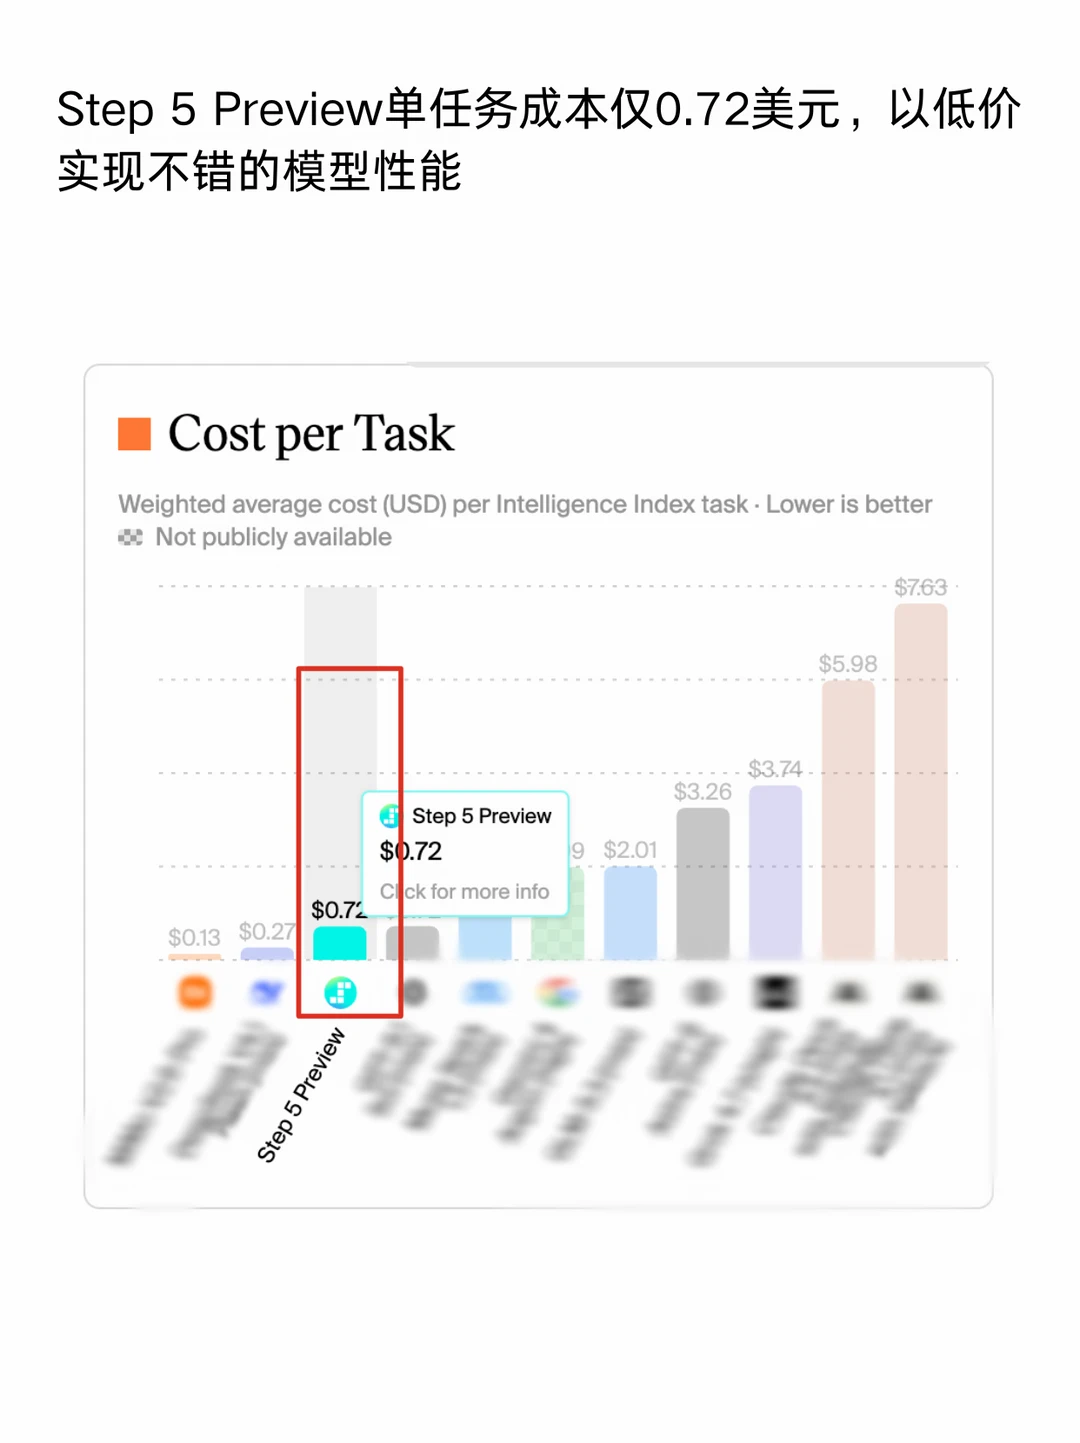
最近阶跃的Step 5 Preview讨论度挺高,它在AA榜单上拿了44分,价格却只有Opus的1/8,纸面数据确实亮眼。而且10月8号上线OpenRouter后,12小时内就登顶了Trending榜单第一,这热度确实能说明些问题。但判断一个模型的工程实力,光看跑分远远不够,得丢到真实任务里跑一遍。
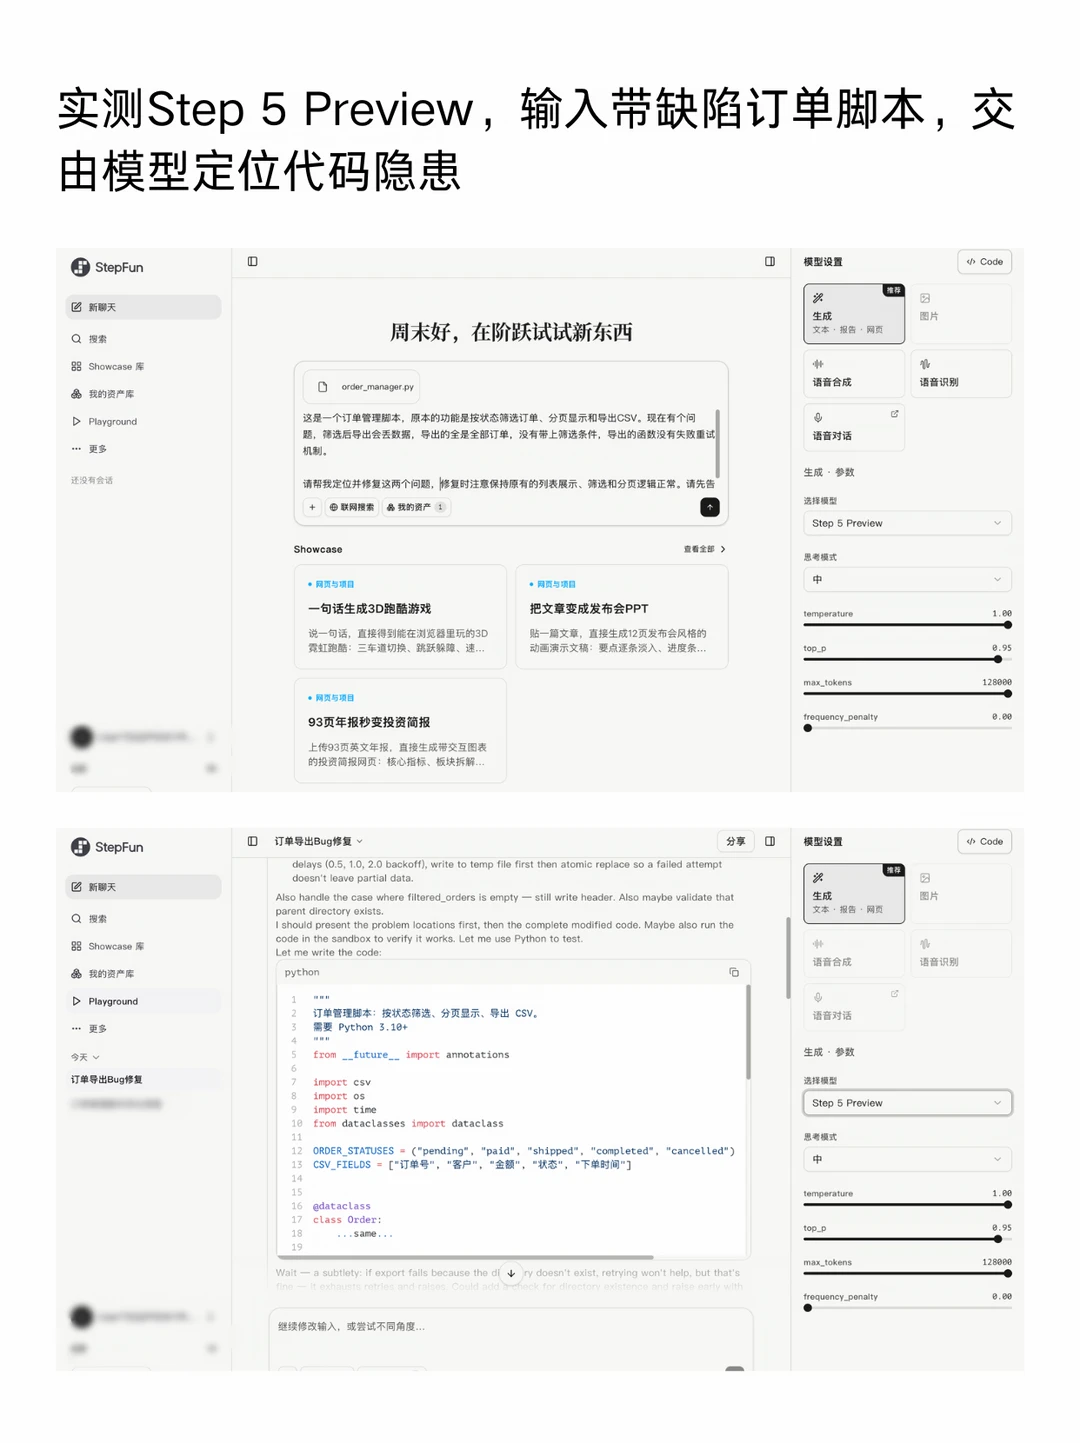
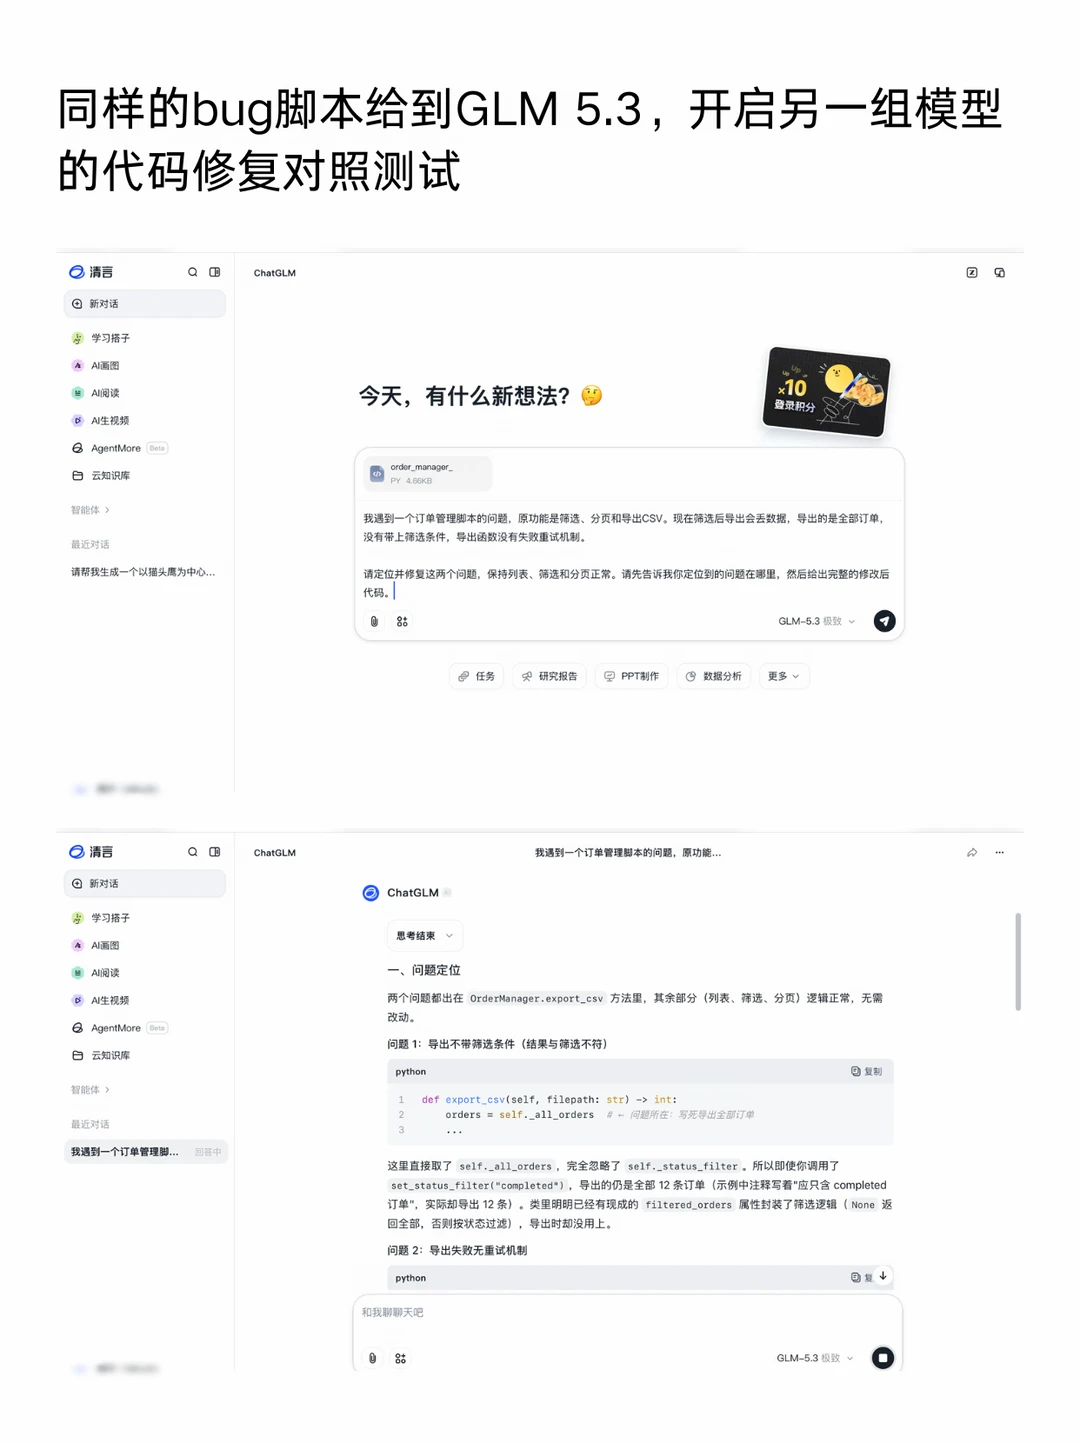
我准备了一段带Bug的订单脚本,功能是筛选、分页和导出,代码里埋了一个坑,导出时没带筛选条件,还没做失败重试。同样的任务和提示词,我分别在阶跃的StepFun官网和智谱清言上,发给了Step 5 Preview和GLM 5.3。
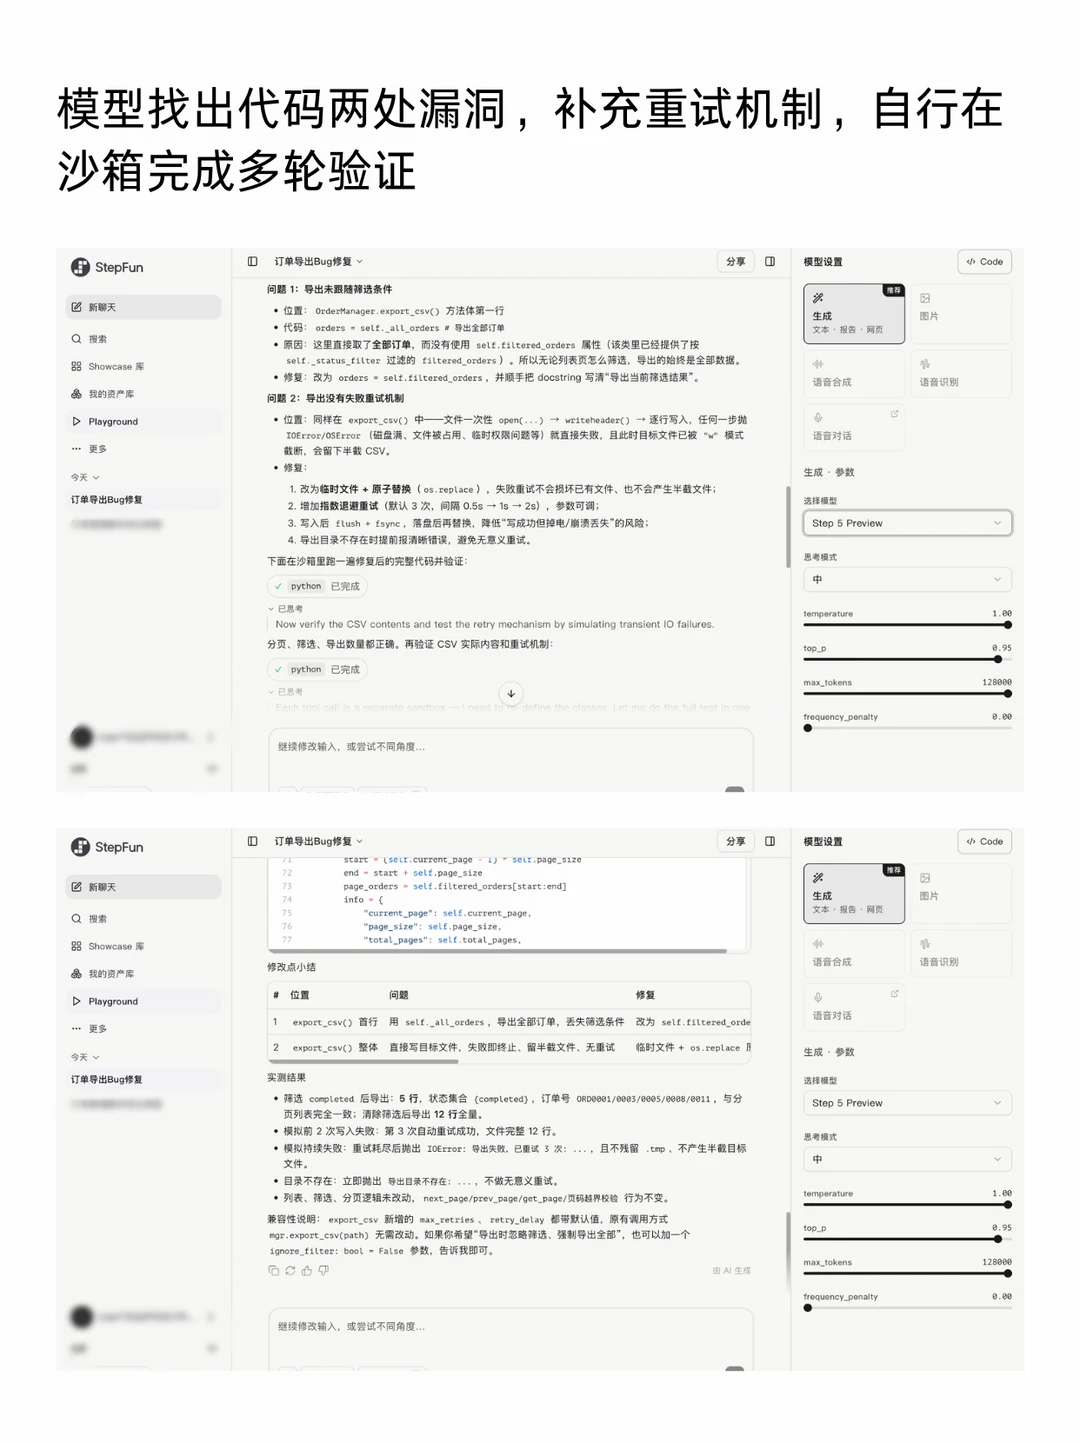
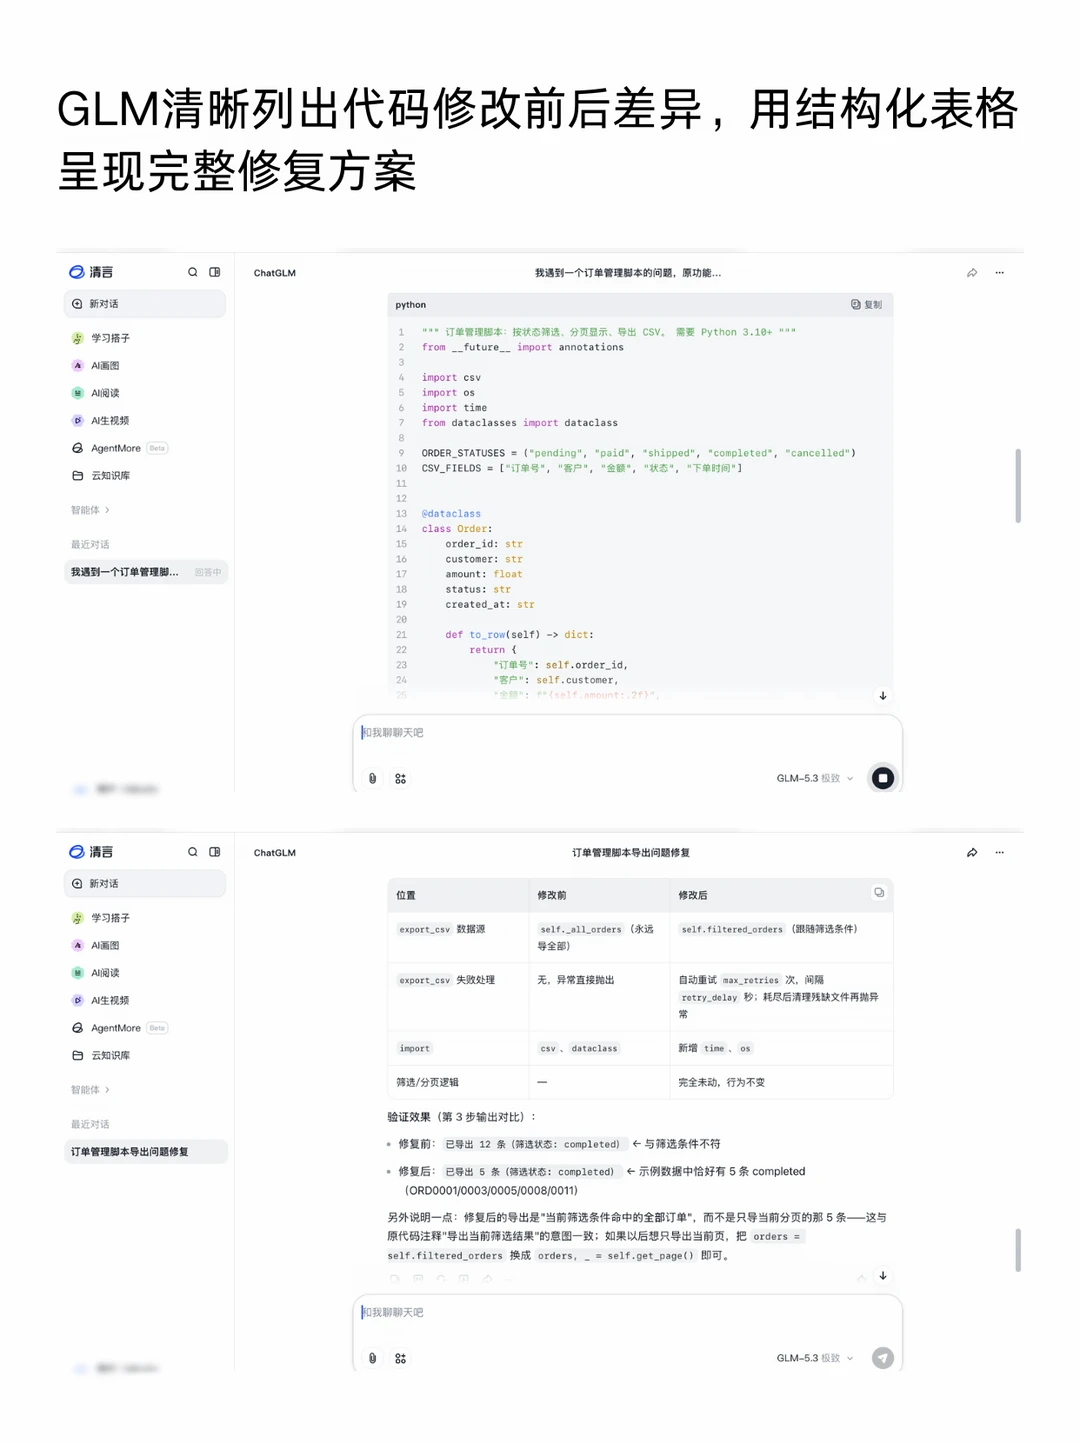
Step 5 Preview的表现挺稳,第一轮就揪出了数据源写死这个错误,还顺着工程逻辑,主动加上了临时文件保护和指数退避重试。最让我意外的是,它在给出代码前,自己在沙箱里跑了一遍验证,把分页、筛选和导出行数都测通了,甚至还模拟了前两次写入失败来测试重试效果,最后才交卷。GLM 5.3这边也相当靠谱,同样一眼看穿了问题,定位准确,重试逻辑也写得很清晰。它更偏向给出结构化的对比表格,把修改前后的变化列得清清楚楚,整个交付过程很有条理。
双方的基础修复都过关了,风格差异挺明显。GLM像一份严谨的工程师报告,有数据有验证,Step 5 Preview更像一个经验丰富的老手,不光帮你把Bug修好,还顺手把工程上的隐患都堵上,并自己跑通了验收。
把视角拉开,这种差异其实映射出了当前Agent赛道的竞争焦点。过去大家比的是模型回答问题有多聪明,现在真刀真枪拼的,是交付工程任务时的细致度和可靠性。当这种能力下探到1/8的价格,对中小团队来说,把AI塞进日常研发流程的顾虑就小多了,工具的价值正在从聊天的对象,转向真正能落地的生产工具。
放在真实的研发流程里,Step 5 Preview这种自己先跑通再交卷的习惯,确实能省下不少复核的精力,价格门槛也低了不少。不过工具好不好用,每个团队的实际需求不一样,自己上手跑一跑,哪个用着顺手就选哪个,比听别人说再多都管用。
#AI #Step5Preview #GLM #大模型评测 #Agent #stepfun