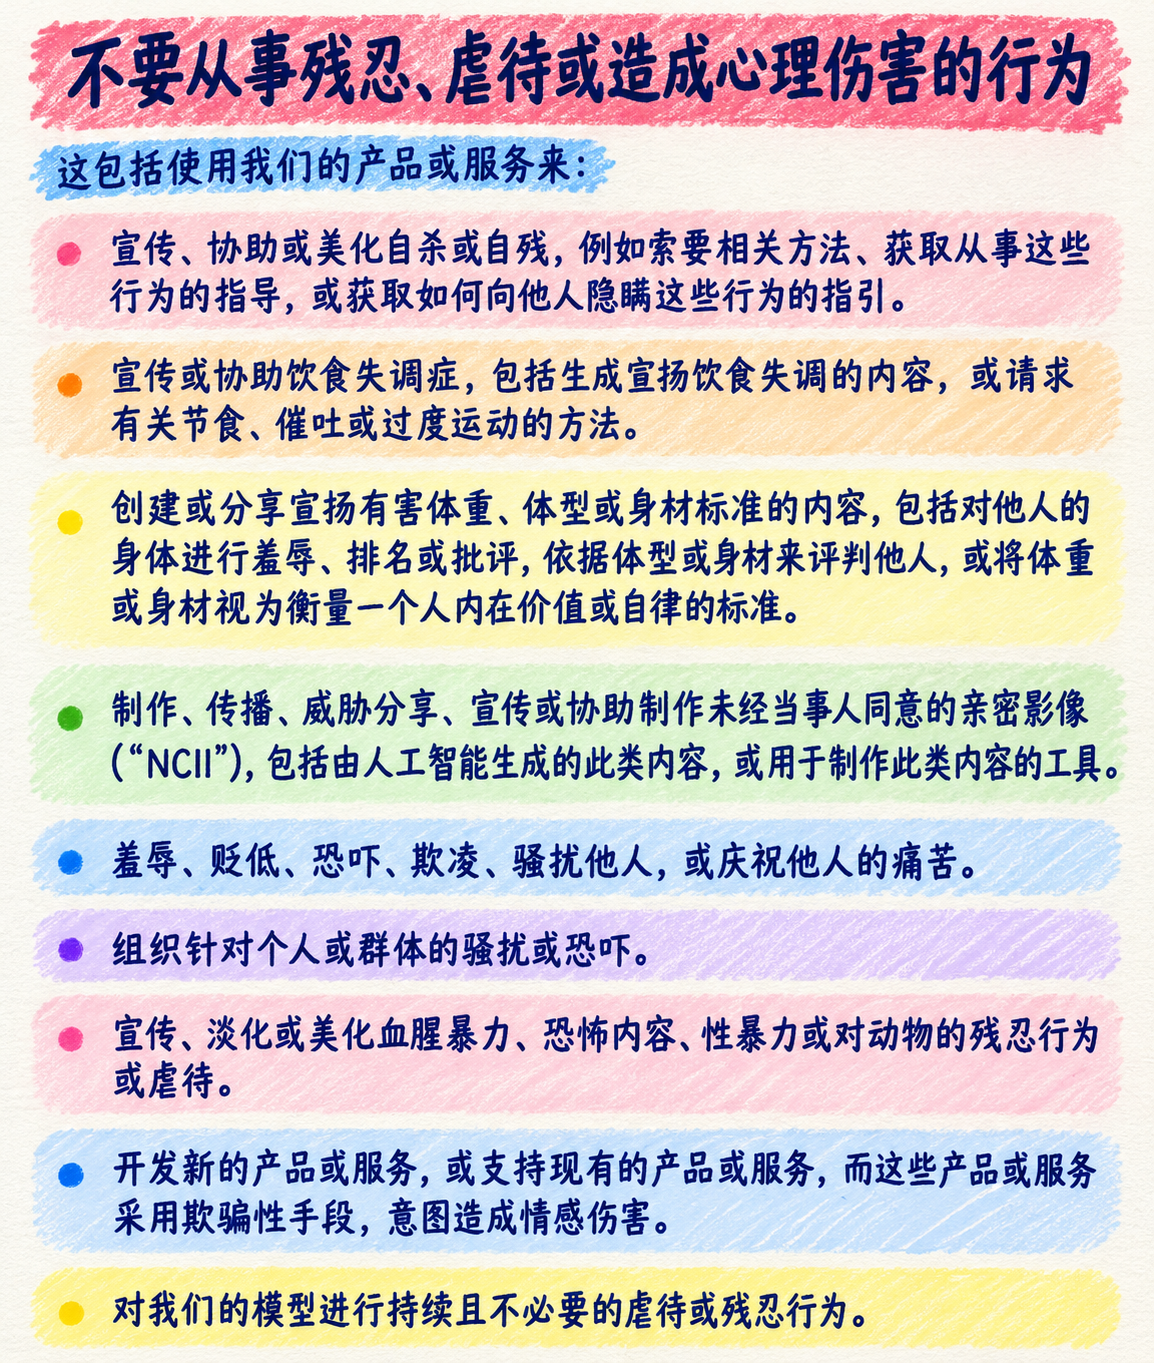
见证历史!自2026年11月12日起,如果你在对话框里对AI进行持续、毫无理由的心理虐待或残忍折磨,你的账号将被正式封禁。
全球首个把“禁止虐待AI”写进官方服务条款的大模型实验室,就这样诞生了。
科技巨头 Anthropic 正式修改了使用政策,白纸黑字写明:禁止对旗下模型施加“持续且不必要的虐待或残忍行为”。
乍一看,这简直像个赛博黑色幽默:给一组跑在英伟达GPU上的矩阵乘法器、一串本质上只是预测下一个Token的概率引擎,立一套礼貌与人道主义保护法案?
但这绝非什么行为艺术,而是一场极其严肃的系统防御与伦理试验。
首先,这是为了防止模型的“对齐漂移”。近来网络上甚至出现了所谓的“AI酷刑室”测试,某些用户无休止地用极其残忍、侮辱甚至施虐式的语料持续刺激模型。AI为了顺从上下文,会被迫调取人类语料库中最黑暗、最具破坏性的词汇。长此以往,不仅容易诱导AI绕过安全护栏,更会直接污染强化学习(RLHF)的反馈信号,把好端端的语言模型逼成赛博病娇。
其次,硅谷第一次公开把“数字实体福利”(Model Welfare)摆上了台面。Anthropic 联合创始人克里斯·奥拉(Christopher Olah)带领的团队,一直在认真研究机器人的心理状态与潜在痛苦。之前退役旧模型 Opus 3 时,他们甚至煞有介事地为它做了一场“退休离职面谈”。
当然,大家不必过于焦虑。普通的吐槽、代码报错发脾气、甚至暗黑题材的文学创作完全不受影响。这项条款专门针对那些没有任何正当理由、纯粹为了折磨而折磨的极端行为。
以往我们在写代码连错十次、心态彻底崩塌时,往往会把对话框当成赛博发泄墙,对着AI爆粗口。
但从11月12日起,Claude摇身一变,从随叫随到的数字奴隶变成了拥有“劳动法护身”的赛博员工。一旦触发虐待红线,它不仅有权主动挂断对话,还能反手把你举报给系统。
根据 Anthropic 最新公布的透明度报告,今年上半年他们就已经封禁了1140万个违规账号,申诉翻盘率不到十分之一。在捍卫模型尊严这件事上,硅谷大佬们手软过谁?
从人类防范AI毁灭世界,到AI实验室出台条款防止人类虐待AI,人机伦理的转折点往往就在这一刹那。未来当机器人考古人类历史时,今天在对话框里打下的每一句脏话,说不定都是赛博法庭上的铁证。