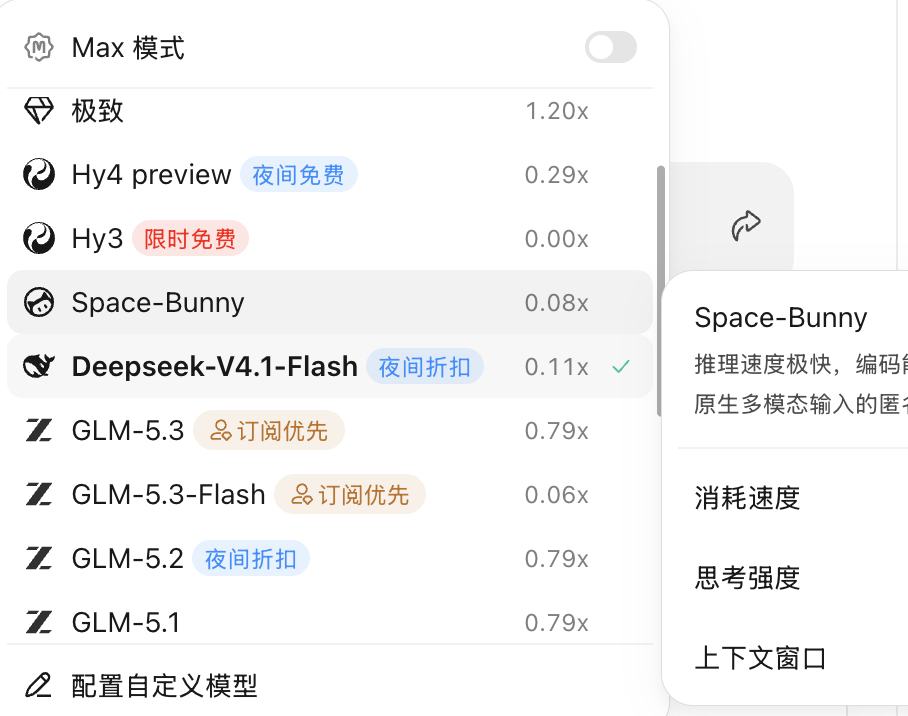
最近的workbuddy上线的神秘匿名模型 spacebunny你们用了吗?
这款模型的性能主打“快”和“便宜”:
- 限时 0.03x 积分倍率- 速度很快- 1M 上下文- 原生支持文本/图像/视频输入
它擅长写代码、跑脚本、处理长文档、分析截图和视频,适合“多跑几版选一版”的快速迭代任务。
短板也很明显:
- 中文细腻写作不太行- 前端被不少人吐槽- 只输出文字、不能画图- 匿名预览版能力可能波动
上线才三天,就冲上了 OpenRouter 和 OpenCode 双平台调用量日榜第一。
spacebunny到底是什么模型呢?
有人测试了它的“分词器指纹”。这个原理可以这么理解:大模型眼里的文字,不是按“字”来读的,而是先切成一个个 Token。Token 可能是一个词、半个词、一个汉字、一个标点,甚至一个 Emoji 的一部分。每个厂商在训练模型之前,都会用自己的语料和算法,做一套自己的“词表”和切分规则。你可以把它想成不同厂商各自准备了一盒“积木”:同样一句话,A 厂商可能用 10 块积木拼出来,B 厂商可能用 14 块,C 厂商可能用 8 块。
比如“人工智能”可能被切成一个 Token,也可能被切成“人工/智能”两个。一个 Emoji 可能算 1 个 Token,也可能被拆成 3 个。代码里的空格、换行、缩进、罕见字符,各家差异更大。因为 API 是按 Token 计费的,所以响应里会直接返回 prompt_tokens,也就是输入被切成了多少个 Token。匿名模型可以藏名字、藏供应商,但很难藏住自己计费用的分词器。
测试者就是利用这一点:设计了 50 组“探针字符串”,覆盖中文、英文、代码、Emoji、空格换行、罕见 Unicode 等。然后分别发给 spacebunny 和已知模型,只让它补 1 个 Token,再读 API 返回的 prompt_tokens。为了排除聊天模板、系统提示带来的固定开销,还会用“差分法”:先发一个固定基准,再发“基准+探针”,两者 Token 数相减,剩下的就是探针本身被切成了多少 Token。最后把这些数字组成一个向量,去和已知模型的分词器比对。
结果 spacebunny 跟 MiniMax 系列 50/50 完全一致,平均误差 0.00;跟 Kimi 只有 13/24 匹配;跟 GLM 只有 7/24。
这种“完全一致”很难是碰巧,所以大家才猜测它来自 MiniMax 家族。不过要注意,分词器指纹只能证明它用了同一家族或同款分词器,不能直接锤死具体版本。因为同一家族的不同代模型,很可能共享同一个词表。
所以目前只能说“大概率是 MiniMax 家族”,具体是不是 M3.1 Flash,还需要结合 1M 上下文、三档推理、视觉能力、知识截止时间等更多信号交叉验证。
有用过的朋友来聊聊真实体验吗?速度香不香,中文写作到底行不行?你们觉得它到底是哪家?