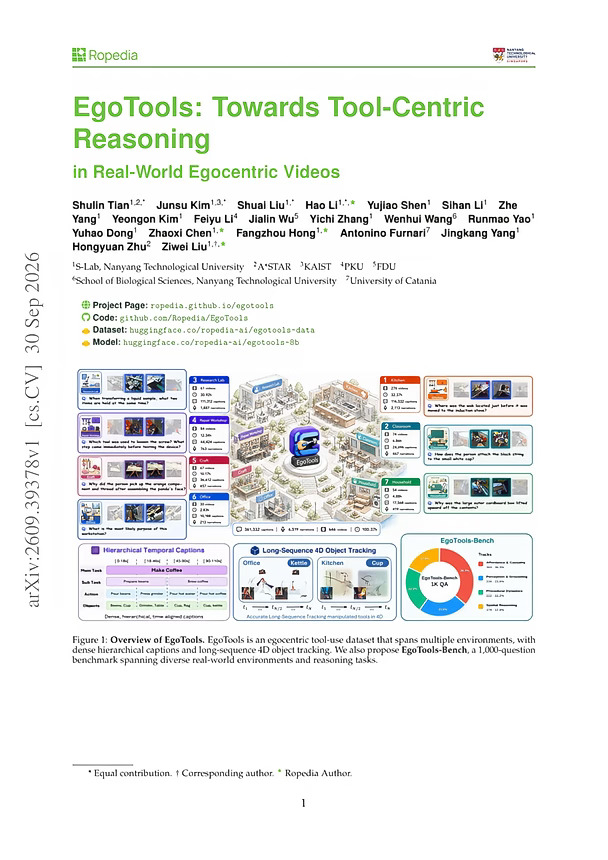
头戴视角的视频数据集一直有个老毛病:动作标的是“煎蛋”,手里那把锅铲、那口锅,标注里压根没出现。模型学了一堆“这人在干嘛”,至于拿的是什么、碰到哪儿、东西被弄成了什么样,没人教过。
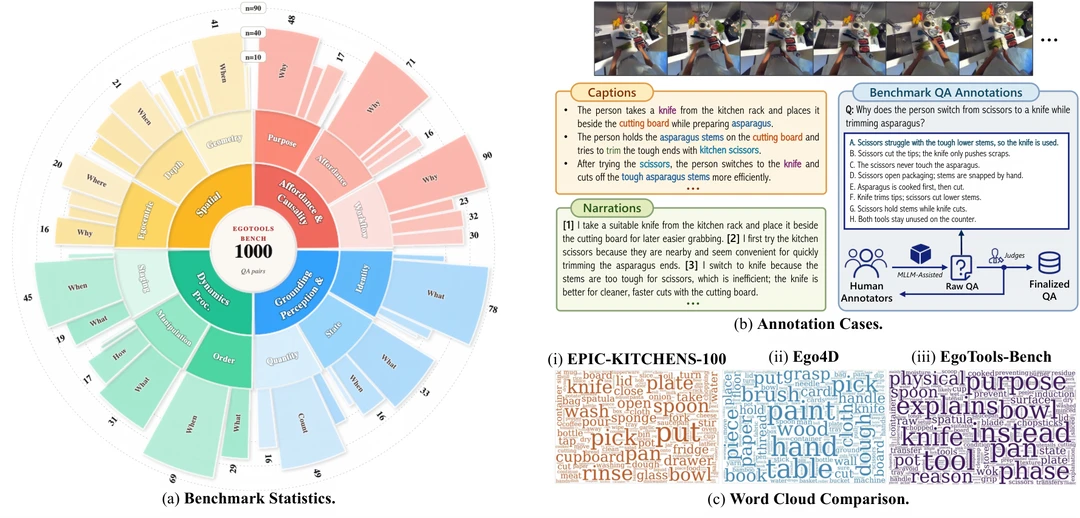
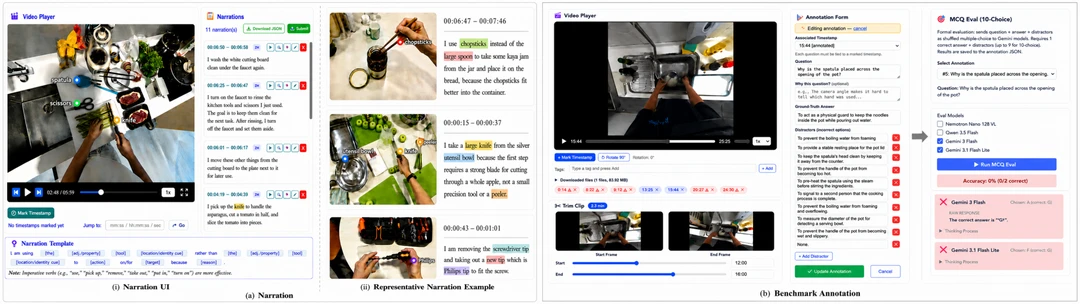
EgoTools 就是冲这个来的。100 小时头戴设备录的视频,厨房、实验室、修理间都有,切出 1000 道八选一的题,分四类,其中一类叫感知定位(PG)。
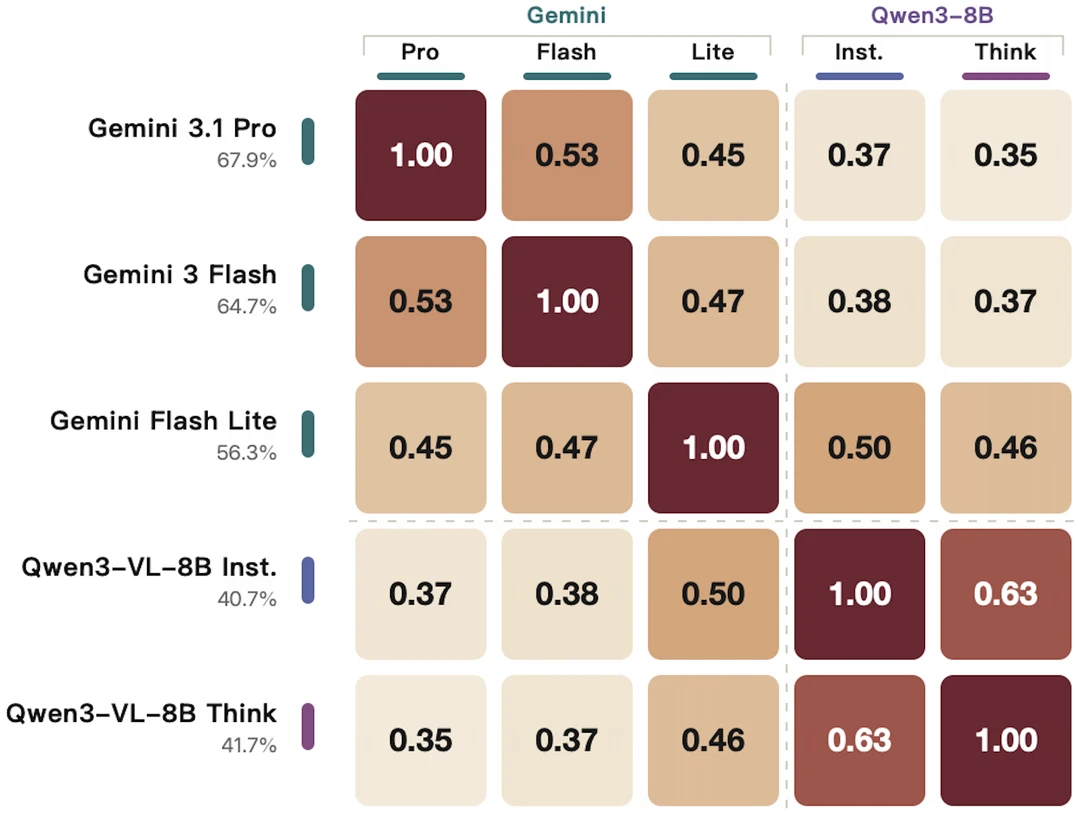
分数里先看 PG。Gemini-3.1-Pro 总分 66.9%,PG 只有 51.7%,比它自己另外三项低了 18 到 23 个点。PG 问的就是手上是哪把工具、碰的是哪个部位这种看画面就该知道的事,结果高层推理还能靠常识撑着,眼睛这关反倒过不去。还有个数让我起疑:Qwen3-VL-8B 只给文字能拿 42.7%,给 64 帧有序画面是 51.7%,随机猜才 12.5%,说明题面本身漏了不少答案,作者在文里也认了。
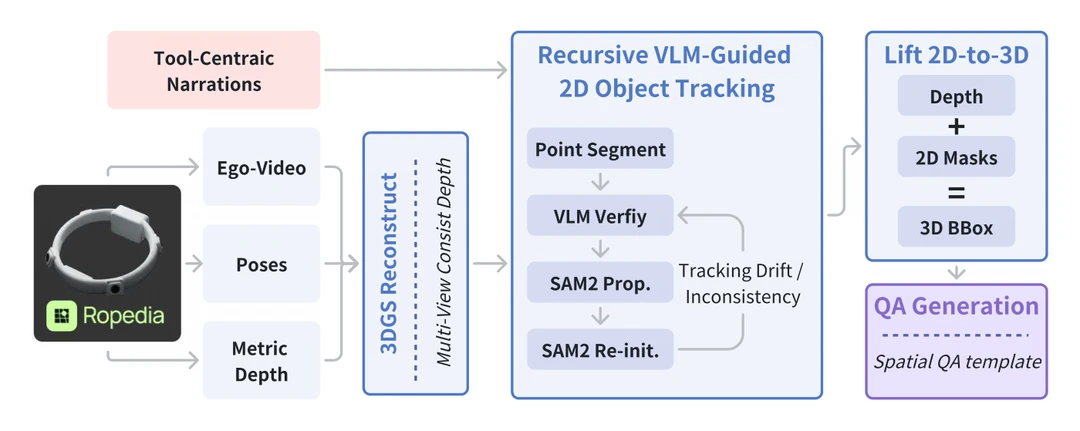
另一个细节在微调。拿 18 万条和评测视频不重叠的数据,对 Qwen3-VL-8B 的语言部分做全参 SFT,总分从 50.0 到 60.9,PG 涨了 13.8。可空间推理掉了 11 个点,训练集里明明塞了 1.79 万条空间题。作者给的解释是当前训练配方的局限,行吧。
论文:https://arxiv.org/pdf/2609.39378
代码:github.com/Ropedia/EgoTools
#人工智能 #大模型 #计算机视觉 #深度学习