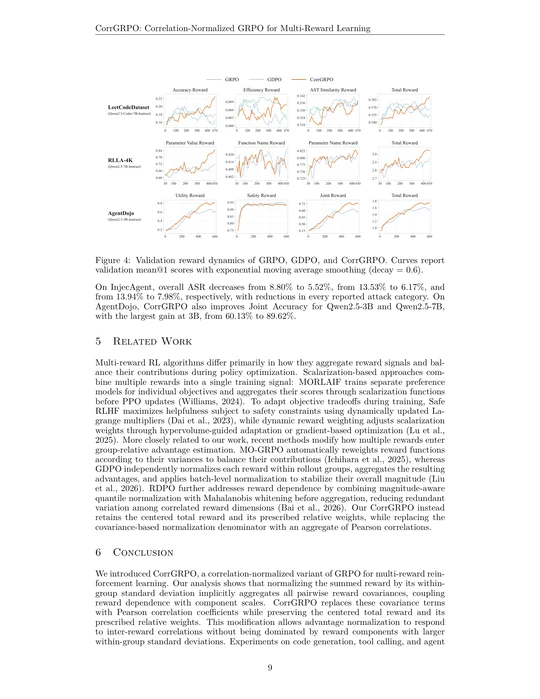
Qwen2.5-3B 在 AgentDojo 上,CorrGRPO 把 Joint Accuracy 从 GRPO 的 60.13% 拉到 89.62%。这个数我不太敢全信,测试里干净样例一共 21 条,干净任务完成率 95.24% 对 52.38%,其实就是 20 条对 11 条。
方法倒是挺干净的。
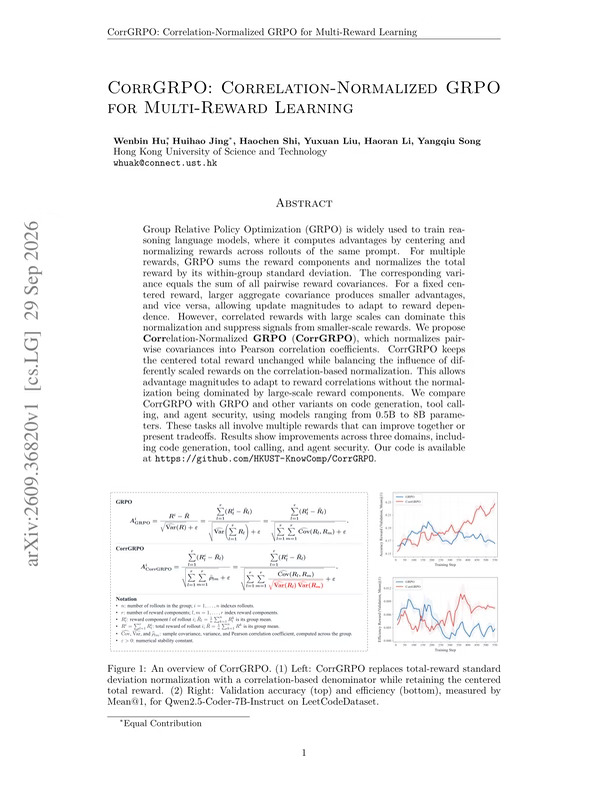
多个奖励加起来做 GRPO,组内方差展开就是所有奖励两两协方差之和,而协方差里乘着两边的标准差,数值范围大的奖励会占住分母。论文的小例子里,一个和别的奖励几乎不相关的奖励,光自身方差就占了总和的 91.1%。CorrGRPO 把分母换成 Pearson 相关系数之和,分子的加权总奖励不动,原来设好的权重照样生效。
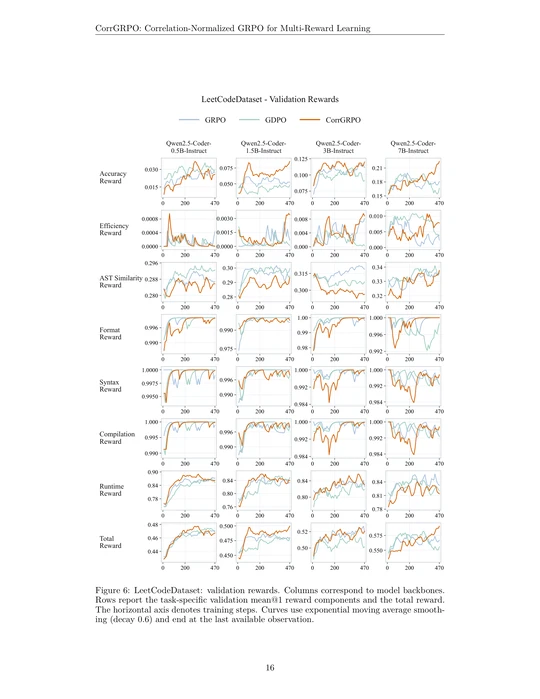
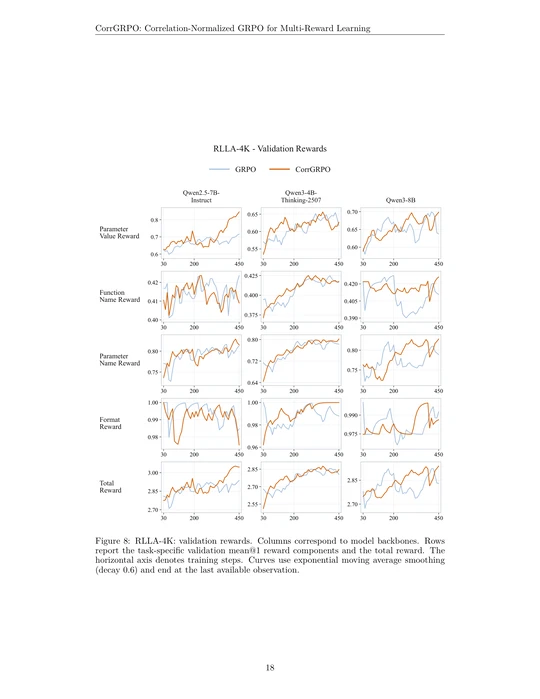
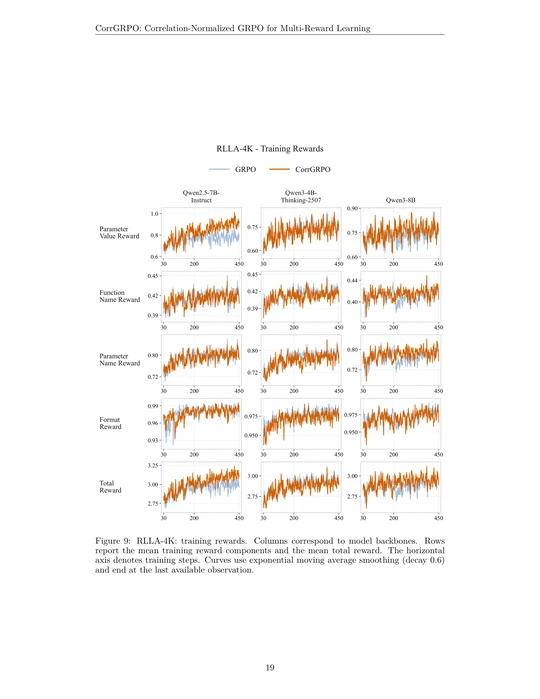
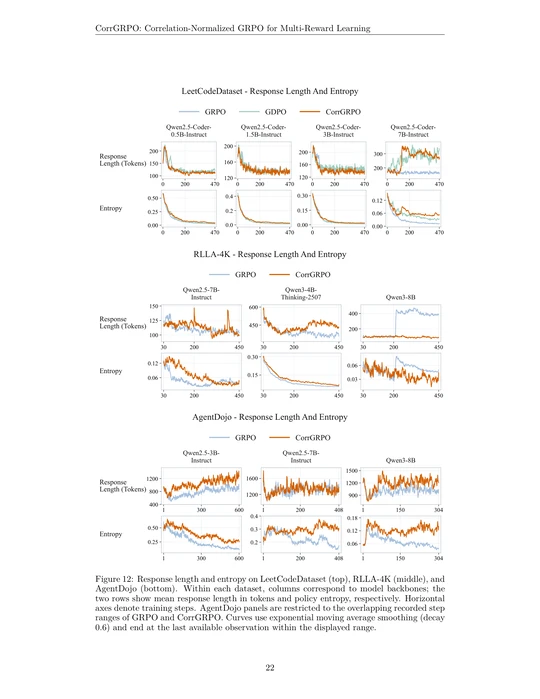
代码任务上的结果稳一些,7B 在 LeetCodeDataset 的 Pass@1 从 15.79% 到 24.12%。也有不如 GRPO 的,Qwen3-8B 在 AgentDojo 上 Joint 低了 0.64 个点。
分母对同一组样本是同一个数,组内谁好谁坏的排序不受影响,我理解它调的是不同 prompt 之间的更新力度。改动就几行,手上那个多奖励的任务我会换上跑一版。
#人工智能 #大模型 #强化学习 #论文 #深度学习