用 Claude Code 跑长任务,上下文一满它就自己压缩一遍,前面交代过的约定忘掉一半,烦得很。
那能不能让记忆一直往上加,生成又不变慢?
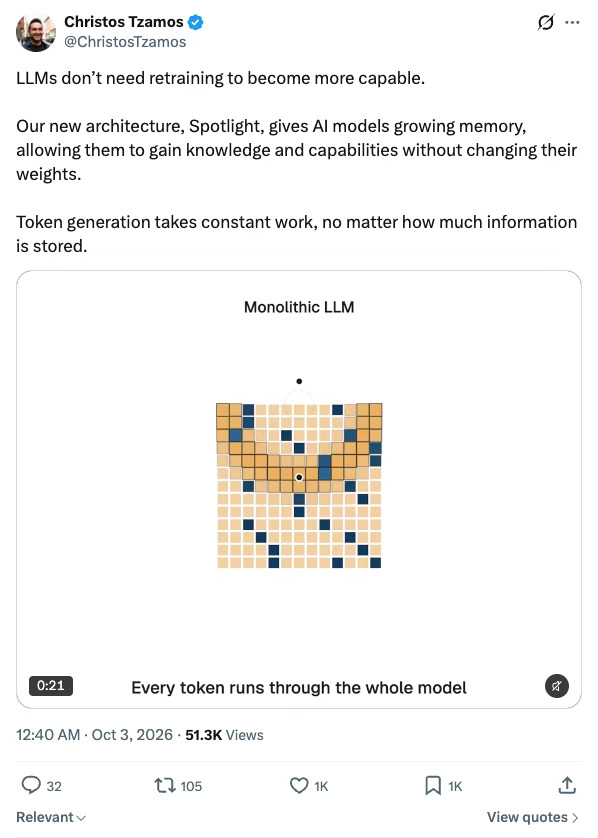
Percepta 这条说的就是这个。他们的新架构叫 Spotlight,给模型一块会增长的记忆,知识和能力往里放,权重不动。按他们的说法,不管存了多少东西,每个 token 的生成工作量都是恒定的。早期训练实验里,RULER 这类要召回的长上下文评测,比 Attention 和 Gated DeltaNet 好。
可这个恒定包不包括检索、写入和维护记忆的开销,帖子里一个字没提。
还说在模型里搭了 Python 和它的包生态,这个演示我没看懂想说明什么。开头那句“LLM 不用重训就能变强”喊得有点大,我先把它当一个想盯着看的架构方向,两篇博客周末读。
#人工智能 #大模型 #AI