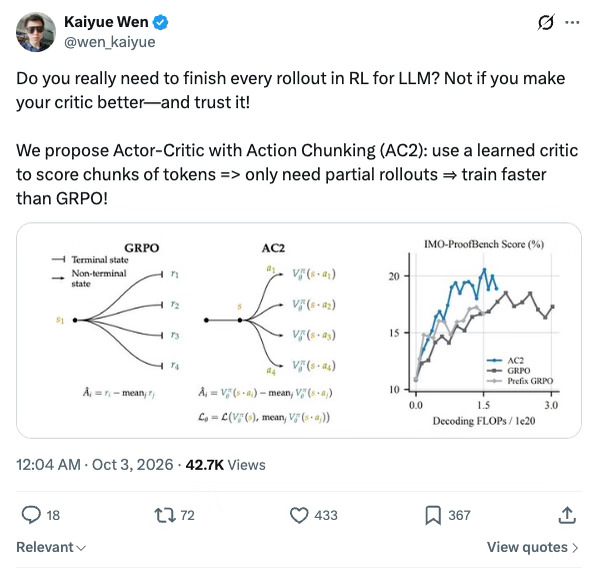
做 LLM 的 RL,每条回答都得生成到底才拿得到奖励,几十万 token 烧下去挺心疼。这篇想让 critic 在半路就打分。
那 critic 凭什么能信?以前它基本只当个 baseline。
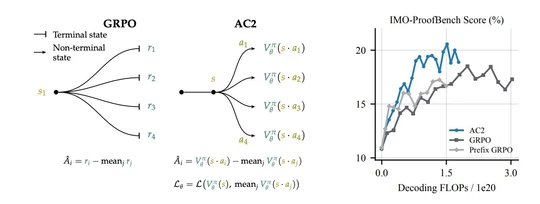
他们按题来:某道题上 critic 误差够小才信它,之前照样跑完整 rollout 拿最终奖励。信了以后从旧轨迹截一段前缀,往后采一组 10k token 的片段,逐段让 critic 打分,这部分更新不碰终点奖励。critic 和 policy 还共用权重,价值靠一句自然语言 prompt 读出来,有点野。
Qwen3-4B 训证明题,在 IMO-ProofBench 上追平 GRPO 峰值,解码 FLOPs 少 2.5 倍,步数也少 25%。就一个 4B 模型一类任务,换成代码题 critic 多久才变准,还不知道。
#人工智能 #大模型 #强化学习 #机器学习 #深度学习