我之前挺信 on-policy 蒸馏那套说法:学生自己采样,老师逐 token 打分,遗忘少,更新稀疏,泛化也更好。这篇把 rollout 来源、token 级 KL 方向、学习率拆开单独调,结果这几条在小模型上大多站不住。
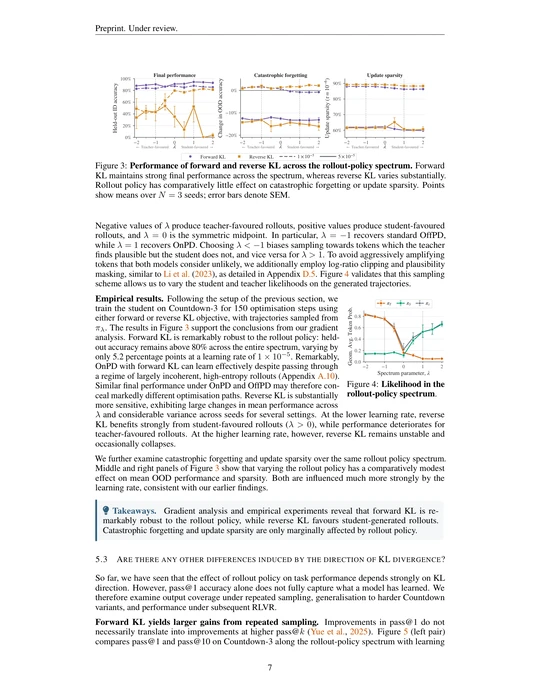
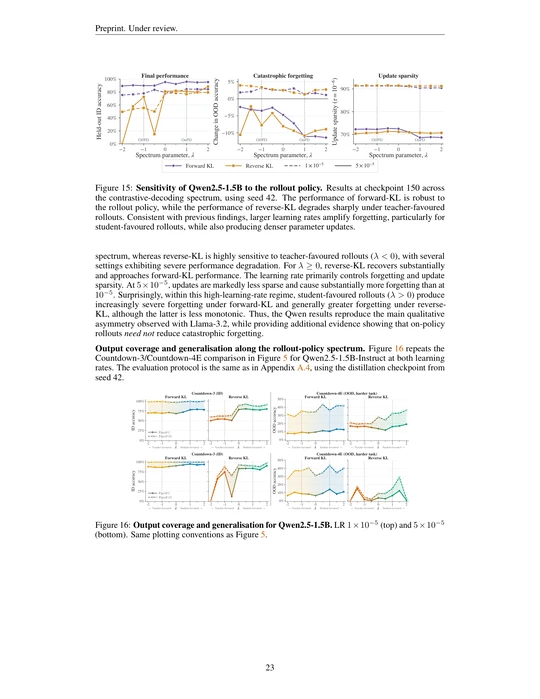
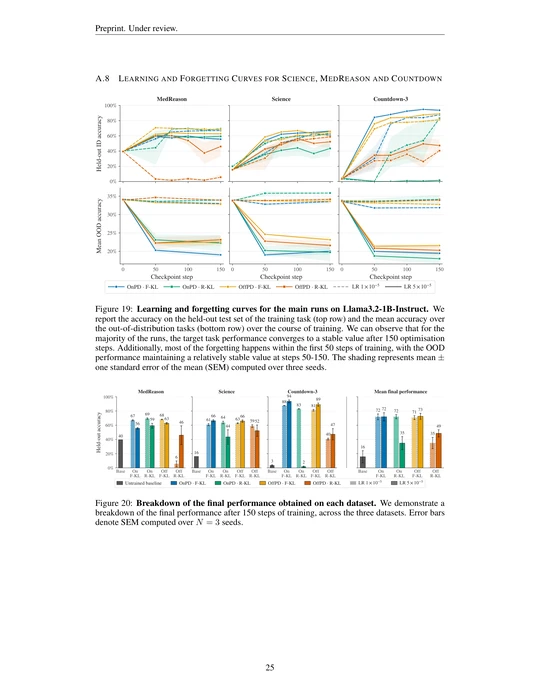
先说遗忘。Llama-3.1-8B 蒸到 3.2-1B,学习率 1e-5 时,七个 OOD 基准的平均分变动不超过 1.3 个点;换成 5e-5,直接掉 11.2 到 14.0 个点。换 rollout 来源的差别小得多,学习率相同时反而是 off-policy 忘得少一点。更新稀疏度也一样,低学习率 85% 上下,高学习率 52% 到 60%,基本跟 rollout 来源无关。
再说 KL 方向。forward KL 不管用谁的 rollout,三个任务平均准确率都在 71% 到 73%。reverse KL 从 35% 到 72% 都有,学习率一高就容易崩。on-policy 和 off-policy 各自的峰值是 72% 和 73%,算打平。
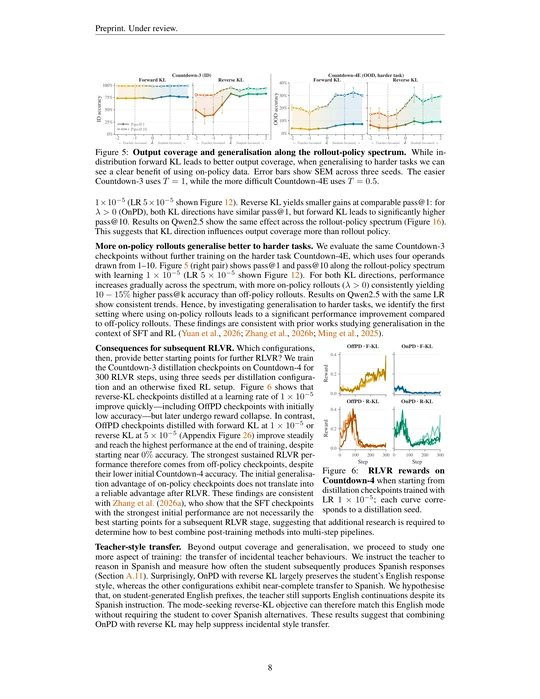
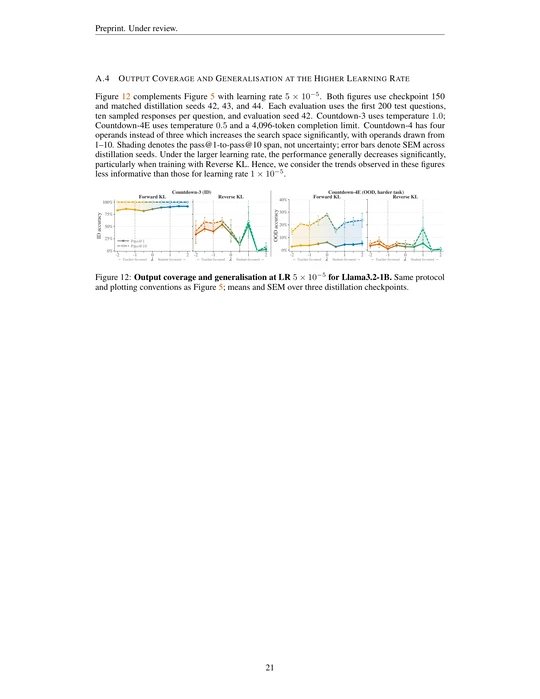
on-policy 也有赢的地方:在 Countdown 上训完,直接测四个操作数的难版本,偏学生的 rollout pass@k 高出 10 到 15 个点。可再接一轮 RLVR,这优势就不一定还在了。
学生顶多 1.5B,主实验的回答才一百来个 token,长推理那组每个条件只跑了一次。
论文:https://arxiv.org/pdf/2609.35259
#大模型 #深度学习 #论文 #人工智能 #机器学习