【100天搞懂AI · Day 015】整天说投喂数据,大模型每天吃进去的到底是什么?
别以为数据就是电脑里规整的 Excel 表格。
现代大模型吞吐的,是整个人类文明在互联网上留下的全域数字投影!
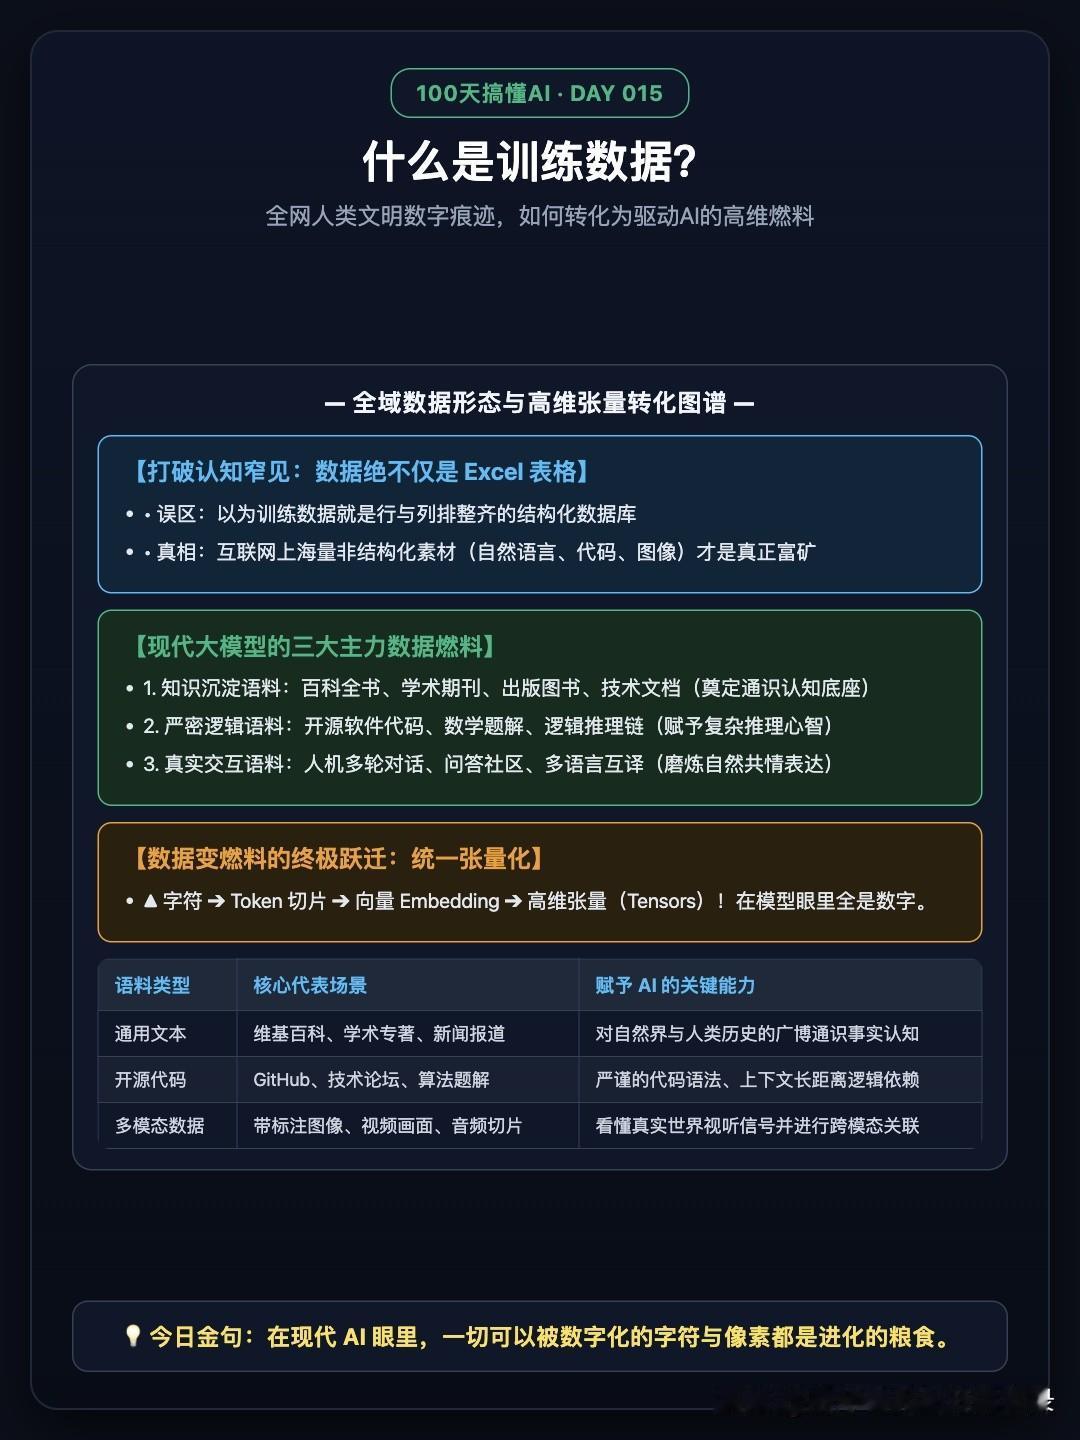
一张图看清三大核心数据燃料与转化机制:
【大模型的超级营养餐谱】
1. 通识底座:百科全书与经典出版物
维基百科、学术论文、典籍图书。这是 AI 的通识教科书,奠定它对历史、科学与常识的基础理解。
2. 逻辑内核:开源代码与数学题库
GitHub 代码库、严密题解。这是 AI 逻辑思维的磨刀石,教会它严格的语法依赖与长链条因果推理。
3. 人情练达:多轮对话与论坛交流
优质社群讨论、人工打磨问答。这是 AI 的情商训练营,让它懂得人类说话的语气、暗语与修辞。
【万物皆是张量】
不管是一行 Python 代码,还是蒙娜丽莎的微笑,被切片编码后,最终全部变成高维数学空间里的向量数字矩阵。
💡 今日金句:
在现代 AI 眼里,一切可以被数字化的字符与像素都是进化的粮食。
💬 互动聊聊:如果未来的互联网充满了 AI 自己生成的文本,训练数据会面临枯竭吗?
(明天见:Day 016|数据越多,AI 就一定越好吗?)
100天搞懂AI 数据工程 大模型 人工智能