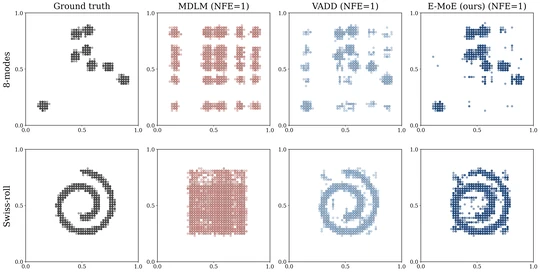
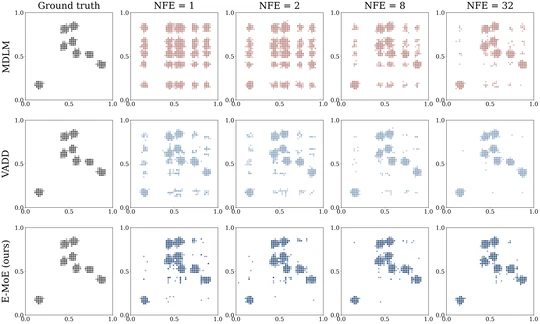
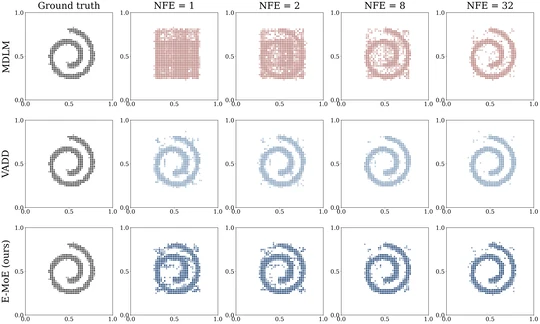
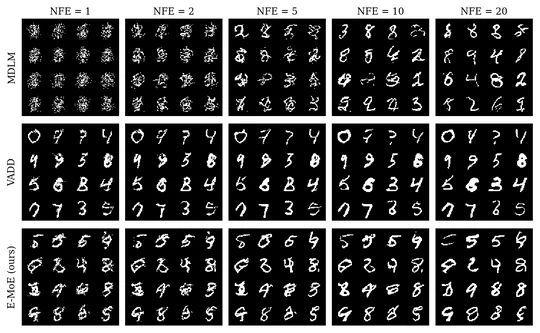
掩码扩散语言模型有个老毛病:步数一少,句子就散。每一步同时揭开好几个位置,每个位置却是各自独立采样的。模型看得到整句上下文,但不管这几个新词彼此搭不搭,一次揭得越多,越容易拼出单看都对、放一起不成话的组合。
那怎么让同一步揭开的词互相知道对方?
之前 VADD 加了个连续的高斯隐变量,再配一个识别网络一起训,容易 posterior collapse(隐变量被模型悄悄无视)。E-MoE 的思路挺省事:MoE 本来每层每个 token 都要选专家,这串路由选择就是现成的离散隐变量。同一个 router,喂带 mask 的序列当先验,喂干净序列当后验,中间用 KL 对齐。激活参数和 MDLM 一样多,训练要两次前向,采样还是一次。
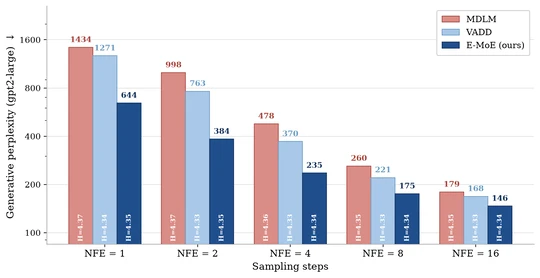
LM1B 上 NFE=1,生成困惑度 643.8,MDLM 是 1433.8,VADD 1270.8,样本熵都在 4.34 到 4.37 之间。NFE=2 时 MAUVE(看生成分布像不像真文本)24.6%,另两个只有 3.0% 和 3.8%。步数加到 128 基本就拉平了。但 AR 是 67.97,差距还大,而且只是 small DiT、长度 128 的设置。
手上有个小的 MoE 扩散模型,打算把 router 那项 KL 加进去,只看 1 到 4 步的样本顺不顺。
论文:https://arxiv.org/pdf/2609.37533
#人工智能 #大模型 #深度学习 #论文