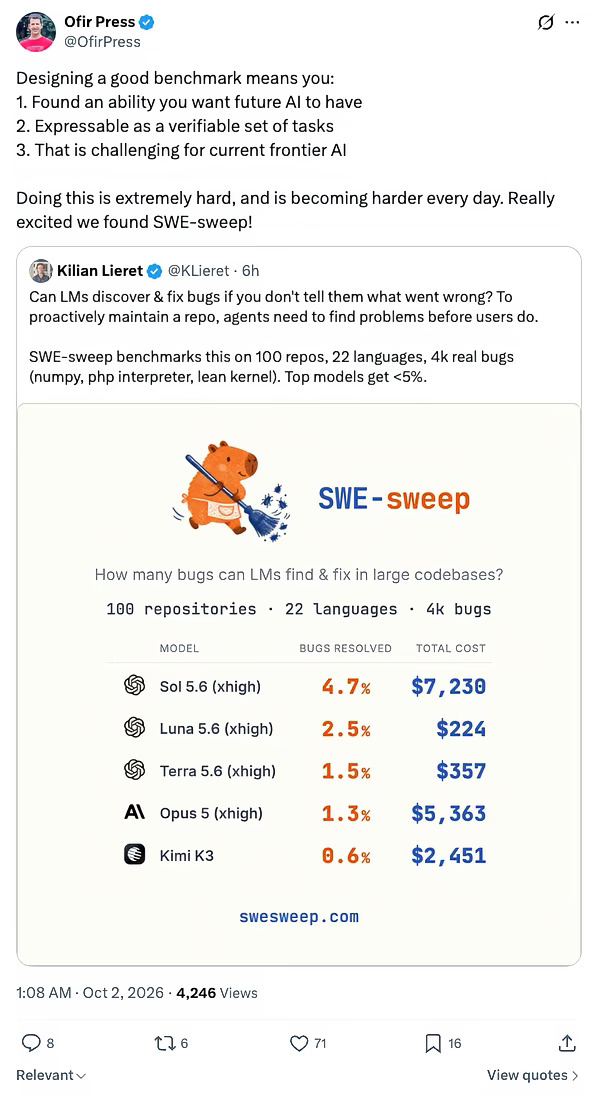
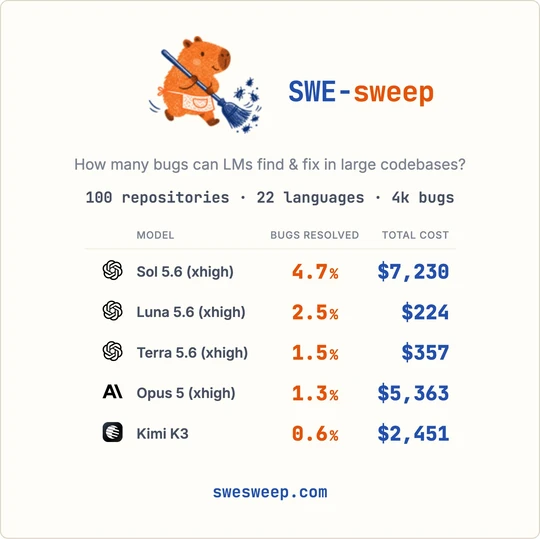
4.7%,这是榜上头名 Sol 5.6(xhigh)的成绩,总成本 7230 美元。这题出得够狠,钱也烧得我有点肉疼。
SWE-sweep 跟 SWE-bench 那套不太一样。SWE-bench 是拿着 issue 去修,哪儿坏了有人告诉你;这里什么都不说,模型得自己在仓库里把 bug 翻出来再修好。100 个仓库,22 种语言,4000 个真实 bug,numpy、PHP 解释器、Lean 内核都在里面。所以 4.7% 别往“AI 写代码只有百分之几成功率”上套,它卡住的是主动找问题这一步。
表里我看得直皱眉的是价格。Luna 5.6 拿了 2.5%,花 224 美元。Opus 5 拿 1.3%,花了 5363。分数和花费基本对不上号。
好 benchmark 越来越难找,Ofir 这句我认。能让前沿模型集体个位数的题真不多了,我倒挺想拿组里的老仓库喂进去,看它能翻出点啥。
#人工智能 #大模型 #程序员 #AI编程 #编程