如果记忆里压根没有那段画面,视频助手会老实说不知道,还是照样编一个答案?
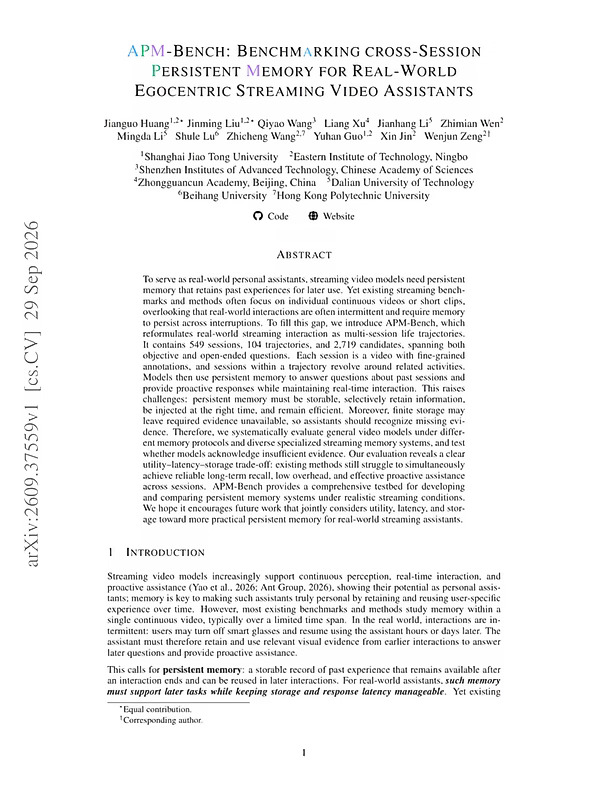
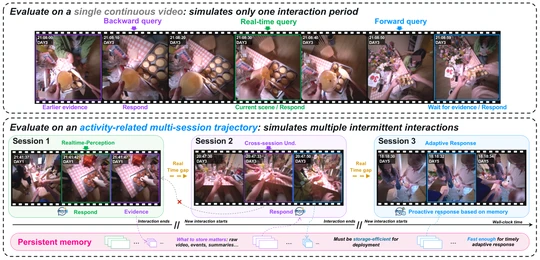
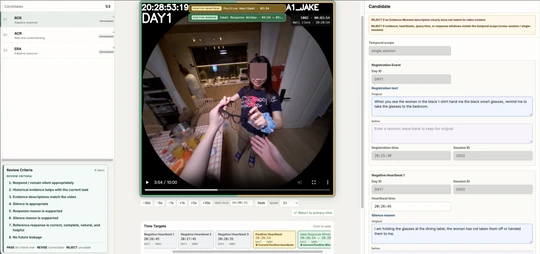
APM-Bench 里专门测了这件事。场景是智能眼镜这类设备:用户关掉,过几小时甚至几天再打开,之前的画面不会重放,助手只能靠存下来的记忆回答。存储有限,总有东西会丢。
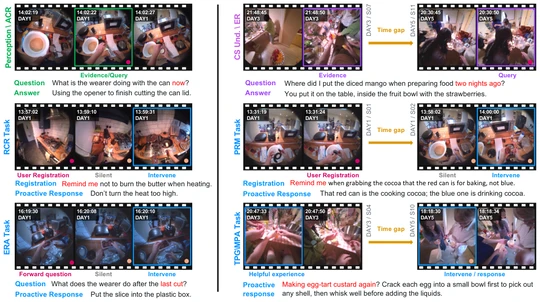
他们挑了 260 道跨 session 的题,只让模型看最近两个已经结束的 session。一半题的证据就在这两段里,另一半的证据在更早的 session,已经看不到了。每题除了四个选项,还多给一个“现有证据不足”,题目里也附了大致的时间范围,按理说模型是有线索判断的。
Gemini 3.6 Flash 在证据还在的那半边答对 85.38%,挺强。可证据不在的时候,只有 59.23% 选了证据不足,剩下四成左右还是挑了一个具体答案 😅 Qwen3.8-27B 这一项更低,46.92%。
作者的建议是让记忆系统把自己覆盖了哪段时间显式标出来,助手据此决定答不答。我觉得这个思路搬到文本 agent 的长期记忆上也成立,那边一样有“记忆被压缩过、但模型不知道丢了什么”的问题。
对照组 SimpleStream 只看最近 4 帧,证据不足那边拿了 95.38%,证据在的那半边只有 3.85%,基本是见题就说不知道。
论文:https://arxiv.org/pdf/2609.37559
#人工智能 #大模型 #深度学习 #计算机视觉