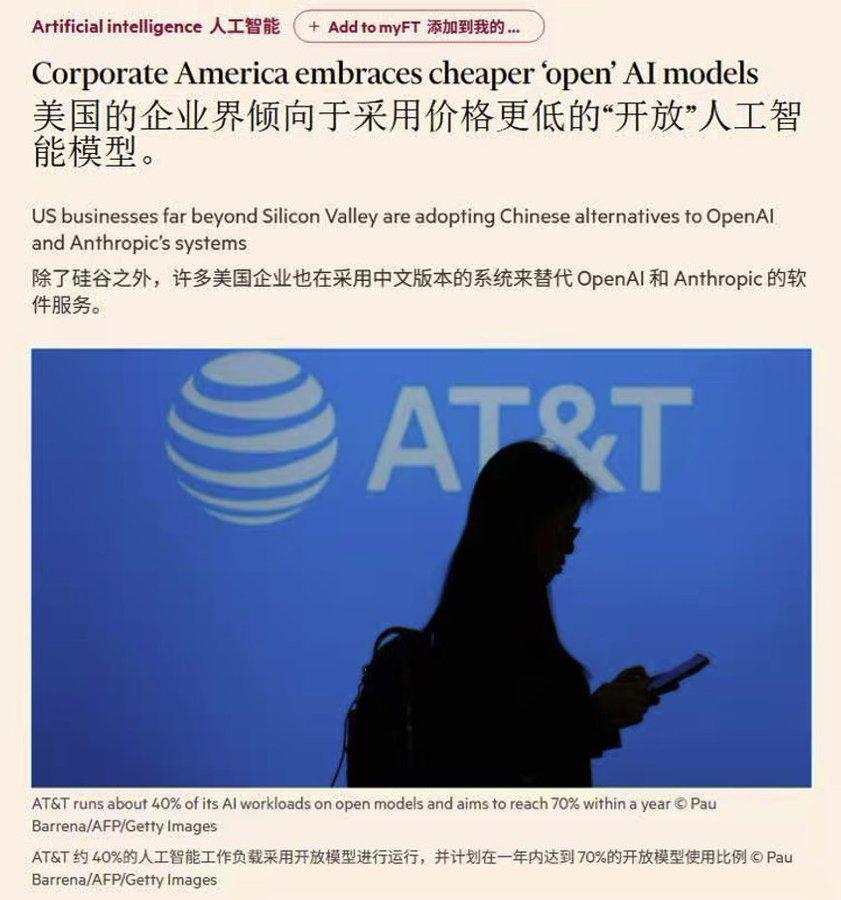
不少人看到消息,说美国企业正在集体弃用中国 AI 大模型。 很多网友第一反应,难道国产大模型的竞争力不行了? 仔细看才发现,不全是性能原因,更多是美国合规与地缘层面带来的顾虑。
Match 集团 CEO 斯宾塞・拉斯科夫最近接受《金融时报》采访时说得很直接,公司确实是各大云厂商的重量级客户,但同时也在大量试用来自全球的开源模型,其中包含中国开源模型,核心目的就是压成本。
Match 旗下最出名的产品是交友软件 Tinder,这话从它嘴里说出来,分量不轻,毕竟这家公司过去一直被算作硅谷阵营里的大客户。
Tinder 的技术负责人库鲁维拉给了个数字,今年 1 月,公司 AI 年化支出刚过 100 万美元,到 7 月直接冲到 1000 万美元,十倍涨幅。
库鲁维拉解释得也坦率,像 OpenAI 内部代号 Astra、Anthropic 的 Claude 这类顶级模型,处理公司 90% 的日常需求本来就绰绰有余,多半是分类、摘要、客服这种基础活,属于杀鸡用牛刀。
他说得更直白,一旦开源模型能力追上来,高价顶级闭源模型在基础场景可能就用不上了。
电信巨头 AT&T 的做法更彻底。负责数据和 AI 业务的马库斯透露,公司每天要处理 450 亿个 Token,目前四成任务已经交给开源模型,一年内要把这个比例拉到七成。
他的理由也很实际,开源模型进步很快,用得越多,可选择的余地就越大,谈判桌上腰杆也能硬一点,不至于被一家供应商牵着走。
这不是个别公司临时起意。研究机构 AlphaSense 统计显示,今年 8、9 月的财报会和投资者交流上,美国企业提到开源模型的次数,比去年同期涨了大约 6 倍。
金融机构 PNC、物流公司 CH 罗宾逊、工业巨头西门子都被点名参与其中,这几家横跨银行、物流、制造三个完全不搭边的行业,说明这不是某个圈子的小范围试验,而是普遍现象。
CH 罗宾逊首席战略官阿伦・拉詹说得也明白,简单的活儿以后会持续往开源模型上转移,这个趋势不会回头。
除了省钱,还有一层原因容易被忽略。数据中心运营商 Digital Realty 的方案架构总监斯科特・华莱士提到,公司专门搭了一套跑在开源模型上的内部聊天工具,因为涉及客户机密数据,绝不能往闭源的顶级模型里塞,用他的原话,客户数据永远不会进入前沿模型。
省钱是一方面,数据不出自己家门,是另一方面,这层顾虑在金融、通信这些行业尤其重,比价格本身还敏感。
代码托管平台 Vercel 的网关数据也能印证这个走势,基于 Vercel 网关流量统计,今年 8 月,开源模型处理的 Token 量占比已经涨到 56%,去年 12 月这个数字才 7%,几乎是从零起步一路爬升。
而在这波开源浪潮里,全球有多家开源模型参与竞争,除了欧美的 Llama、Mistral,中国的 DeepSeek、智谱这些实验室的模型也被海外企业纳入选型测试,此外像 Kimi、GLM 系列也被不少企业拿来跟顶级闭源模型对比测试,价格差距往往是几倍甚至十几倍。
对 OpenAI 和 Anthropic 来说,这不是小事。两家公司都在筹备上市相关工作,Anthropic 市场传闻估值接近 2 万亿美元,OpenAI 私募市场估值传闻达到 1.2 万亿美元,市场分析师猜测上市窗口可能推迟至 2027 年,暂无官方确定时间表。
企业客户大批量把简单任务迁出去,等于这两家最赚钱的基础业务被切走一块,招股书里怎么解释这块增长放缓,都得重新斟酌。
也正因为这样,两家公司近期不约而同推出了价格更低的精简版本,摆明是要把流失的客户拉回来。
这场转向背后没有太多复杂的算计,就是企业算账算得比以前精了。以前挑模型看排行榜,现在 CFO 直接翻账单。
中国实验室做的模型价格更低,能力也追得够快,成为海外企业降本运动里的现实选项,这属于纯商业层面的选型取舍,无关立场。
开源模型和闭源模型这场较量,接下来大概率还会持续拉锯,但企业用脚投票的方向,已经很清楚了。晒图笔记大赛
参考来源:The Verge,2026 年 09 月 15 日,美国电话电报公司将 40% 的人工智能工作负载迁移至开源模型,以此减少厂商锁定。