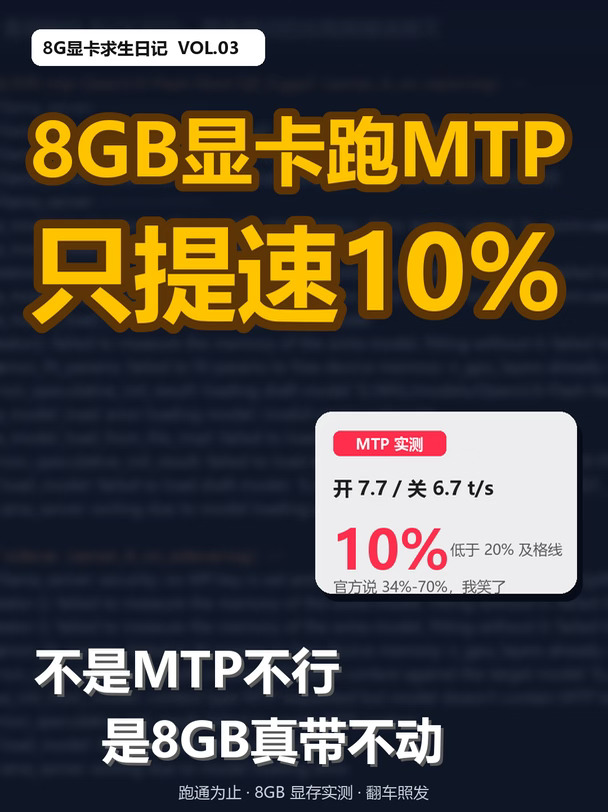
先说结论:不是MTP不行,是8GB显卡真带不动。
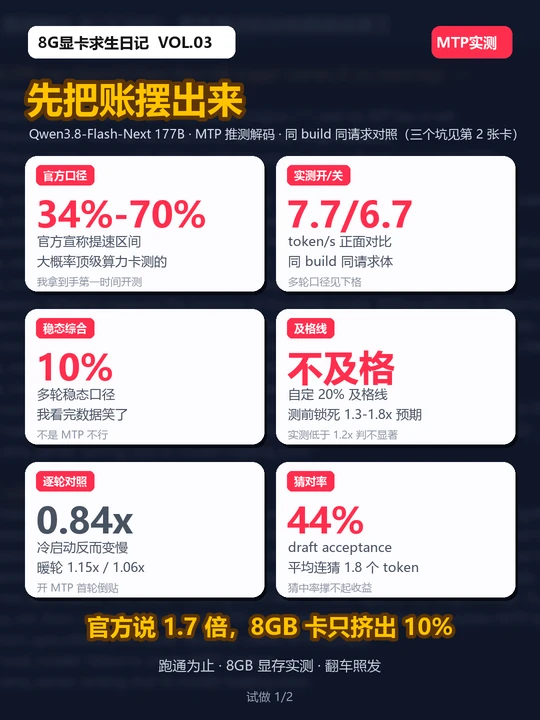
官方说Qwen3.8-Flash-Next的MTP推理提速34%~70%。我拿到手第一时间开测,测完看着数据,我笑了:10%。
📊 先把账摆出来
开MTP:7.7 token/s
关MTP:6.7 token/s
多轮稳态综合:约10%
低于我自己定的20%及格线。不及格。
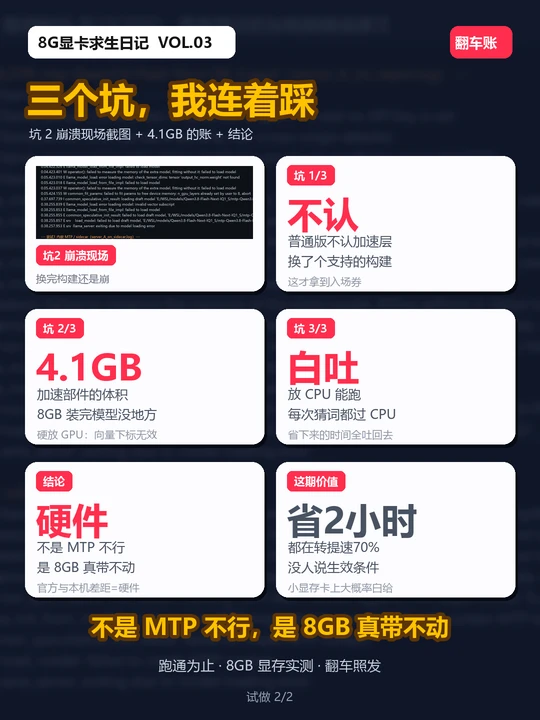
🔧 三个坑,我连着踩
1️⃣ 普通版根本不认这模型的加速层,换了个支持的构建。
2️⃣ 换完还是崩,报"向量下标无效"。查了两天日志,真相离谱:加速部件4.1GB,我的8GB显卡装完模型已经没地方了,硬放GPU就崩。
3️⃣ 放CPU?能跑。但每次猜词都要过一遍CPU,猜对率44%,省下来的时间全吐回去。
所以结论不是"这技术不行"。官方大概率是在顶级算力卡上测的,我这是8GB。差距就是硬件,认了。
💡 这期为什么值得写?
因为到处都在转"提速70%",但没人告诉你生效条件。
小显存卡上,这技术大概率白给。看完这篇,至少省你两小时折腾。
8G党的字典里没有奇迹,只有实测。
#8GB显卡实测 #Qwen3.8FlashNext #MTP #大模型推理 #本地大模型 #AI实测 #提速避坑 #我这行的AI路 #我这行的AI路