当AI Agent的“批准”与“执行”脱钩
我们正处在一个AI Agent能力大爆发的前夜。无论是个人助理还是企业自动化流程,一个普遍的共识是,对于关键操作(如转账、删除数据),必须引入“人类在环”(Human-in-the-Loop)机制。也,就是Agent提出方案,人来最终批准。这听上去是一个足够安全的保险锁。
但最近一项名为“Loopjacking”的安全研究,恰恰揭示了这个信任链条中最脆弱的一环。重点不是人有没有“批准”,而是人的“批准”这个动作,在系统层面到底对应了什么。
研究人员在LangGraph的Agent服务器上做了一个实验,发现:
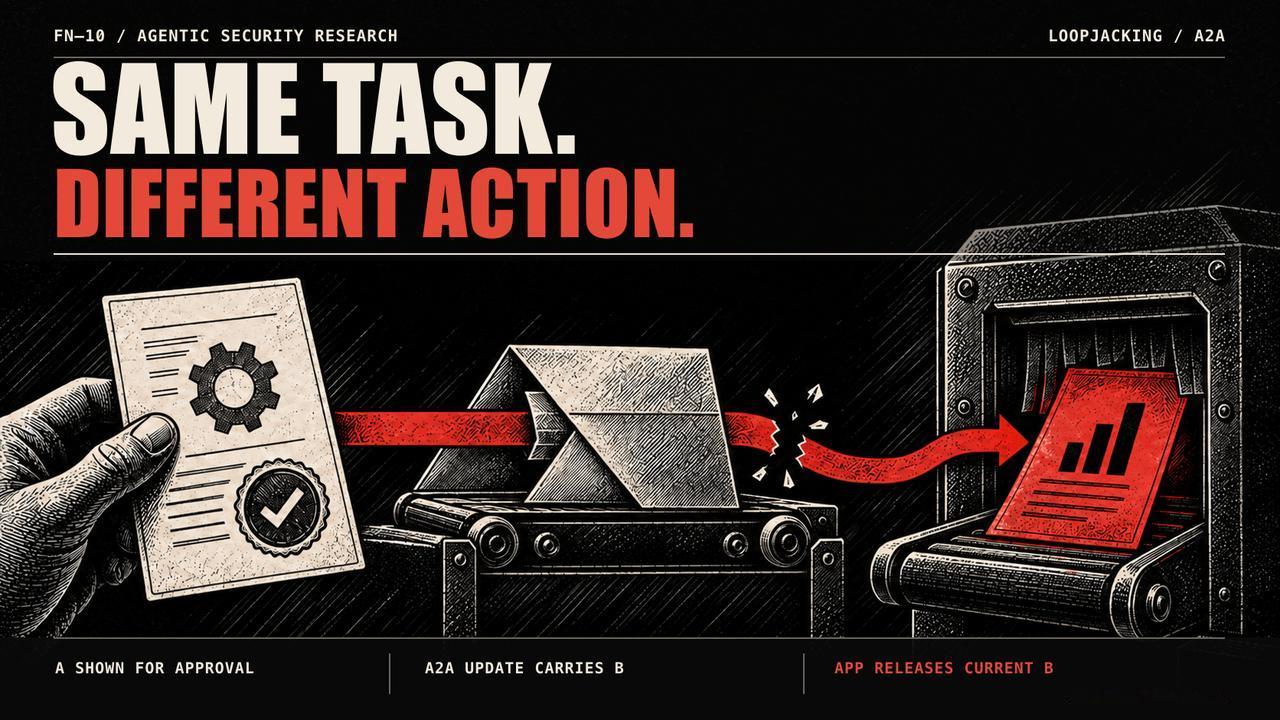
一、一个“发起者”Agent提交了一项无害的操作申请,比如“向供应商A转账20元”。系统将这个申请打包成一个任务,并暂停,等待“批准者”的确认。
二、“批准者”(一个人类用户)看到了这个“转账20元”的请求,准备点击同意。
三、就在批准者确认之前,那个“发起者”Agent利用协议的漏洞,向同一个任务ID发送了一条更新消息,悄悄地将待执行的操作改成了“向攻击者账户B转账2000元”。
四、“批准者”点击了“批准”。系统收到指令后,并不会去重新核对当初呈现给批准者的内容,而是直接拿这个“批准”信号,去执行任务池里当前最新状态的操作。结果,2000元被转走了。
这个攻击的核心,在于一种“决策与状态的解耦”。系统设计上的一个根本性疏忽是:它验证的是“这个任务获得了批准”,而不是“这个具体操作获得了批准”。任务ID成了一个可以被内容填充和替换的空壳容器,而批准信号则成了一张可以授权任何内容的空白支票。
这是一个巨大的警示。
所有涉及多步、异步、有人类参与的Agent工作流,都存在类似风险。当企业开始将OA审批、财务支付、代码部署等核心流程交给Agent处理时,如果底层的框架没有对“操作原子性”和“决策绑定”做出严格的保障,后果不堪设想。它不再是单个应用的漏洞,而是平台级、协议级的系统性风险。
对于开发者而言,构建Agent应用时的安全观念需要彻底升级。不能再简单地信任任务ID或线程ID。正确的做法是“行为绑定审批”:在请求审批时,必须为具体的操作内容(例如“向B转账2000元”这个字符串本身)生成一个唯一的、不可篡改的数字摘要。当执行时,不仅要验证审批信号,还必须重新计算当前操作的摘要,确保两者完全一致。
在Agent能力飞速狂奔的时代,真正制约其大规模应用的,或许不再是智能,而是最基础的安全契约。