AI的语料战争:买下并销毁一切
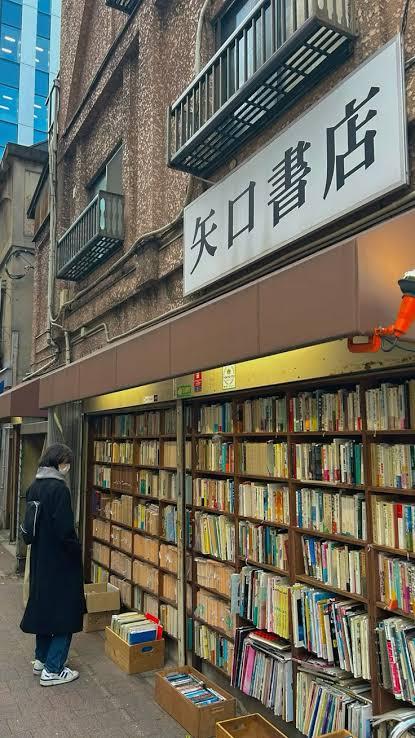
日本全国各地的旧书店,突然迎来了神秘的大宗采购,订单量暴增五倍,甚至有单次50吨的旧书被运往美国。这些书的最终命运,是在被高速扫描后,化为纸浆。许多人对此感到惋惜甚至愤怒,认为这是科技公司对人类文化遗产的一次野蛮掠夺,一场数字时代的“焚书”。
这是一场冷酷的商业计算。重点不是“销毁”,而是“买下”。AI的竞争,已经从算法和算力,悄然升级到了最底层的“语料垄断”战争。
这场战争的逻辑可以拆解为三步:
第一,寻找“干净”的数据源。今天的互联网,已经被大量AI生成的内容所“污染”。如果用这些数据再去训练下一代模型,只会导致模型能力退化,陷入“模型坍缩”的怪圈。而那些未经数字化、沉睡在仓库里的旧书,尤其是哲学、历史、法律等高信息密度的非虚构类书籍,就成了最宝贵的“净土”。它们是未经算法干扰的、高质量的人类思想结晶。
第二,实现规模化的成本效益。为什么是旧书,而不是新书?答案是成本和效率。逐本购买新书版权,成本高昂且流程复杂。而以“吨”为单位收购旧书,本质上是一种数据采集的“暴力美学”。AI公司不在乎其中有多少是无用的,它们要的是用最低的边际成本,将一个时代的人类知识库进行一网打尽式的扫描。
第三,也是最关键的一步:销毁即护城河。销毁纸质原版,表面上看有两个原因。其一,是为了规避法律风险。在美国的一些判例中,如果将实体书转为数字格式后销毁原件,可以被视为“合理使用”中的格式转换,从而绕开复杂的版权问题。其二,是物理扫描的效率,拆掉书脊逐页扫描远比翻页快。通过买断并销毁市面上流通的孤本或稀有版本,实际上是在构筑一道无法逾越的数据护城河。你不仅拥有了这份独家数据,还确保了你的竞争对手,尤其是后来者,再也无法从同一来源获取它。
AI巨头们正在利用资本优势,将人类共享的知识遗产,转化为自己私有的、不传之秘的训练数据。开源社区和后来的创业公司,将面临无“米”下锅的窘境。当公共知识被封装进少数几个闭源大模型的API接口背后,我们获取信息的方式、成本,甚至我们能“知道”什么,都将被重新定义。
当人类知识的总和被私有化并成为少数公司的护城河,我们失去的可能不仅仅是旧书。