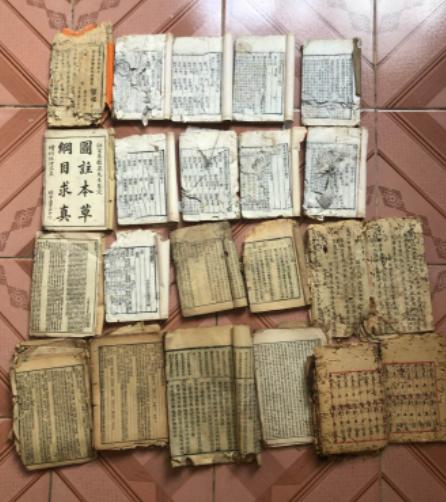
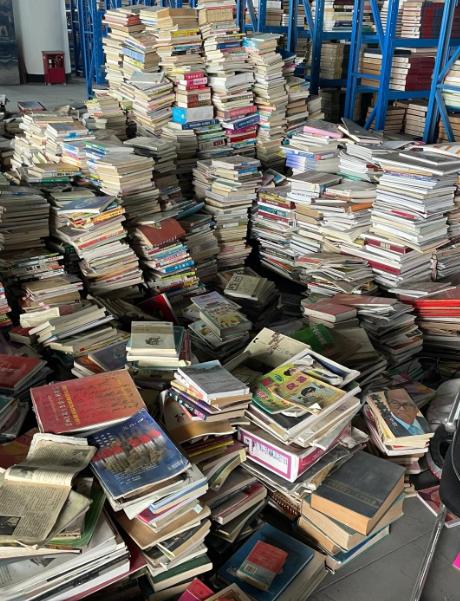
越想越脊背发凉!大模型终于露出了獠牙 —— 现在开始满世界 “吃纸” 了。日本多地突然冒出大批神秘买家,扫荡式收二手书,历史哲学、医书方志、老政治册子…… 只要带字的,通通来者不拒。
从今年8月开始,日本各地的二手书店,突然撞上了从天而降的大单。
不是收藏家挑几本珍本,是神秘买家扫荡式扫货。历史哲学、医学法律、偏远地区的地方志、甚至几十年前的老政治小册子。只要是带字的纸,来者不拒。
有关东的老店主,干了几十年旧书生意,从来没见过这阵仗。一天能卖出去100册,赶上过去大半个月的量,单日销售额直接翻5倍。
更怪的是买家根本不挑。不管题材冷不冷,不管品相好不好,价格比市价高也照单全收。收货地址统一,还要求签保密协议,不许透露买家身份。
我看到这事儿第一反应就是,这哪是买书,这是抄家啊。
顺着物流链条查下去更吓人。
日本电视台查进出口数据,光去年到现在,已经有超过50吨的日本书籍,被运去了美国。
美国AI公司Anthropic,搞了个代号叫“巴拿马计划”的秘密项目。
说白了就一件事:满世界买二手书,拆了扫成数据喂大模型,扫完直接把原书粉碎销毁。
整个流程全是流水线。液压机一刀切书脊,工业高速扫描仪每分钟扫上百页,扫完直接进粉碎机,连渣都不剩。
这个项目预算几千万美元,半年计划处理几十万到上百万册书。
核心要求就一个:尽量别让外界知道。
我看到这儿真的气笑了。
以前总说AI是数字科技,是未来。结果闹了半天,最顶级的大模型,最后还要靠吃纸活着。
说出来挺讽刺的。
现在网上的内容,大半都是AI自己生成的。用AI生成的内容再训练AI,就像用自己的剩饭再炒一遍,越炒越没营养,模型只会越学越笨。
所以他们盯上了2022年之前出版的纸质书。
这些书是纯人类一字一句写出来的,没被AI污染过,是“干净”的原生数据。
为了这点干净数据,他们不惜满世界扫货,不惜把书拆成碎片。
我跟你说,一本书承载的从来不止是文字。
老纸的材质、当年的印刷工艺、历任藏家的手写批注、不同版本的装帧细节、甚至书页上泛黄的痕迹。
这些都是文明的实物证据。
尤其是那些绝版书、孤本,全世界可能就剩这么一本。
你把它粉碎了,就是把这份独一份的文明证据,从地球上彻底抹掉了。
以后再有人想考证这段历史、核对这个版本,只能去看AI数据库里存的电子档。
可电子档是人家的私产。
人家想改几个字,想删几段话,你连对证的原件都找不到。
这哪是数字化保存,这是借着数字化的名义,垄断知识的解释权。
更荒唐的是这事儿的法律逻辑。
同样是这家Anthropic,之前从盗版网站下载了700万本书训练AI,被作者告上法庭,赔了15亿美元。
结果现在他们花钱买二手书,拆了扫描再销毁,美国法院居然裁定这是“合理使用”,合法。
我就纳闷了。下载盗版书是侵权,把正版书拆了毁了用来商业盈利,反倒合法了?
说白了,规则从来都是给资本量身定做的。
能让巨头花钱摆平的,就给你开绿灯;触动了资本利益的,就给你定规矩。
什么版权,什么文化保护,在商业护城河面前,全都是可以变通的。
现在这把火烧到了日本,50吨书已经运去了美国,接下来呢?
咱们中文的旧书、古籍、地方志、老刊物,会不会也已经被这帮人盯上了?
别觉得不可能。
现在早就有中间商在国内收书,走灰色渠道出境。
国内版权法对AI训练数据的界定还不清晰,数据出境的监管重点在个人信息。
普通图书的文本算不算重要数据,还没有明确定论。
真空地带,最容易藏污纳垢。
人家拿着美元溢价收,好多二手书商只看眼前的利钱,根本不管卖出去的书最后是进了博物馆还是进了粉碎机。
等我们反应过来,可能好多存世量稀少的地方文献、冷门典籍,早就被拆成纸浆,变成人家大模型里的一串数据了。
到那时候,咱们自己的历史、自己的文化,要查个原始资料,反倒要去求外国的AI公司,看人家愿不愿意给你开放权限。
我一直说,看事情不能光看表面的科技光环。
大模型听起来高大上,剥开外壳看,本质还是资本的游戏。
为了打造自己的数据壁垒,为了垄断未来的话语权,他们可以毁掉人类上百年积累的纸质文明。
可以把全人类的公共知识,偷偷搬进自己的私人金库。
这不是进步,这是劫掠。
以前的强盗抢文物,运去自己的博物馆,起码还留个实物。
现在的科技巨头抢知识,扫完直接销毁原件,连个念想都不给你留。
以后所有人知道的历史、常识、真相,都是他们想让你知道的版本。
想想都让人后怕。
人家已经动手抄家了,我们不能还捂着口袋装糊涂。
守住我们的老书,守住我们的文字,就是守住我们自己的根。