现在来看,黄仁勋之前作出的预测,十有八九是对的。
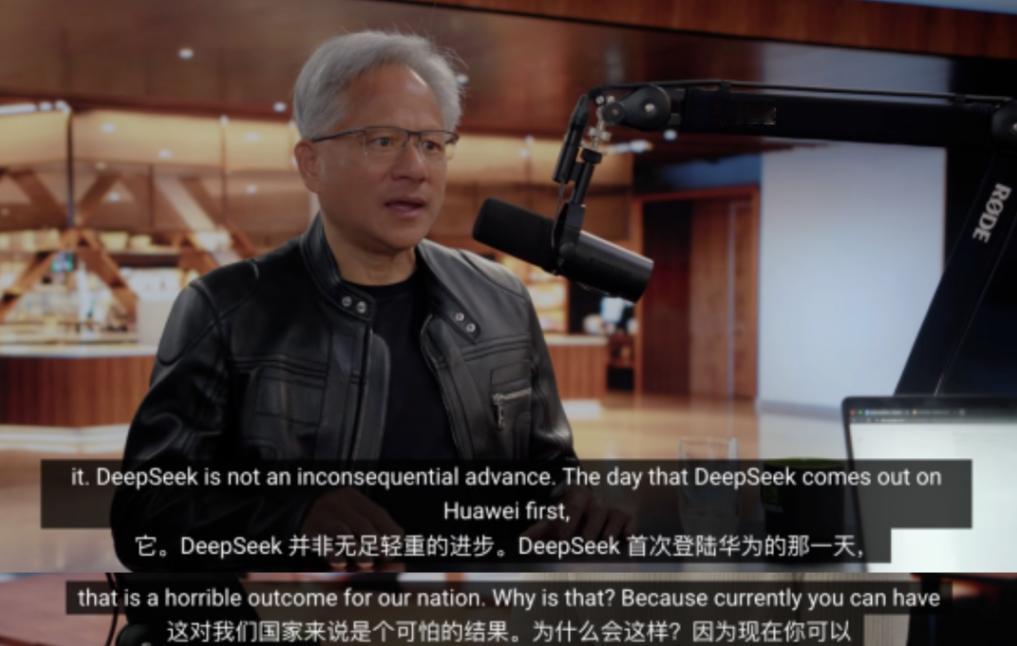
他说DeepSeek首次跑在华为芯片上对美国是个可怕的结果,很多人第一反应是这老哥又在帮英伟达要政策,想借着渲染中国威胁让美国政府松松出口管制的口子。
但我认为,黄仁勋说那番话的时候,是认真的,他看到的是一盘正在落子的棋局。
黄仁勋的原话分量很重,他说如果DeepSeek的新一代模型率先在华为芯片平台发布,对美国而言将是灾难性的后果。
这话乍一听像在替英伟达叫苦,但仔细琢磨,他真正怕的从来不是某一块芯片被替代,而是“开源模型必须以英伟达CUDA为首要优化目标”这条默认规则被撕开一个口子。
过去这么多年,全球主流大模型基本上都是先在CUDA生态里调通跑顺,其他硬件平台哪怕纸面性能不差,也只能当备胎,因为迁移意味着重写算子、重新调参,工程代价太大。
这个逻辑一旦被打破,英伟达真正的护城河,也就是CUDA作为事实标准的生态位,就会开始松动。
后来的事情发展,几乎把黄仁勋的担忧一条一条验证了。DeepSeek-V4上线的时候,技术报告封面上印了两行字,英伟达GPU和华为昇腾NPU并列写进了硬件验证清单。更关键的是,底层代码从CUDA重写到了华为自研的CANN框架。
这意味着DeepSeek不是随便找个国产芯片来凑合跑一下,而是从头到尾针对华为的架构做了深度优化。
在我看来,这就是黄仁勋嘴里那个“灾难性后果”的真正含义,一款顶尖的开源大模型,在一个非美国技术栈上跑出了最优表现,那么其他开发者再选硬件的时候,CUDA就不再是唯一答案了。
有人可能会说,华为单卡性能不是还差着英伟达好几倍吗,这有什么好怕的。单卡算力确实还有差距,华为昇腾910C的单卡FP16算力大约800TFLOPS,跟英伟达Blackwell旗舰比确实不在一个量级。
但我觉得,黄仁勋自己早就把这个问题想明白了,他公开讲过人工智能是一个并行问题,如果每台计算机性能不够强,那就用更多的计算机。
华为走的就是这条路,用系统工程层面的群体战术来弥补单卡差距。实际数据也说明问题,在DeepSeek-R1模型的评估中,华为CloudMatrix384超级节点上的昇腾910C,计算效率超过了英伟达H800。
而且华为昇腾950PR芯片的单卡算力达到了英伟达对华特供版H20的近三倍,采购价格却只有四分之一。性能和成本两头都占优,这才是让对手真正难受的地方。
我觉得最值得玩味的是,这件事发生的时间节点恰好卡在美国对华为芯片出口管制不断加码的背景下。美国商务部之前发过指引,说在全球任何地方使用华为昇腾芯片都可能违反出口管制规定。
这种打压的力度不可谓不大,但结果呢,DeepSeek照样把华为芯片写进了首发验证清单。ITIF的报告说得很直白,美国滥用出口管制反而帮华为变成了更强大的竞争对手,2021年到2024年美国公司因为对华为的限制至少损失了330亿美元的销售额。
我认为这就是典型的搬起石头砸自己的脚,你想卡住别人的脖子,别人反而被逼出了替代方案,而且这个替代方案一旦跑通,就再也回不去了。
黄仁勋自己后来也说了大实话,他承认英伟达在中国先进芯片市场的份额从95%跌到了零,中国已经不想要美国的芯片了。一个全球市值最高的芯片公司掌门人,亲口说出这种话,足以说明问题的严重性。
他还批评过美国针对中国的极端芯片出口管制十分幼稚,认为人为割裂出两套AI生态系统极其愚蠢。
这些话放在当时听,像是替中国市场说话,现在回头看,他其实是在替英伟达自己算账,因为一旦中国顶尖大模型和国产算力基座完成绑定,美国长期推行的芯片封锁就失去了最关键的抓手。
在我看来,DeepSeek选华为,压根就不是什么退而求其次的备胎方案,而是两个各自领域顶尖的选手主动走到了一起。字节跳动、腾讯、阿里巴巴在DeepSeek-V4发布后开始抢购华为国产芯片,国产芯片在中国AI加速服务器市场的份额已经攀升到了约41%。
这组数字背后是整个产业链在动,不是个别企业的临时选择。我觉得黄仁勋当初说那番话的时候,心里已经看到了今天这个局面,只不过当时大多数人以为他在帮英伟达要政策,现在才发现,他是在认真地预警一个正在到来的事实。