开源大模型,为什么有三种结构?
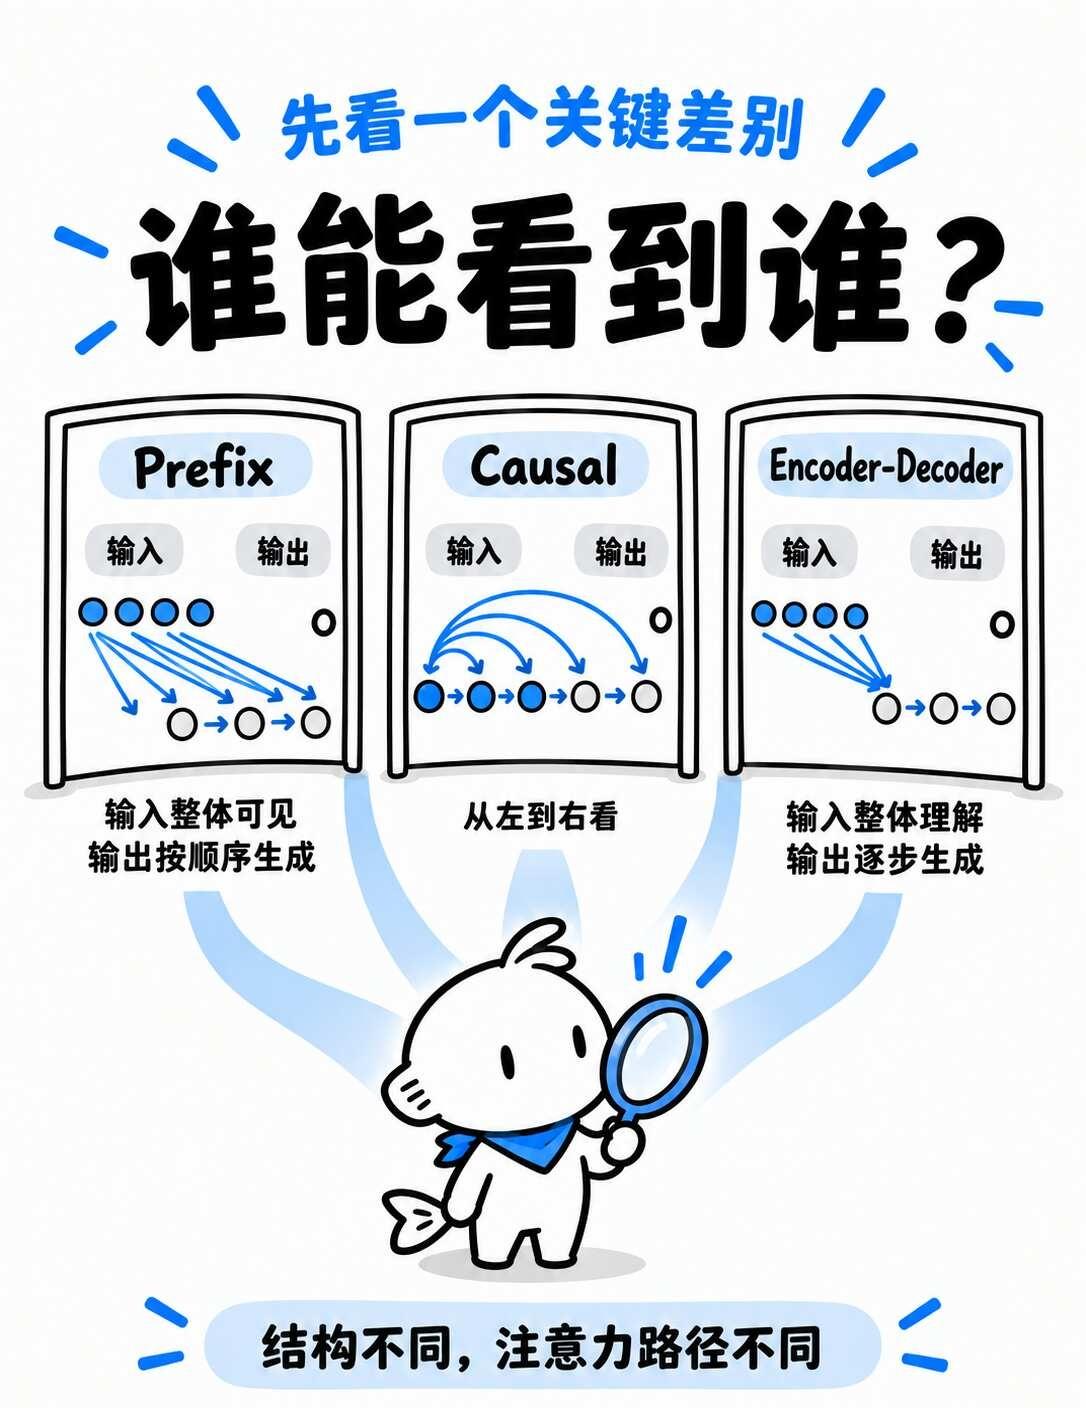
准备 AI 面试时,看到 Prefix Decoder、Causal Decoder、Encoder-Decoder,先别急着背模型名。它们最核心的区别,是注意力路径怎么走。
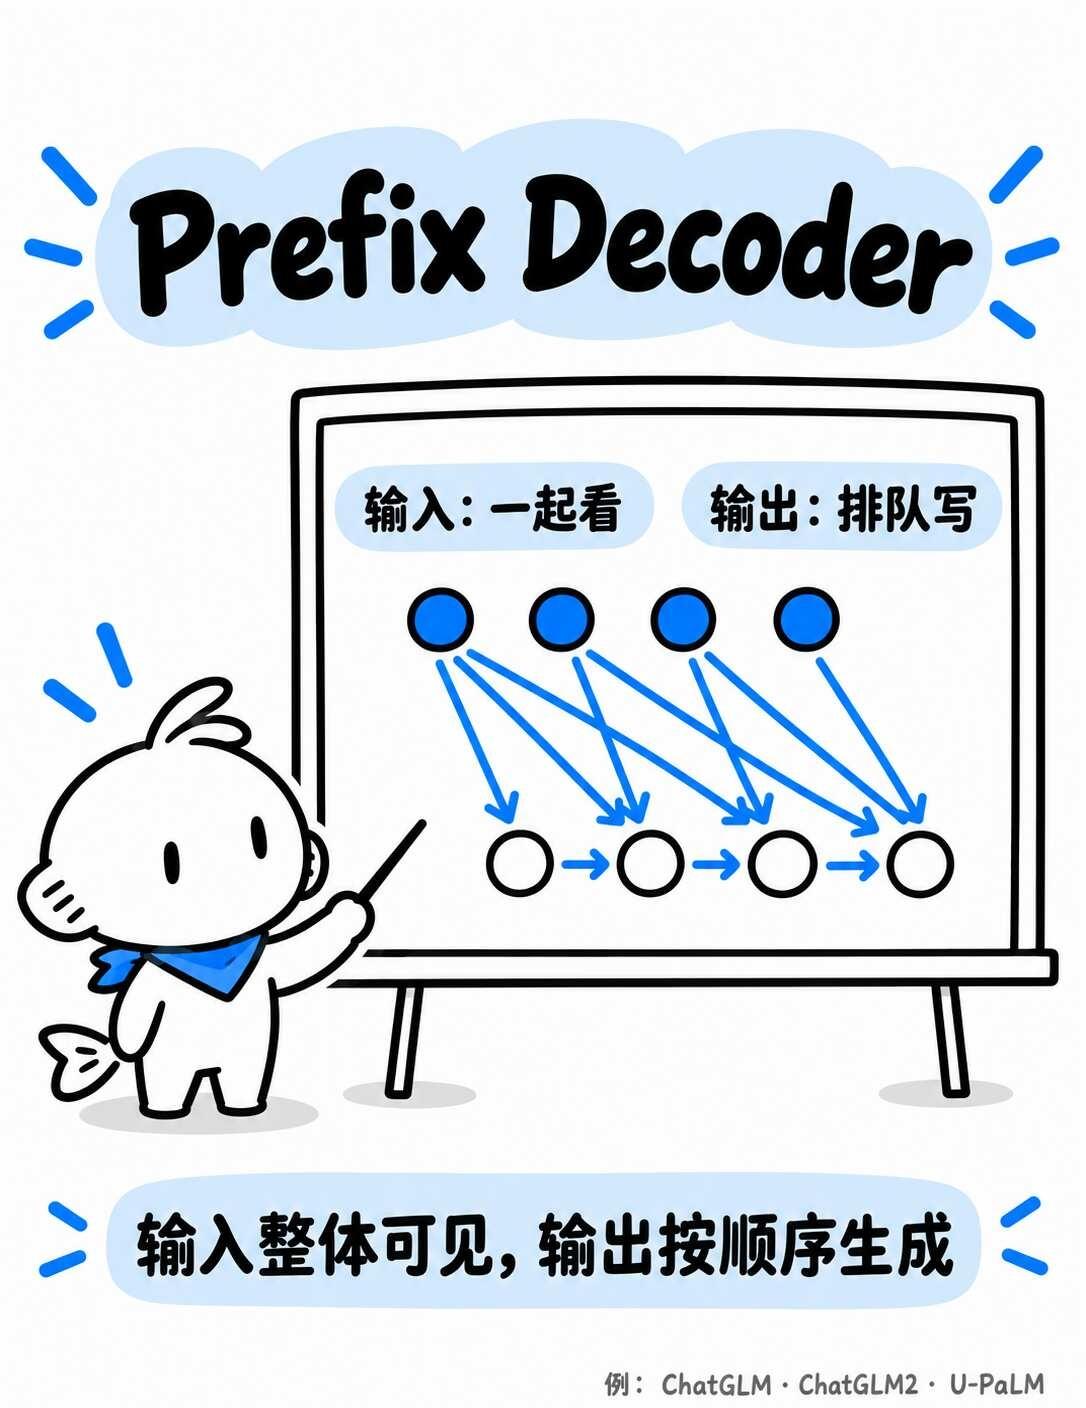
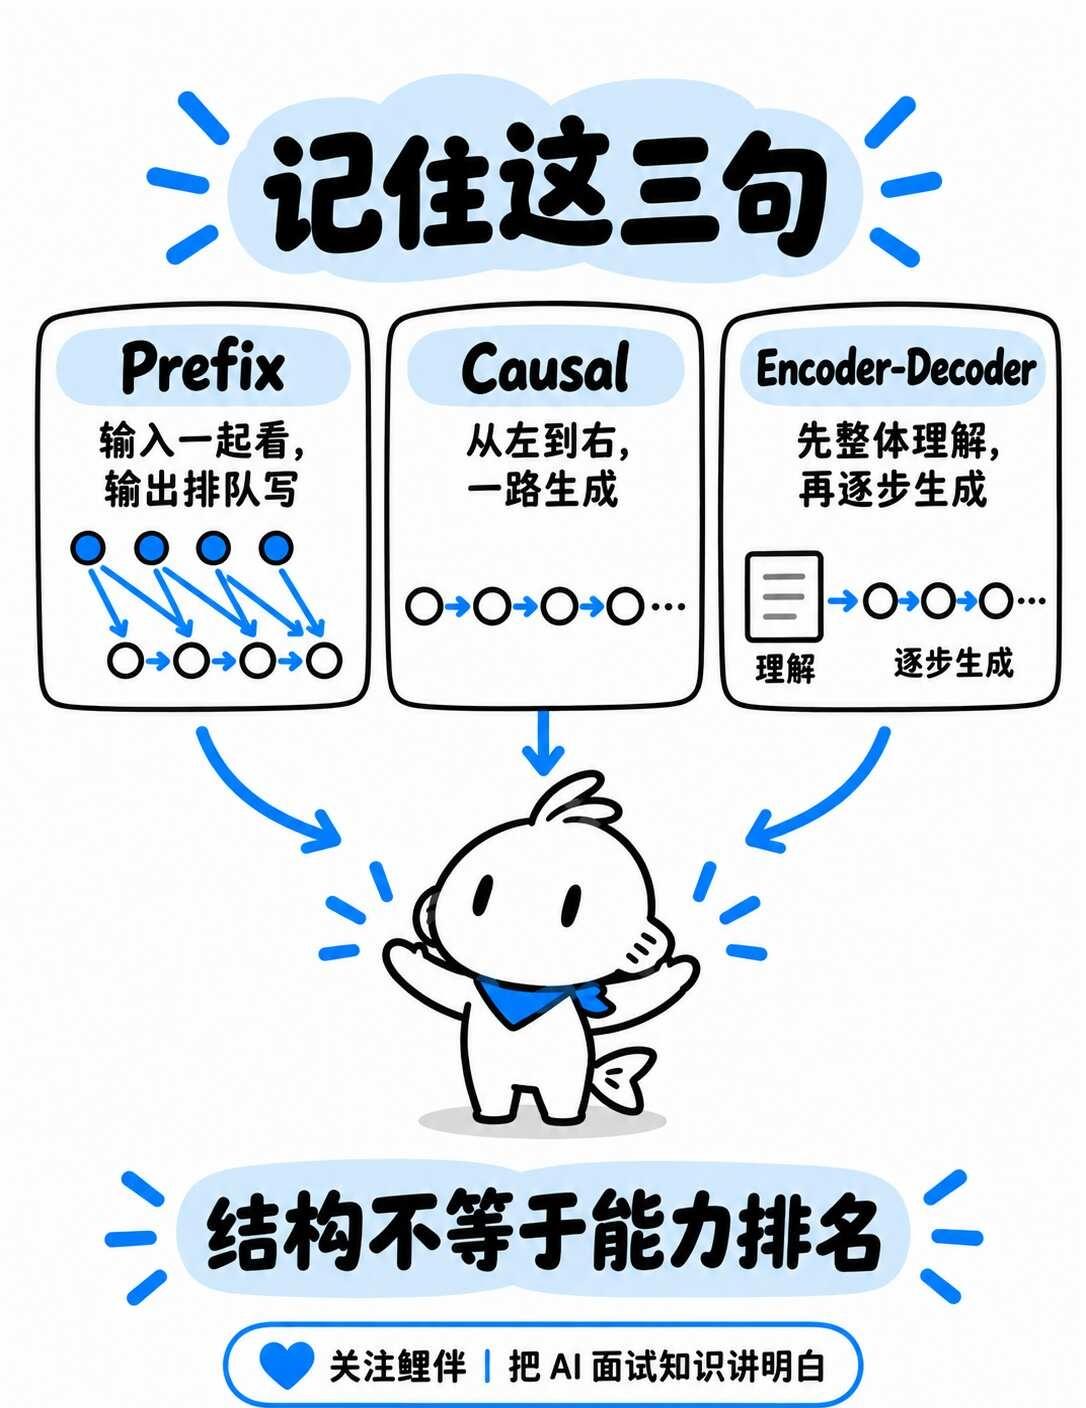
1|Prefix Decoder
输入部分可以双向看,输出部分按顺序生成。
例子:ChatGLM、ChatGLM2、U-PaLM。
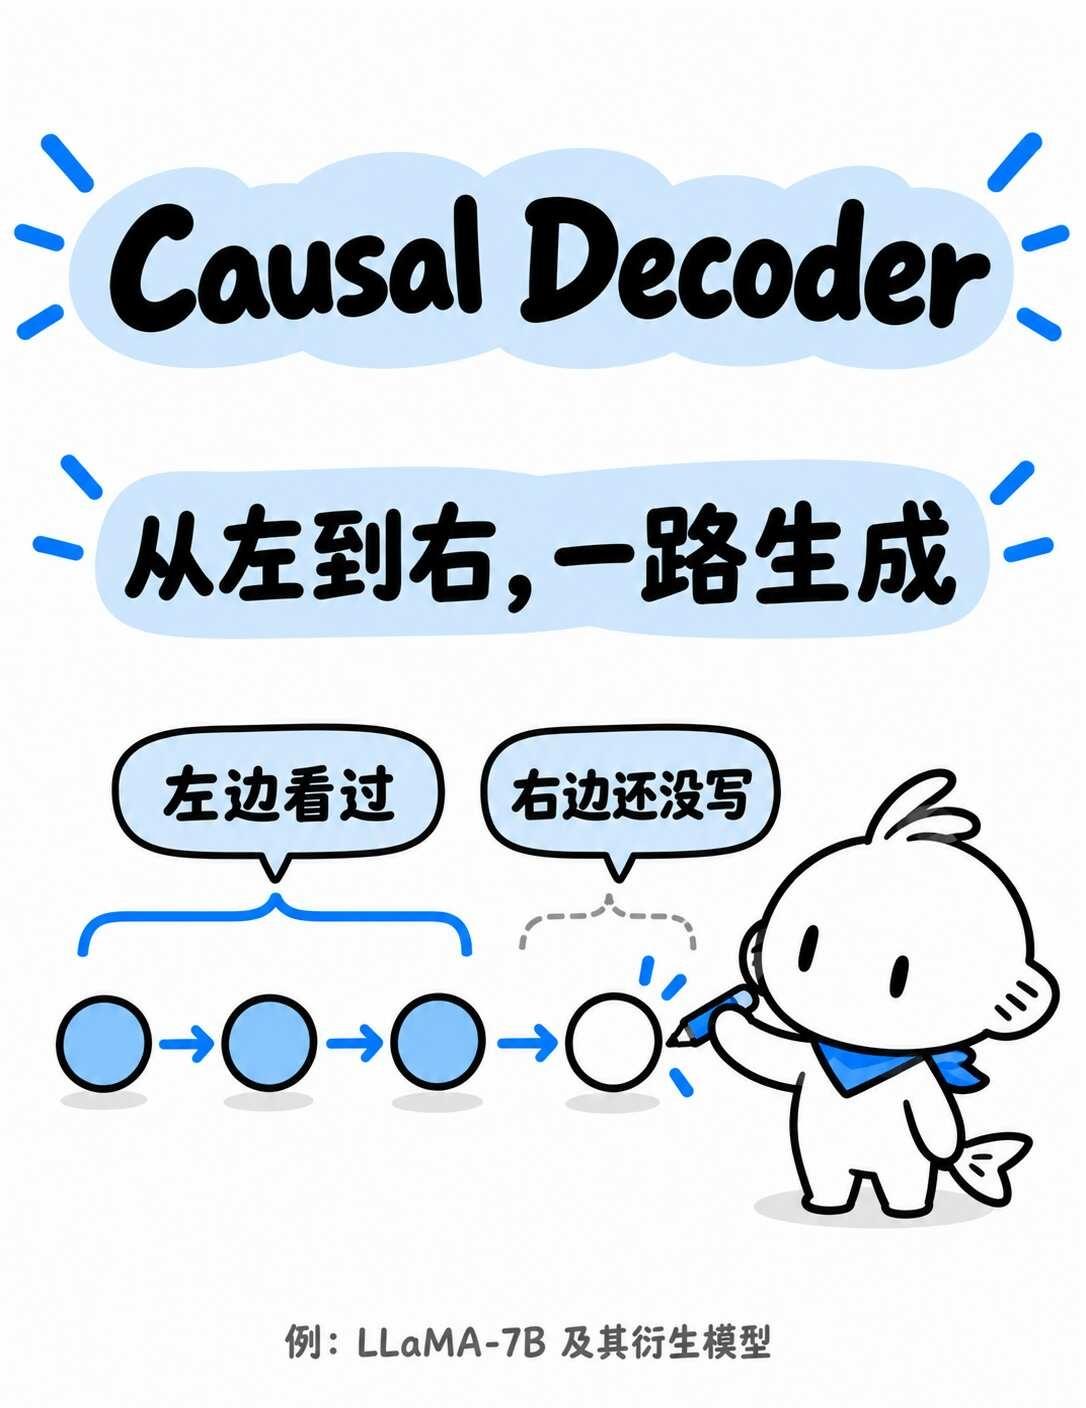
2|Causal Decoder
从左到右逐个生成,当前位置只能利用前面已经出现的内容。
例子:LLaMA-7B 及其衍生模型。
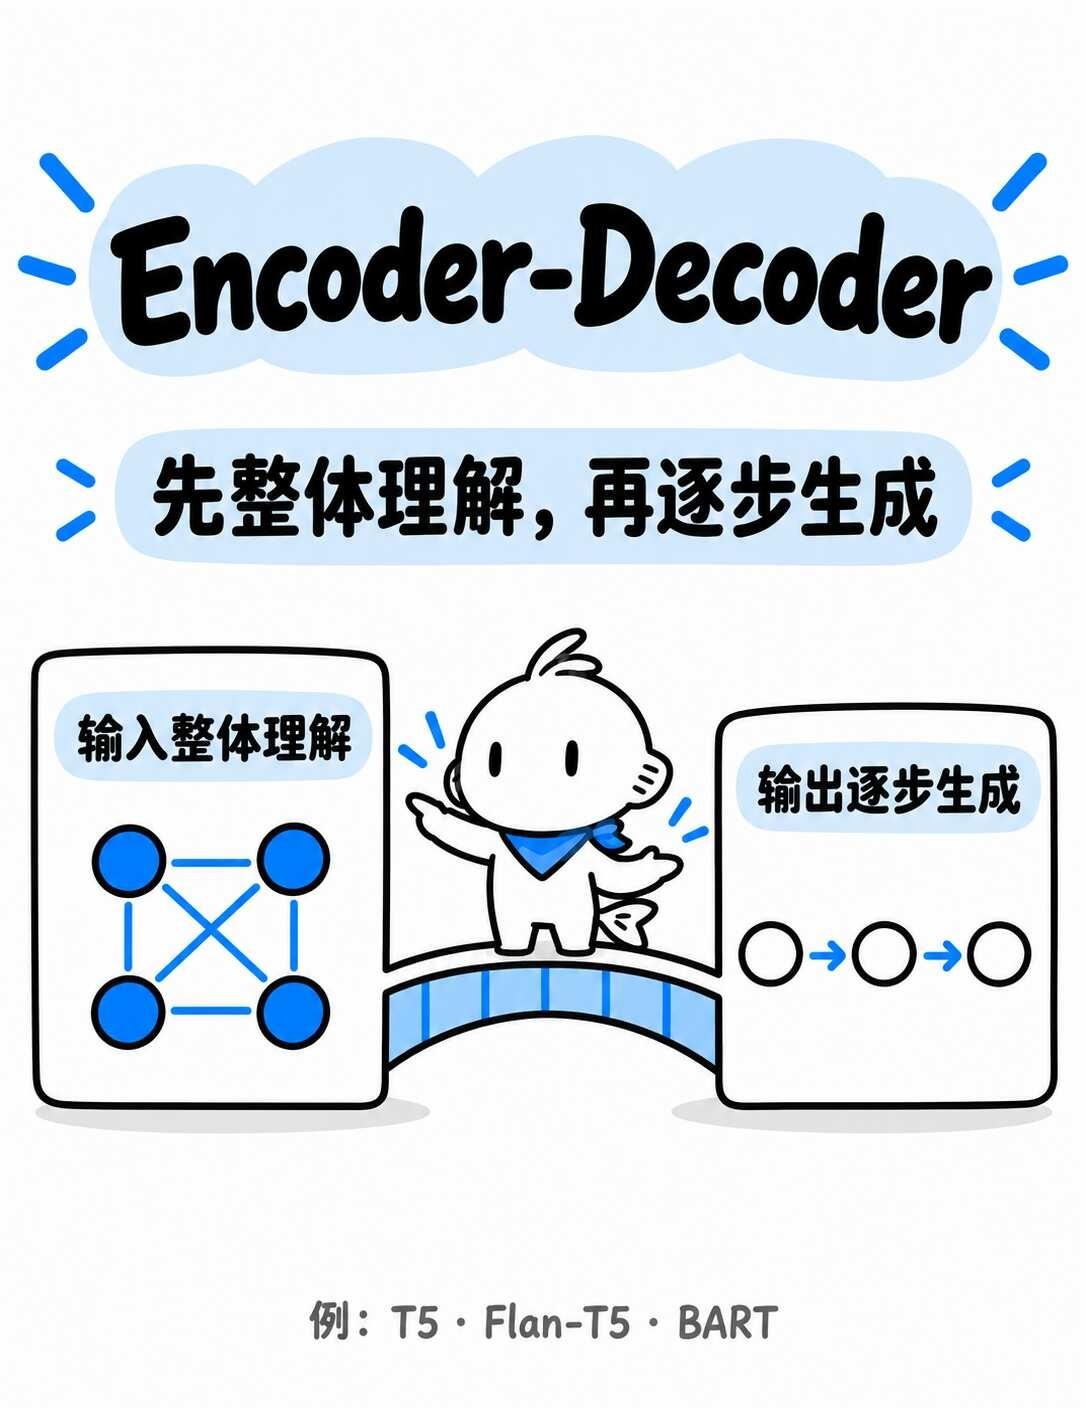
3|Encoder-Decoder
Encoder 先整体理解输入,再由 Decoder 按顺序生成输出。
例子:T5、Flan-T5、BART。
一句话记忆:Prefix 是“输入一起看,输出排队写”;Causal 是“从左到右,一路生成”;Encoder-Decoder 是“先整体理解,再逐步生成”。
注意:结构类型不等于能力排名。真实效果还会受到训练数据、目标函数、参数规模、微调方式和具体任务影响。
关注鲤伴|把 AI 面试知识真正讲明白
AI面试 大模型 Transformer 深度学习 机器学习 自然语言处理