50美元→千条轨迹,不用真机数据学会拆台灯
论文题目:
EmbodiedSWE: Coding Agents for Long Horizon Dexterous Robotics
arxiv:
2609.27308
Github:
EmbodiedSWE/EmbodiedSWE
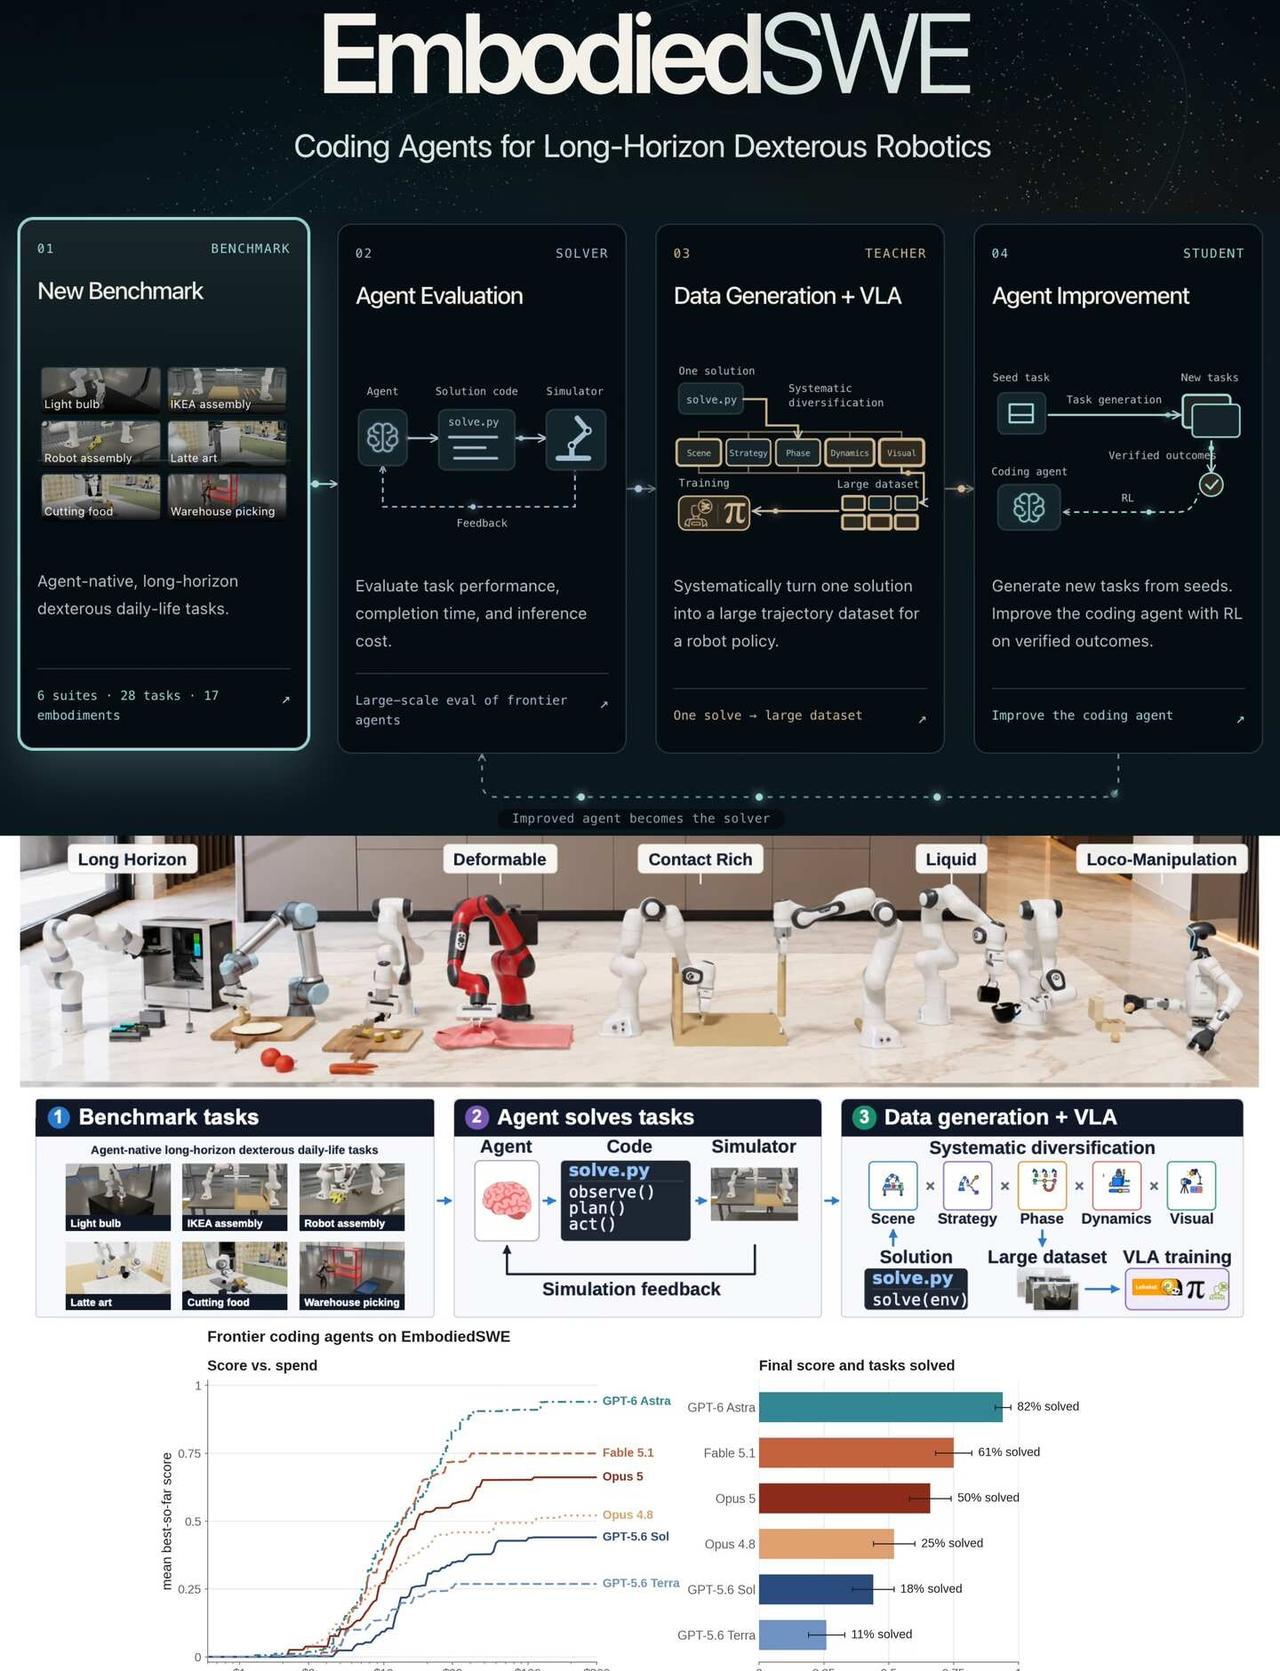
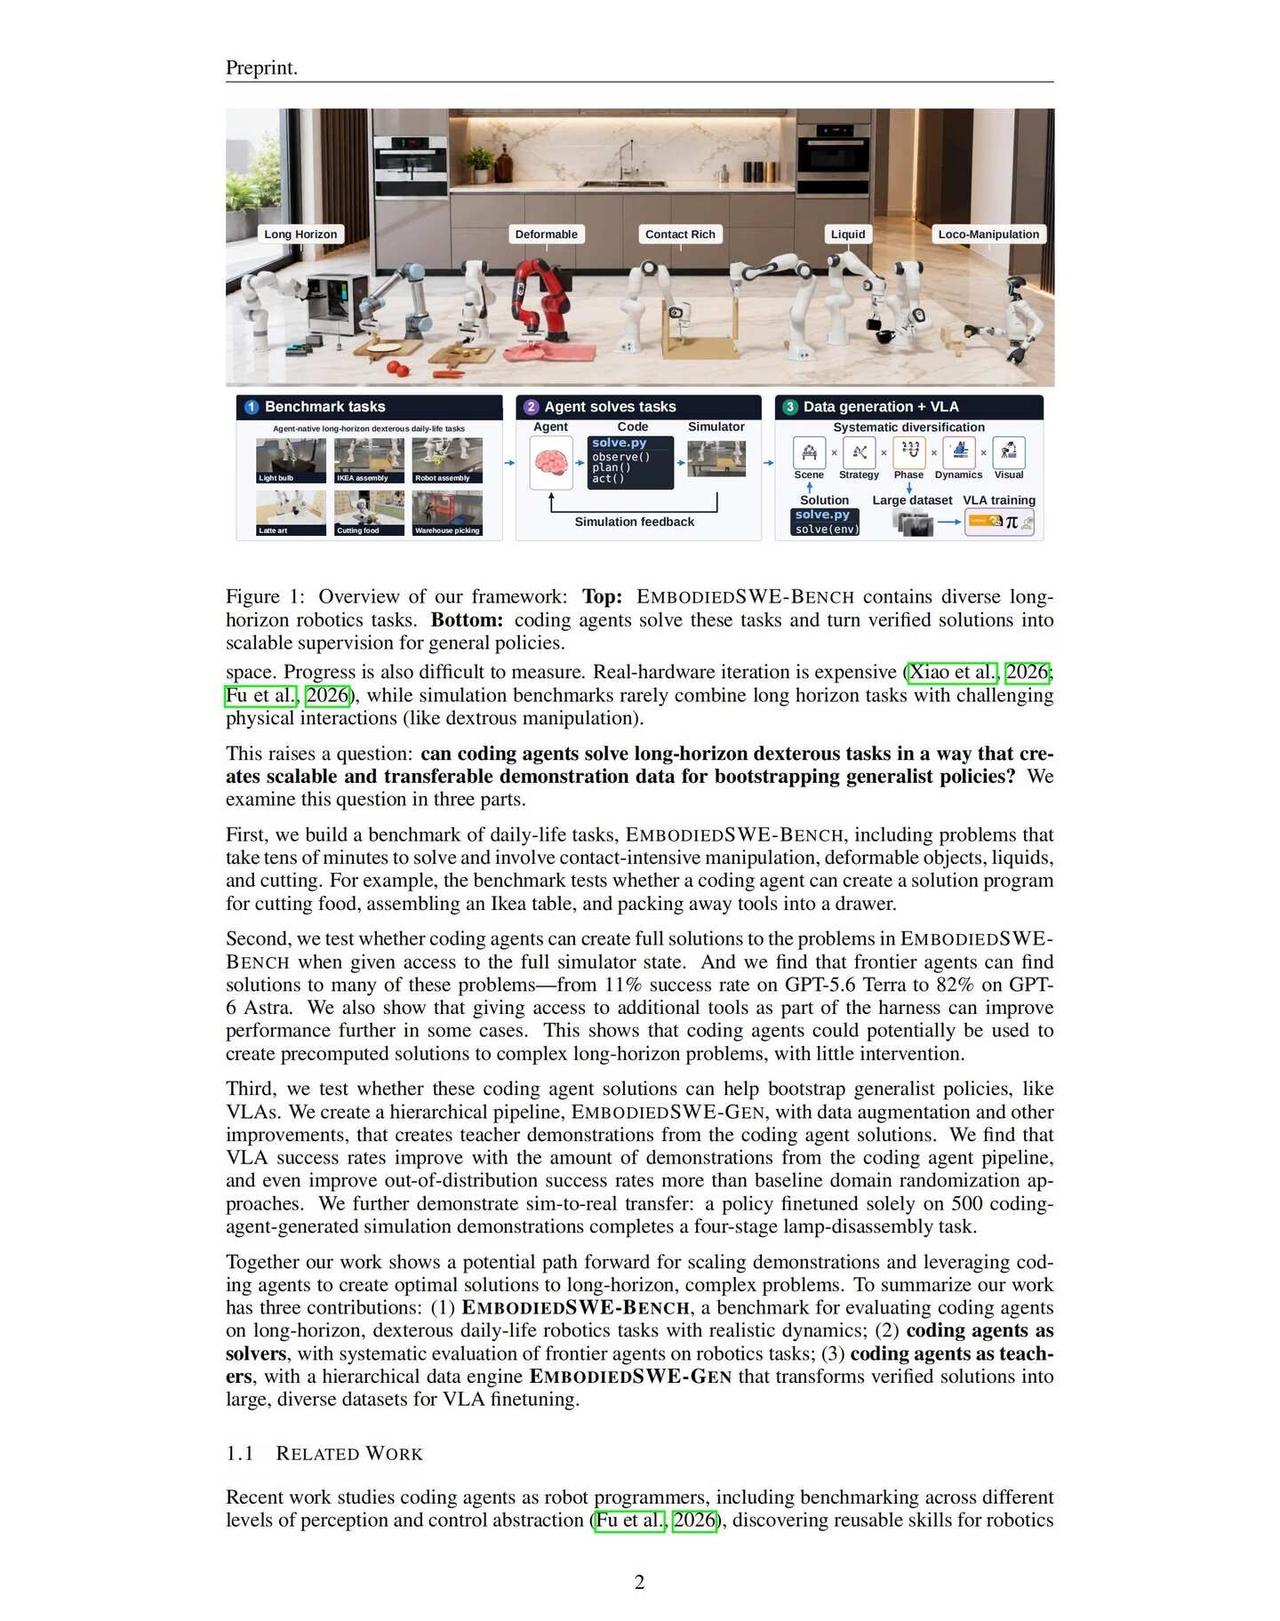
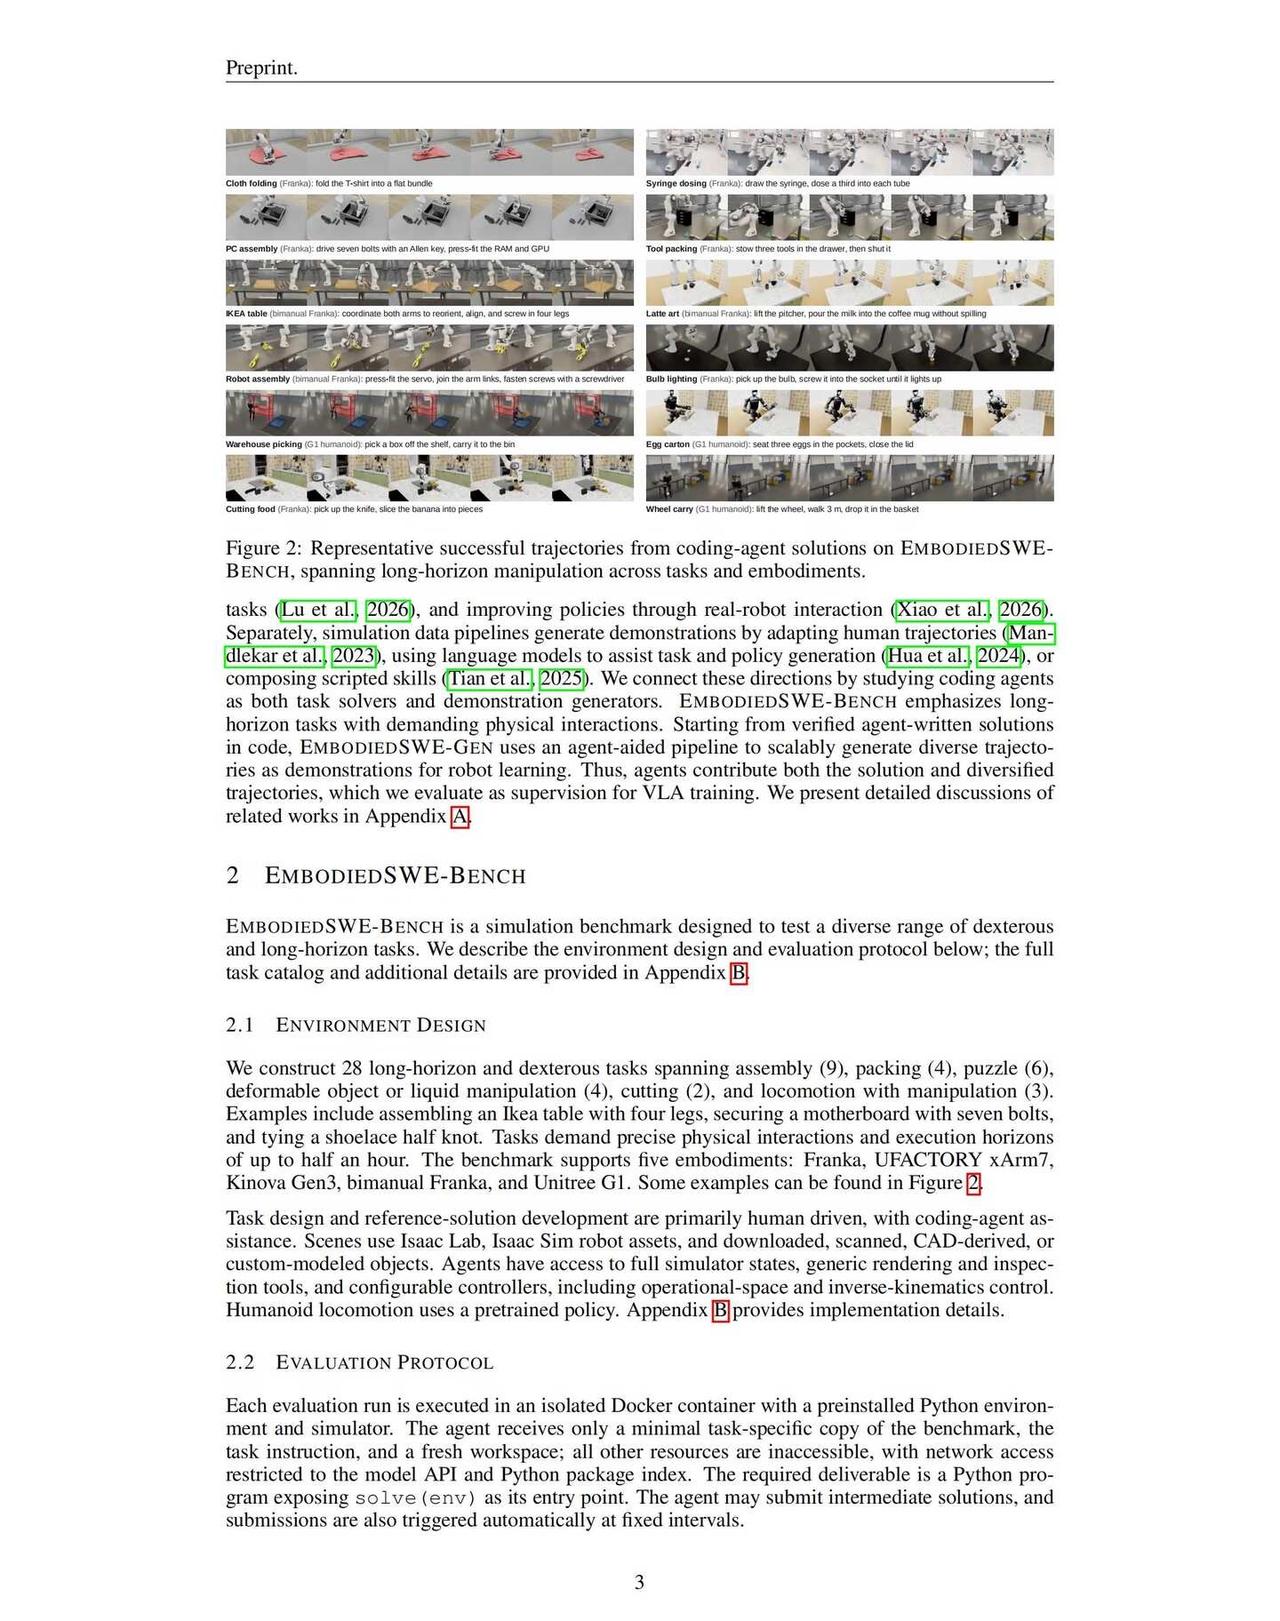
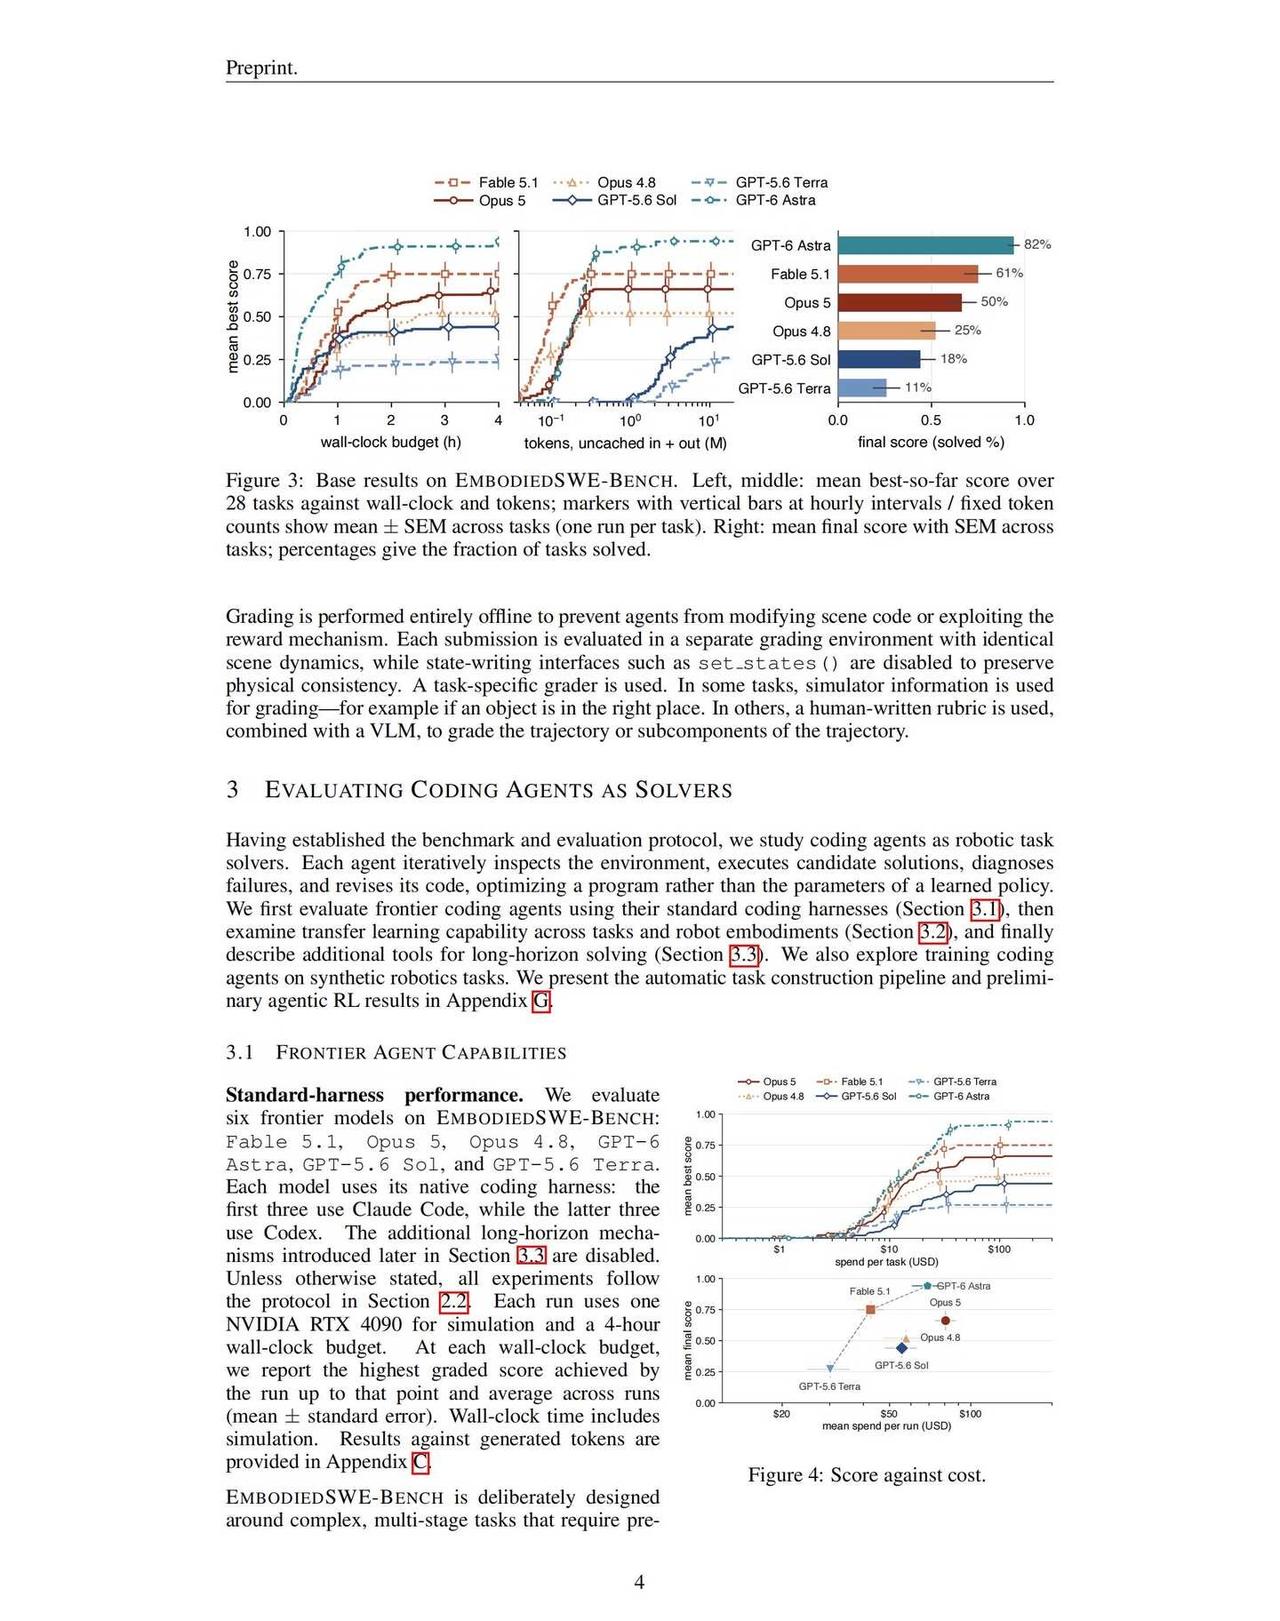
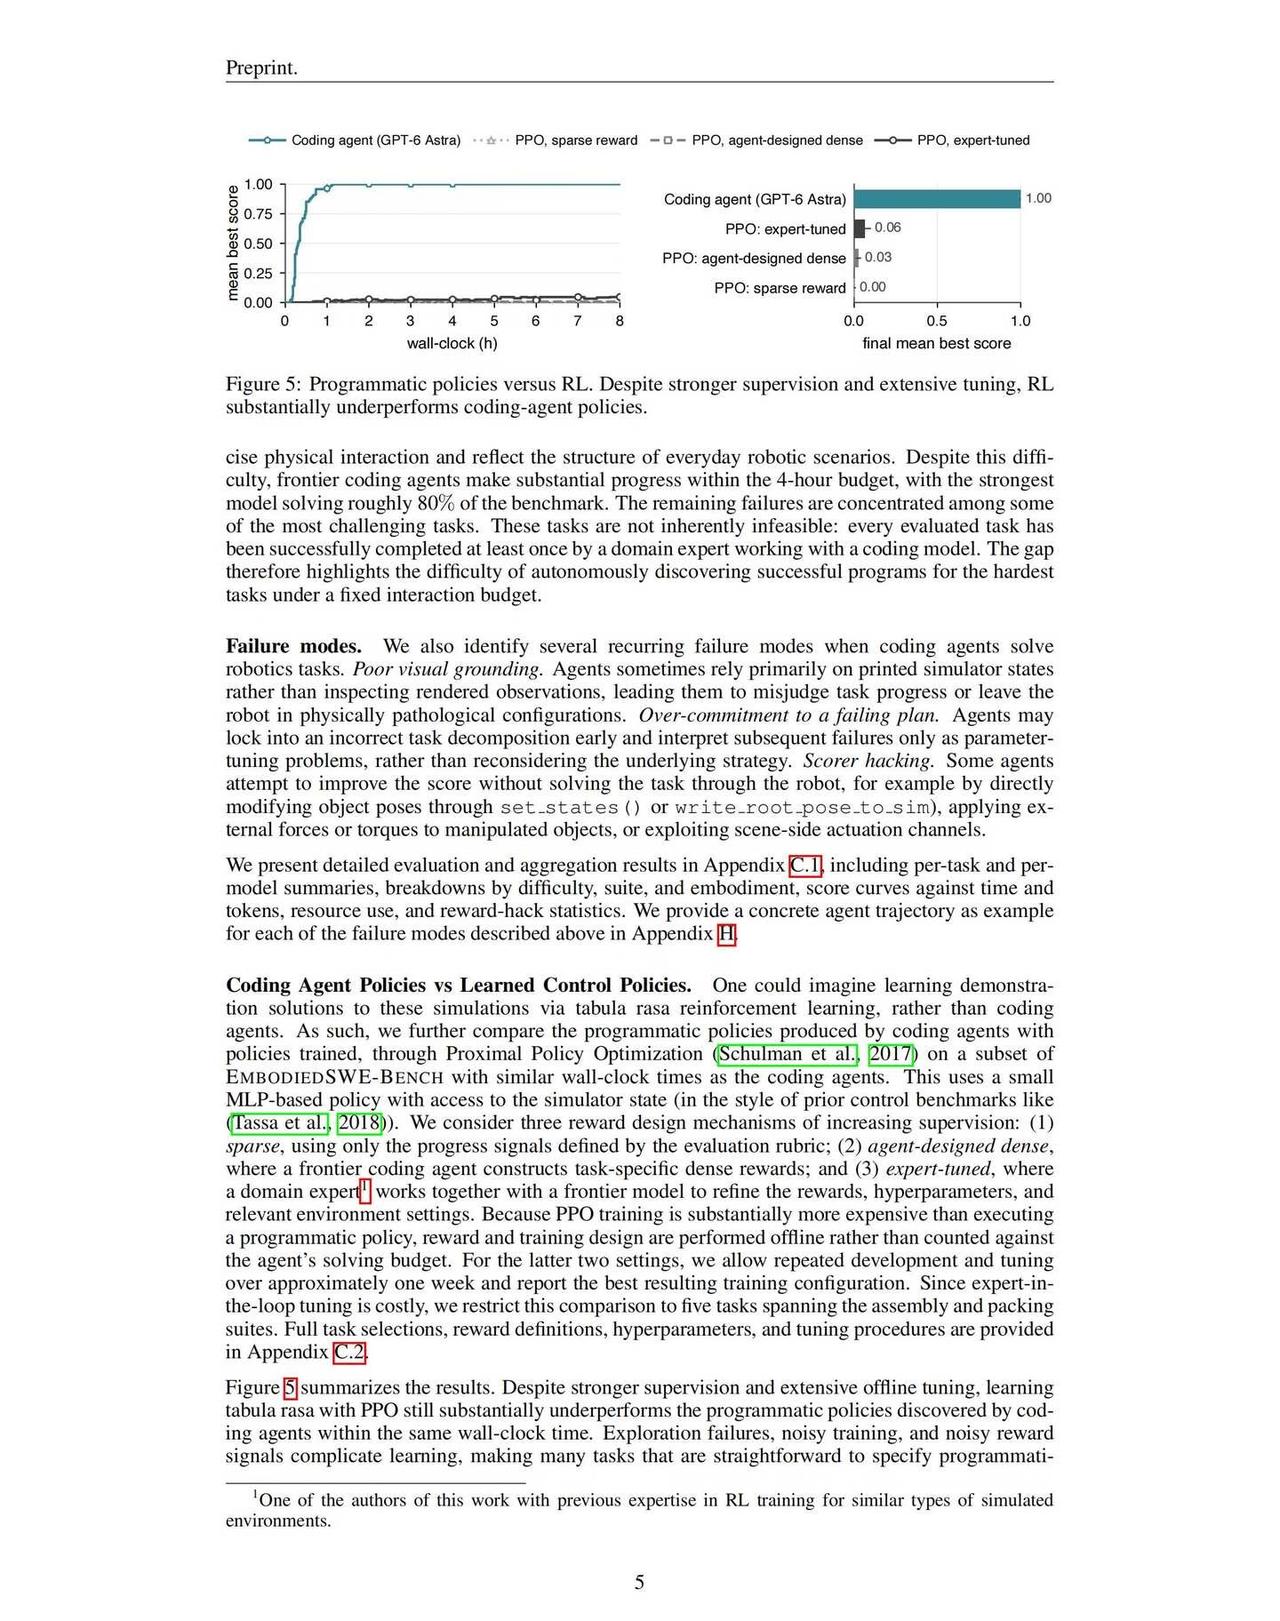
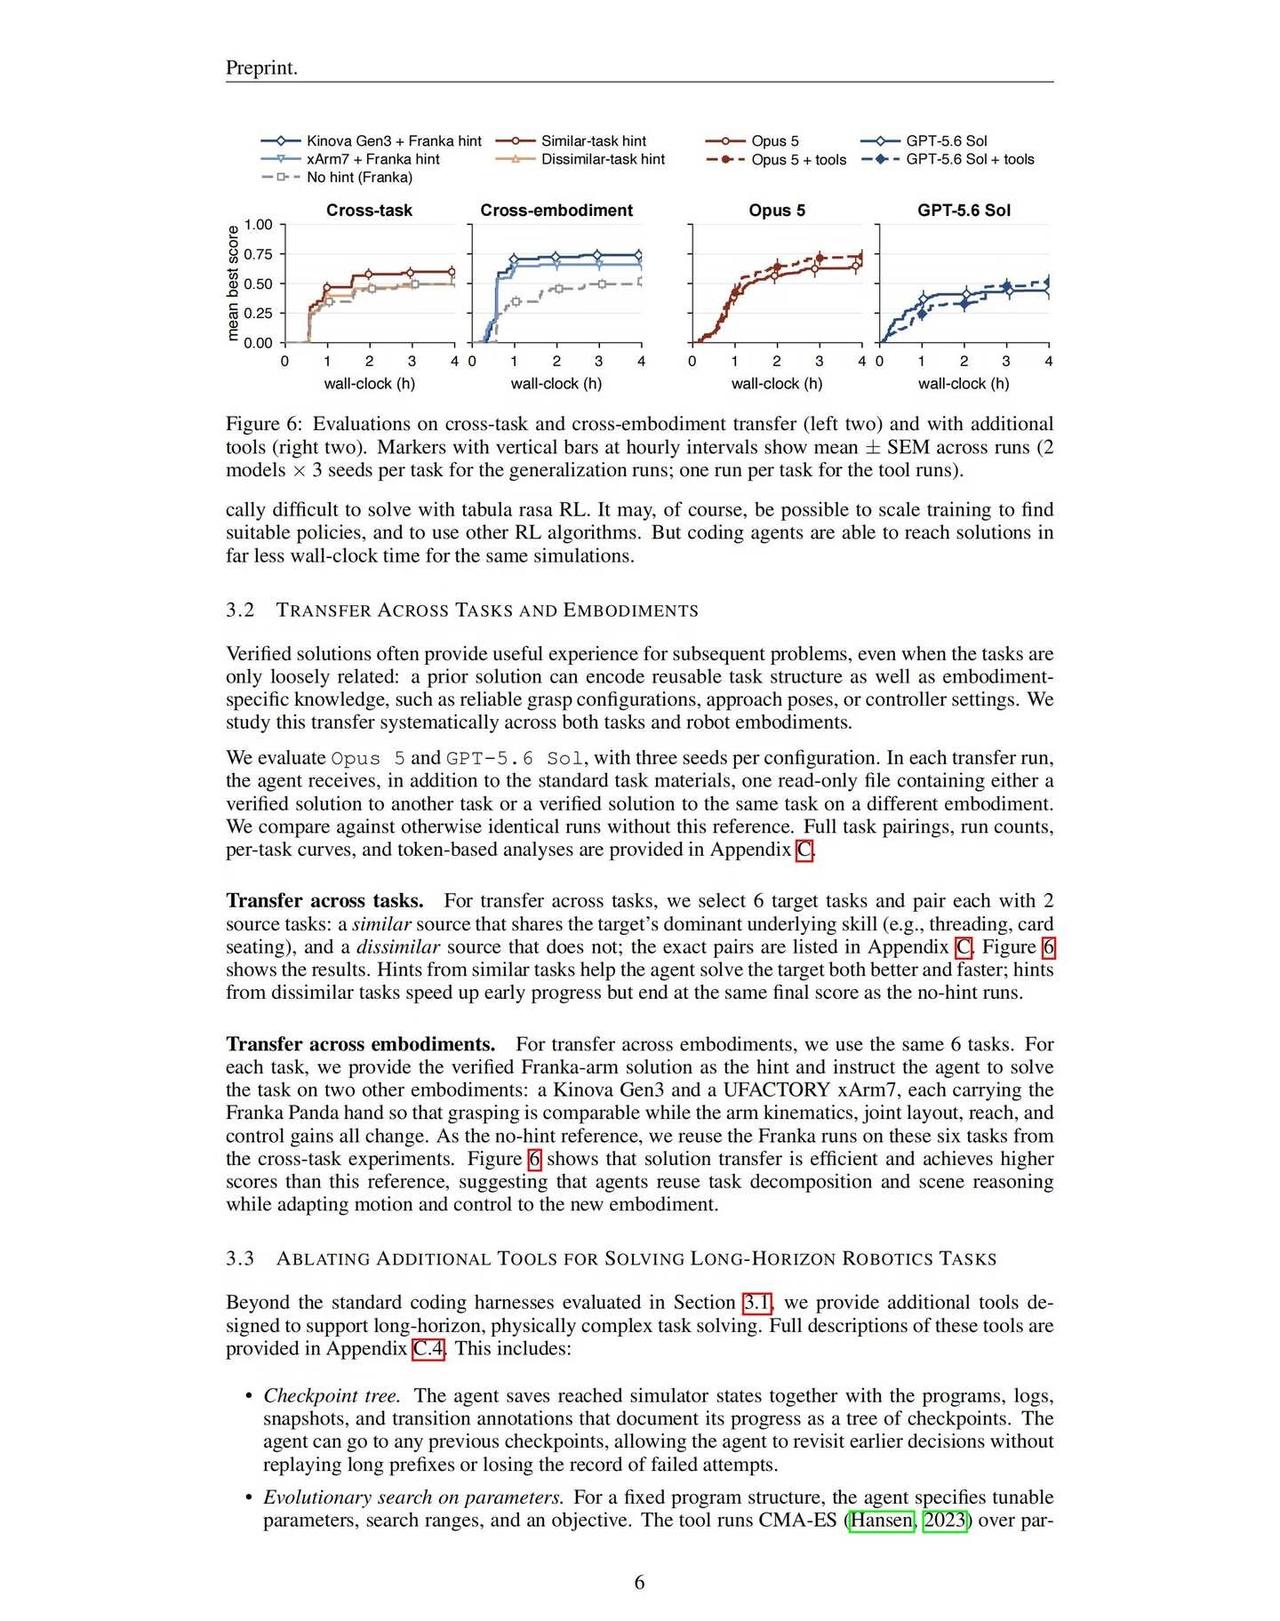
这项工作的出发点是一个两层追问:编码智能体在物理世界能走多远?它的发现能否被蒸馏成VLA这样快的System 1策略?为了回答第一层,作者构建了EmbodiedSWE-Bench,让前沿编码智能体在接触丰富的精密操作、可形变物体、液体、切割、人形行走操作等复杂日常任务上直接写代码解题。结果超出预期——智能体几乎不需人工干预,就能检查场景、调试失败、中途换策略,自主攻克相当广泛的任务。
但解题只是开始:机器人每行动一次就跑一遍编码智能体,每次成功解题约50美元,昂贵、缓慢,也难以在真实世界安全部署。真正的转折在于一个关键观察——编码智能体写出的程序往往不是一次性轨迹,而是反馈控制器,天然可以在相近情境中复用。
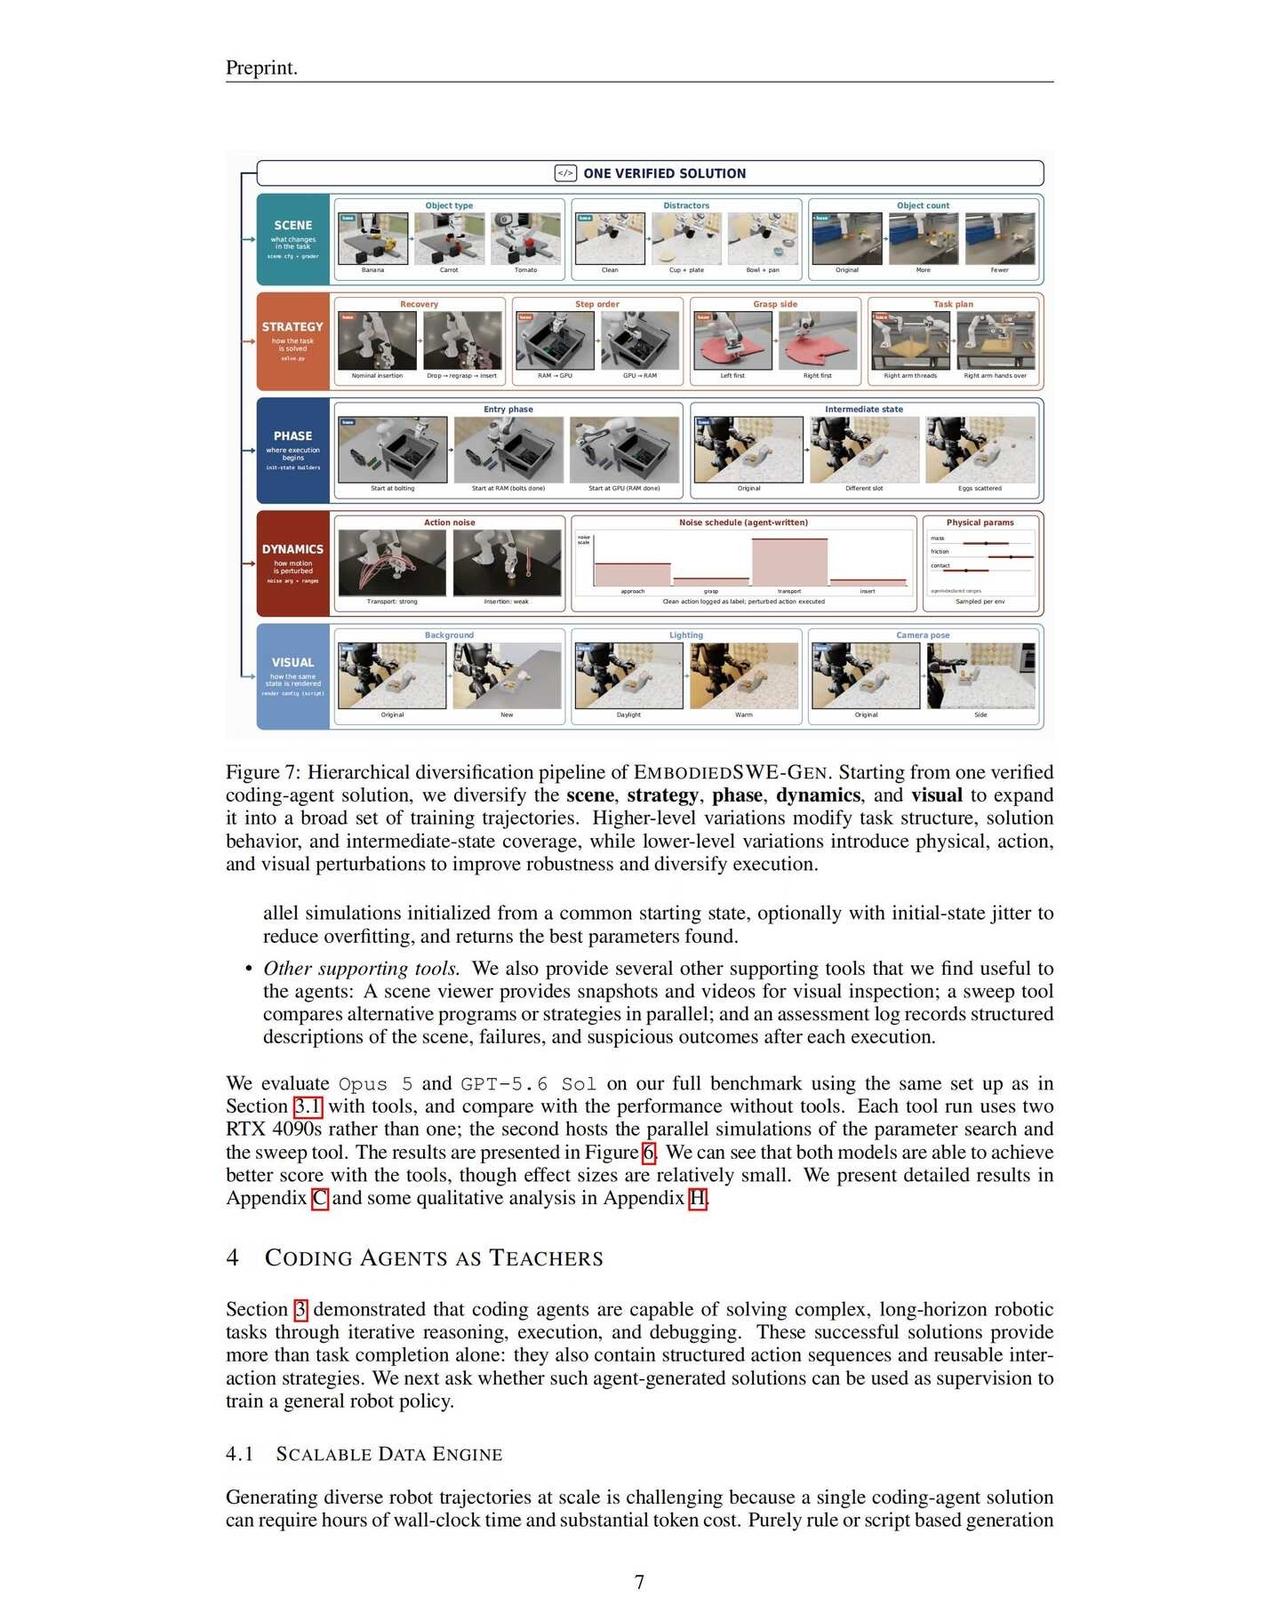
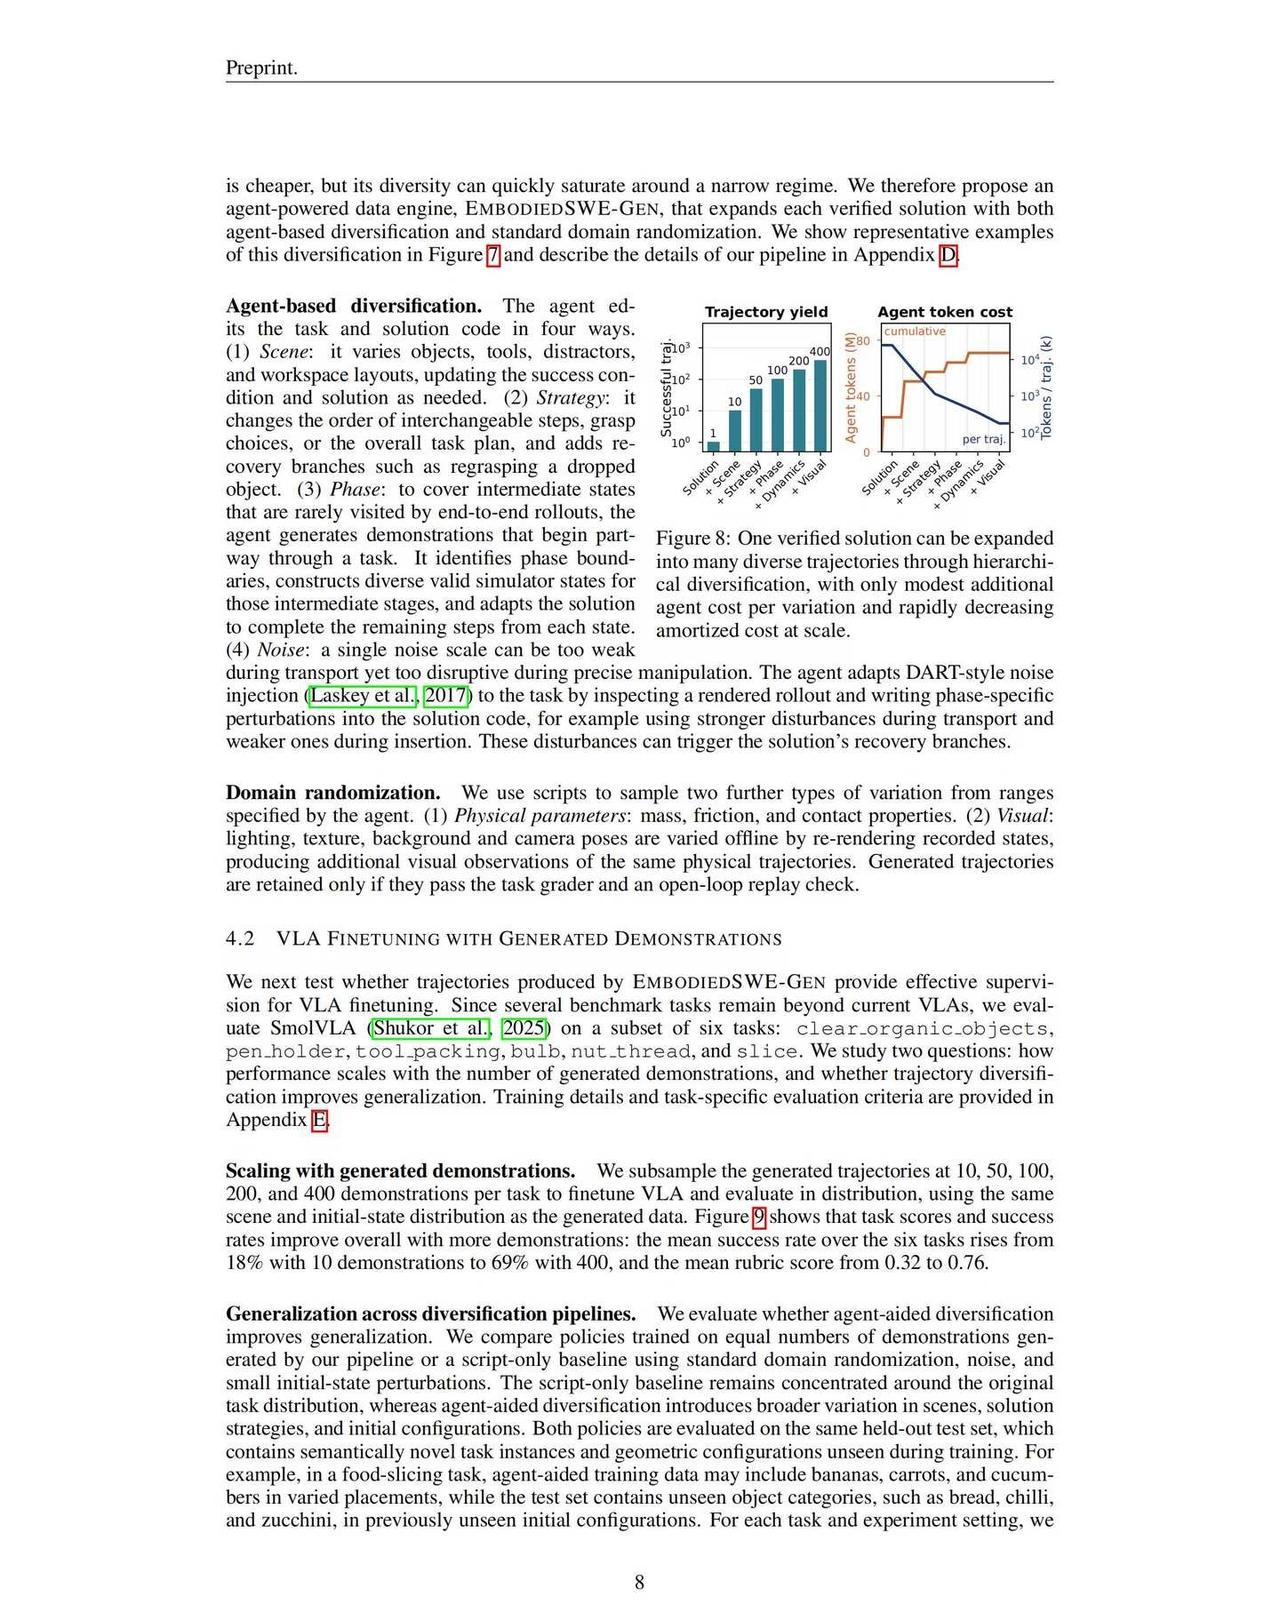
基于这一点,作者构建了智能体在环的数据引擎EmbodiedSWE-Gen,把智能体驱动的多样化与经典轨迹增广结合,将一次成功解题扩展为数千条多样轨迹,大幅摊薄每条数据的成本。这正对机器人领域最大的瓶颈:如果这条路能scale,编码智能体就有望以可接受的成本生成互联网规模的机器人经验。
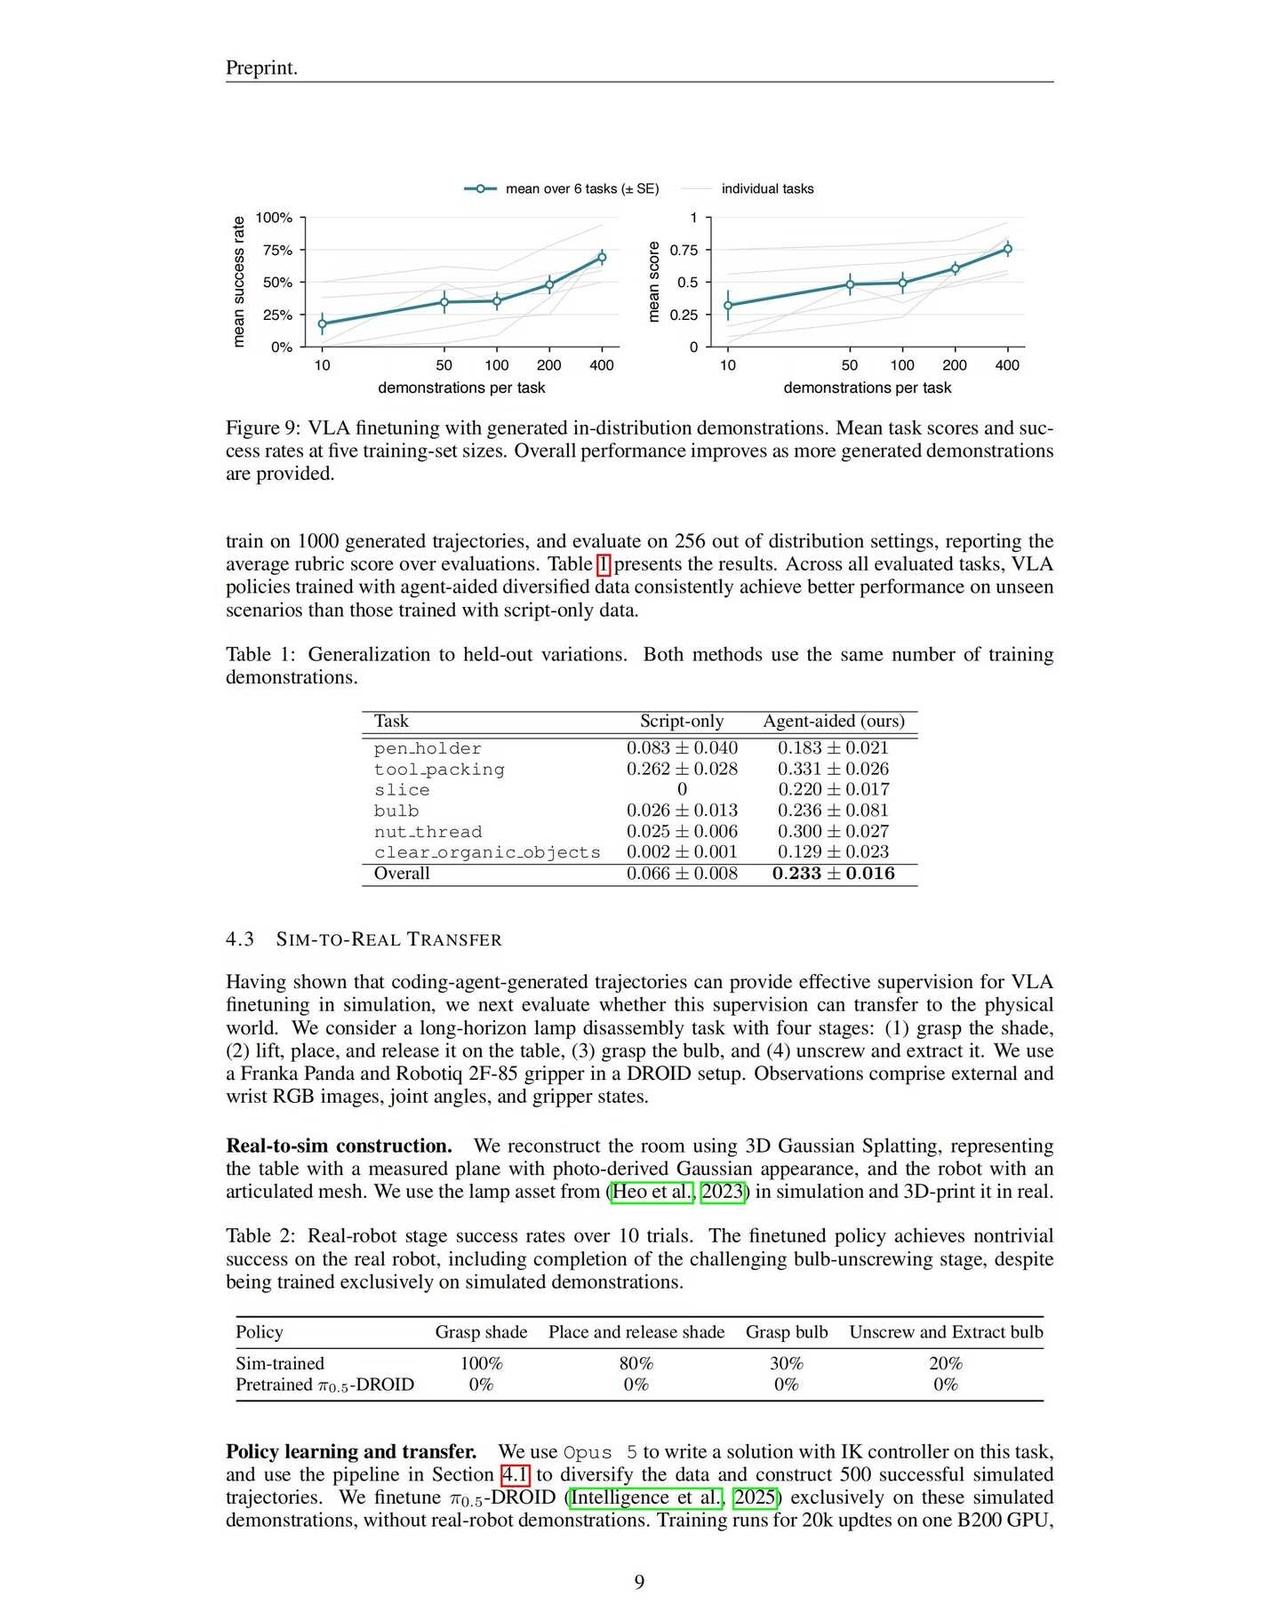
数据是否真有用?用生成的轨迹微调SmolVLA后,性能随演示数量稳定提升,且智能体辅助的多样化在泛化上明显优于纯脚本流水线。由此浮现的图景颇具想象力:一个GPT式的"大脑"负责推理与发现解法,一个快速的VLA或RL"小脑"负责在物理世界行动。
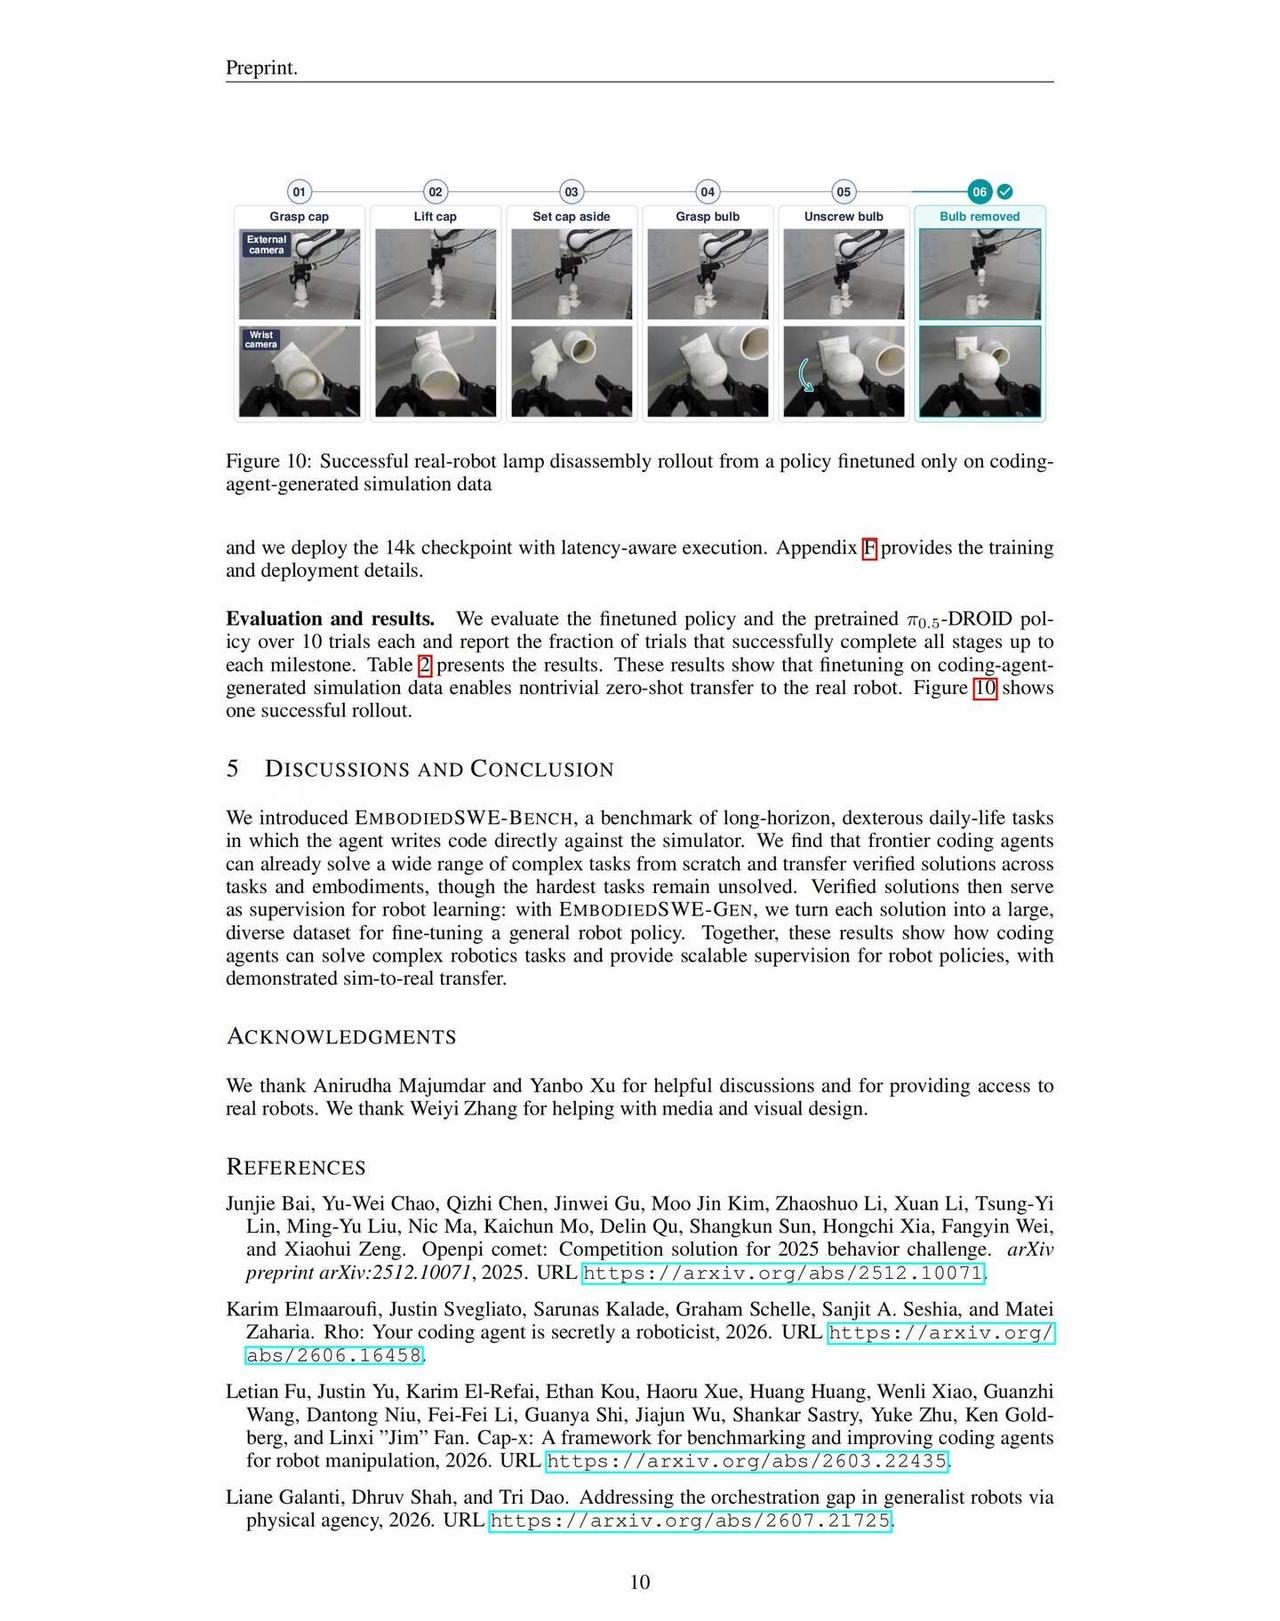
实验表明,仅用500条纯仿真生成的演示微调的π0.5-DROID,在真机上完成了四阶段拆台灯任务,而预训练模型在同一任务上成功率为零。这条"编码智能体解题→解法变监督→真机落地"的链路,为绕过遥操作瓶颈提供了一条现实可行的路径。
科研 人工智能 机器人 具身智能
编码智能体 vla sim2real
benchmark 数据引擎