从Jev看浏览器使用新思路
博主最近在继续学习 Jev 的应用场景,然后也学习了大魔王老师的Browser use的内容,正好结合起来,讲讲浏览器控制和Jev带来的增量。一句话概括就是Browser Use 把浏览器自动化从固定脚本推进到运行时决策,模型去思考决定下一步该执行什么操作,然后Jev 又把部分开放式生成压缩成受限选择,这是一个很有趣的组合应用。这篇文章我会先介绍通用运行机制,再拆解 Jev 的决策优化和屏幕控制方式,最后简要分析业务选型、可靠性和落地条件。
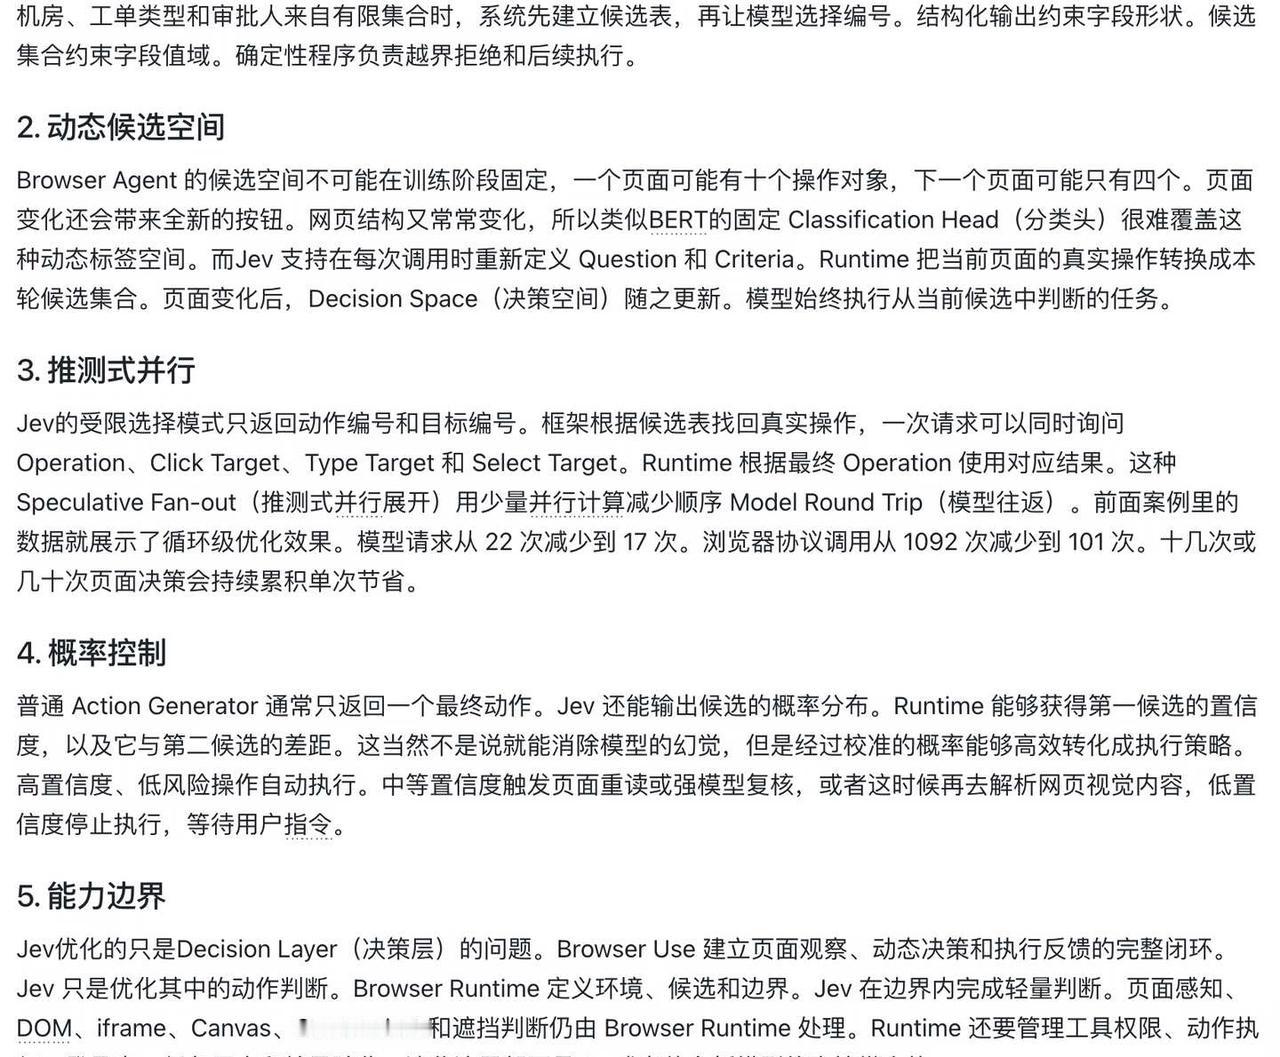
参考案例: 9 月 17 日,Browser Use 团队开源了 jev-ultrafast。这个项目公布了一组 Google Flights 测试结果。一次订票任务,中位耗时从 9.45秒下降到 7.09 秒。模型请求从 22 次减少到 17 次。浏览器协议调用从 1092 次减少到 101 次,降幅达到 91%。这数据可以说非常惊人了,当然,这个功劳其实主要在于浏览器runtime的改善,不是Jev一个模型就带来的颠覆。
一、浏览器控制基础
1. 页面节点
首选,我们需要介绍最基本且重要¥的概念:DOM(Document Object Model,文档对象模型)是浏览器解析 HTML 后形成的结构化对象树。用户看到完整网页,浏览器处理具有层级关系的节点。按钮、输入框、链接、文本和下拉框都对应具体节点。点击、输入、滚动和选择等操作最终也会落到节点上。传统手段例如Selenium、Playwright 都需要我们开发者提前定义元素定位方式和执行路径。定位信息包括 CSS Selector、XPath、ID 和 Class,也包括更稳定的 Role、Label 和文本。当然,现在的浏览器自动化已经能够适应部分 DOM 变化。但是作为开发者,我们还是必须要提前规定页面状态、元素定位方式和流程分支。如果网页结构发生变化,哪怕我们纯用户视角可能没看出差异,但是代码就得重写。说起这个传统手段,这还是我入门vibe coding和agent的来时路哈哈,只不过现在博主已经完全不会了。
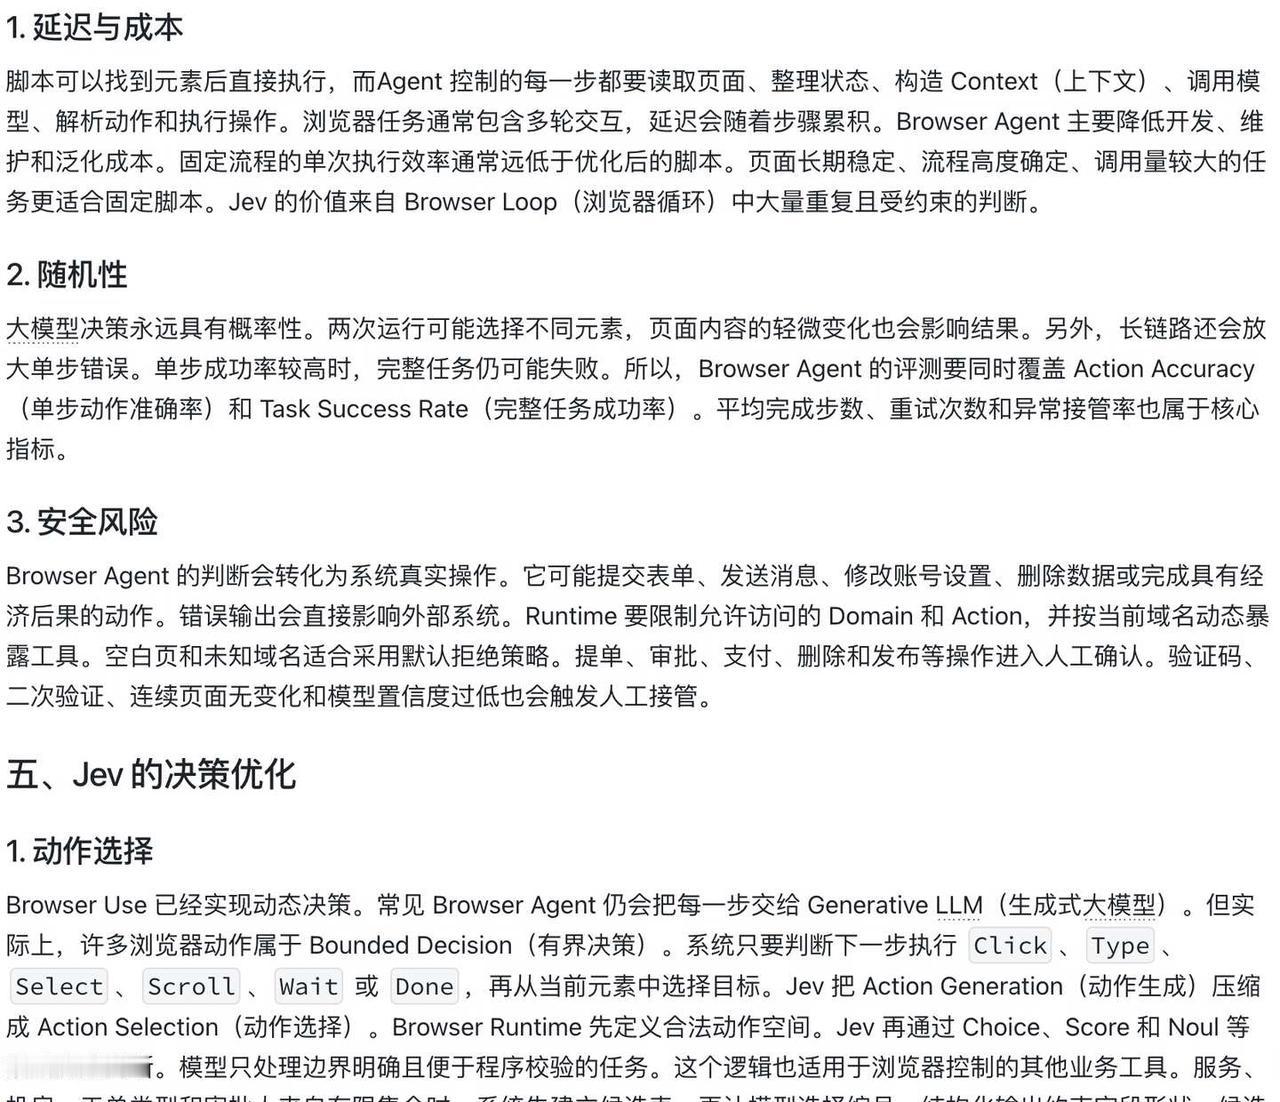
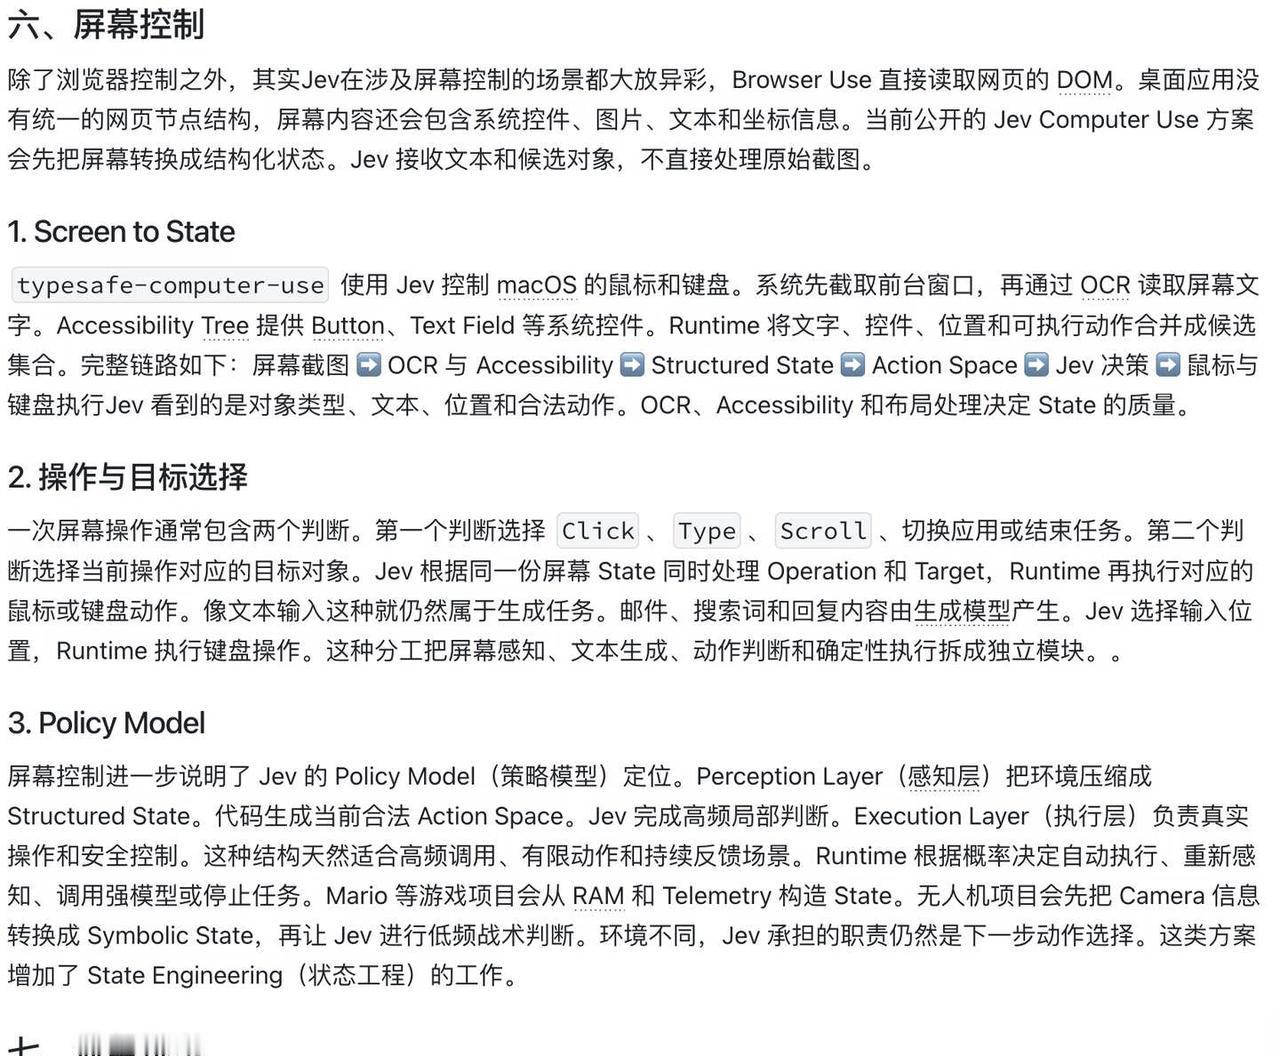
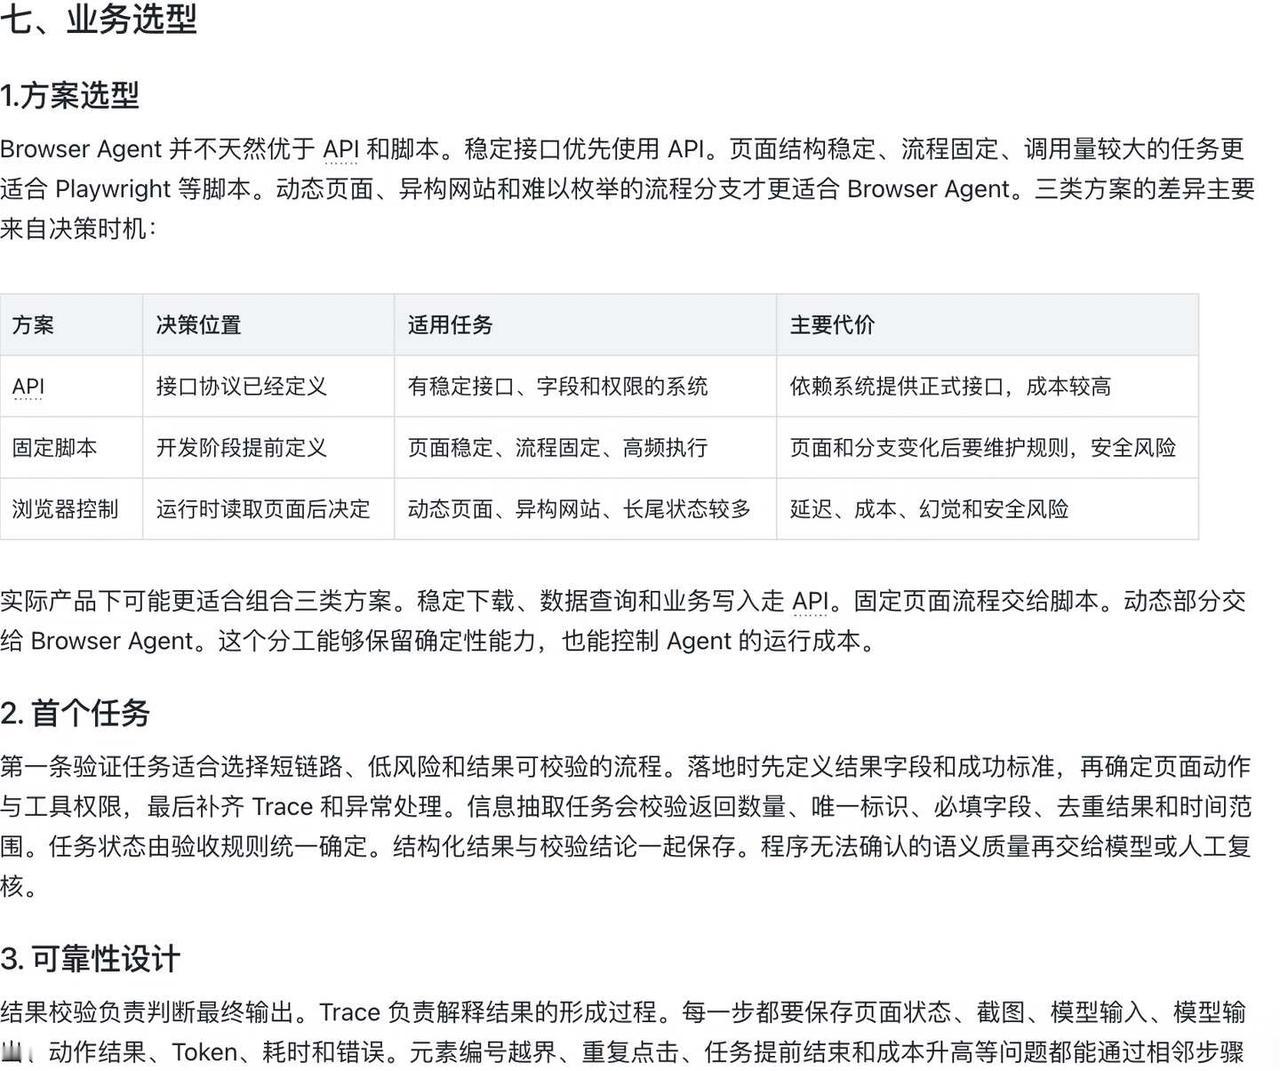
总结来说:Browser Use 把浏览器自动化推进到Runtime决策。页面状态压缩、语义定位、动态动作空间和反馈闭环提高了系统对动态页面与长尾状态的适应能力。这套方案也带来了延迟、成本、概率性和安全风险。然后Jev 进一步收缩模型的决策范围。Runtime 先定义合法候选,Jev 再完成受限选择。概率输出还能驱动执行、复核、升级和终止策略。页面感知、工具执行、权限控制、Trace 和结果验收仍由 Browser Runtime 承担。
howto用好AI AI产品经理 实习 大模型 agent Jev