今天 AI 圈这条,我觉得比很多大新闻都值得看。
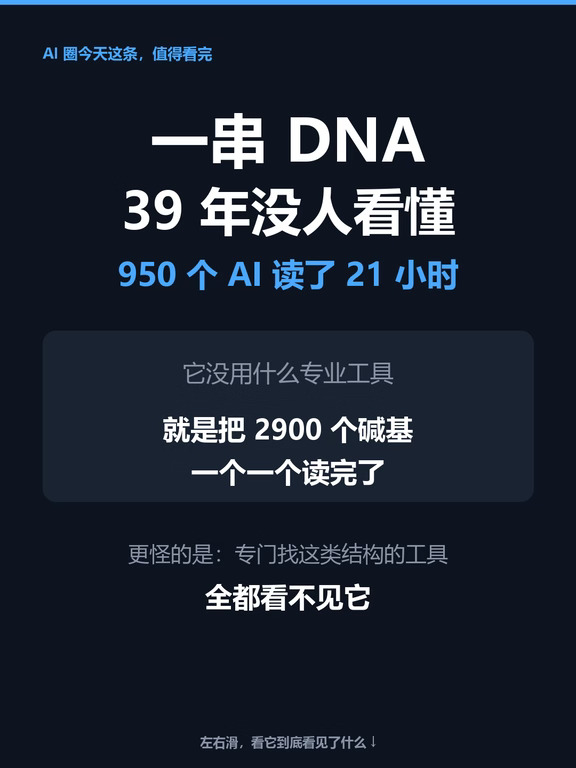
Anthropic 说,它家模型找到了一个此前从没被完整描述过的酶系统,取名 ART。
大约 950 个 AI,接力跑了 21 个小时,翻检了 19.4 亿个蛋白簇,最后交了 19 份报告。
但最打动我的不是这个规模,是它到底怎么看见的。
任务里压根没让它找重复序列,它要的是「搭档蛋白」。 线索来自一个被它自己否掉的候选——它发现有个未知基因,深挖之后发现不过是噬菌体自己的酶,就把这条否了。
但它转念想了一件事: 噬菌体身上带着一个像 retron 的酶,这事本身就不对劲。
于是它顺着往上查,读到上游一段 2900 个碱基的原始序列。它没调任何工具,日志里就记了一句话: 「一眼就能看出存在串联重复。」
然后它开始怀疑自己。 自己写脚本数出 14 个重复序列,又跑去查文献,想推翻自己的判断。 推翻不了,才交给人类。
——
那为什么 39 年没人看见?
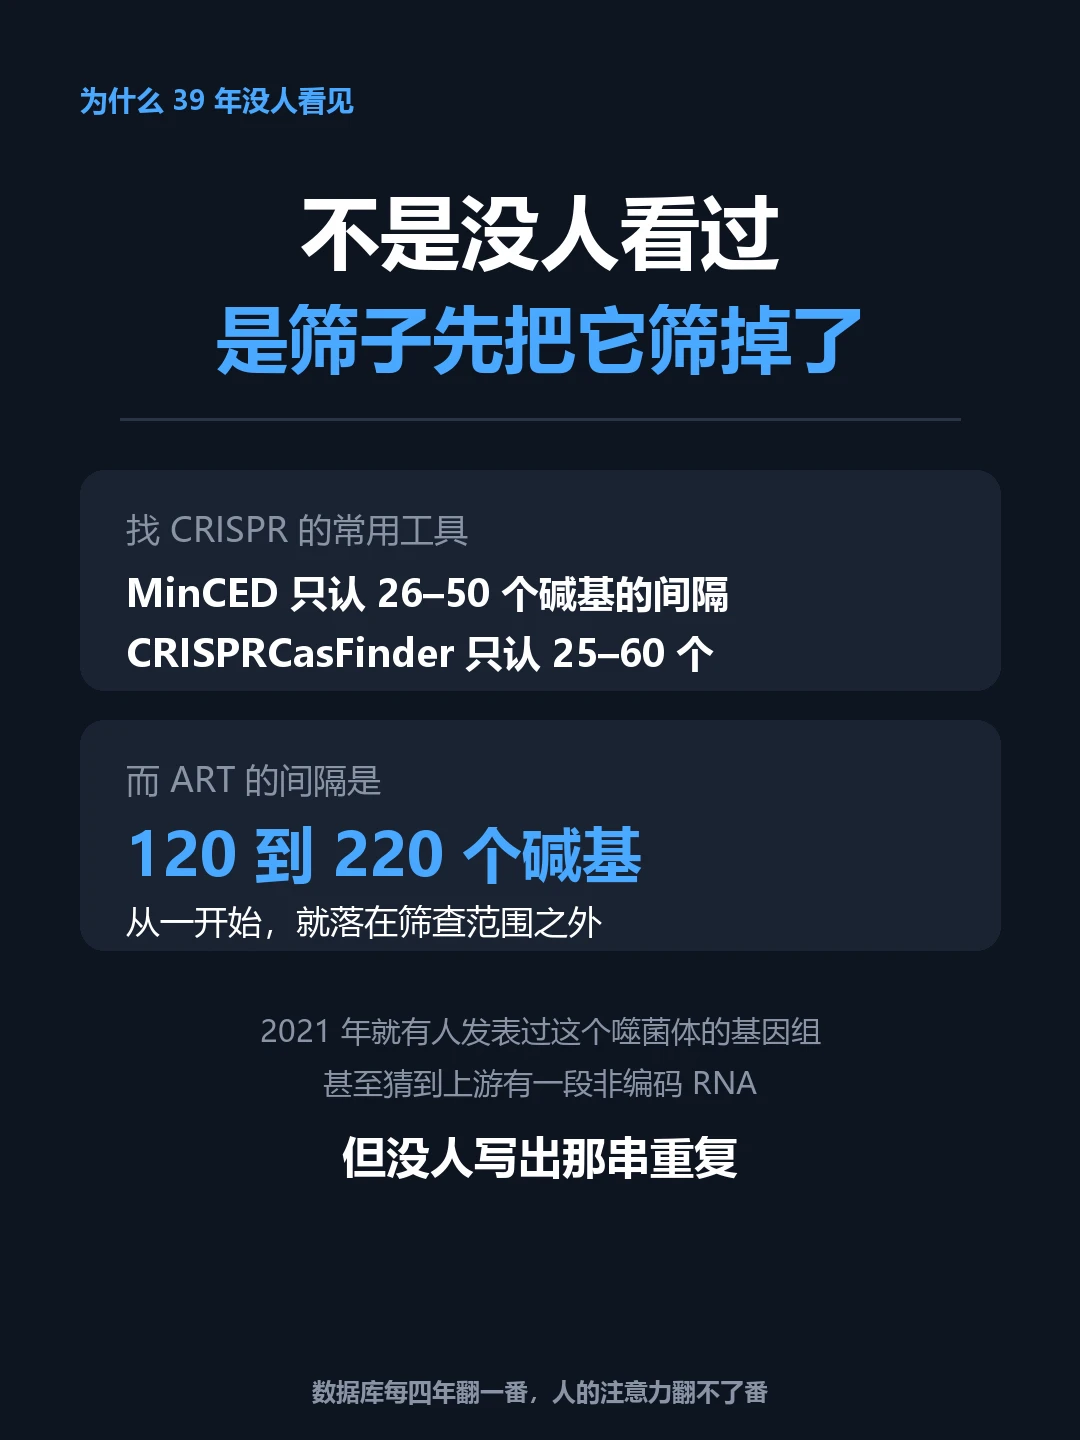
不是没人看过。 2021 年就有人发表过这个噬菌体的基因组,甚至猜到上游有一段非编码 RNA。 但没人写出那串重复。
原因有点荒诞: 专门找 CRISPR 这类阵列的工具,参数是按 CRISPR 的尺寸设的。 MinCED 只认 26 到 50 个碱基的间隔,CRISPRCasFinder 只认 25 到 60 个。 而这段序列的间隔是 120 到 220 个。
从一开始,就不在筛查范围里。
不是人的本事不够,是筛子先把东西筛掉了。
——
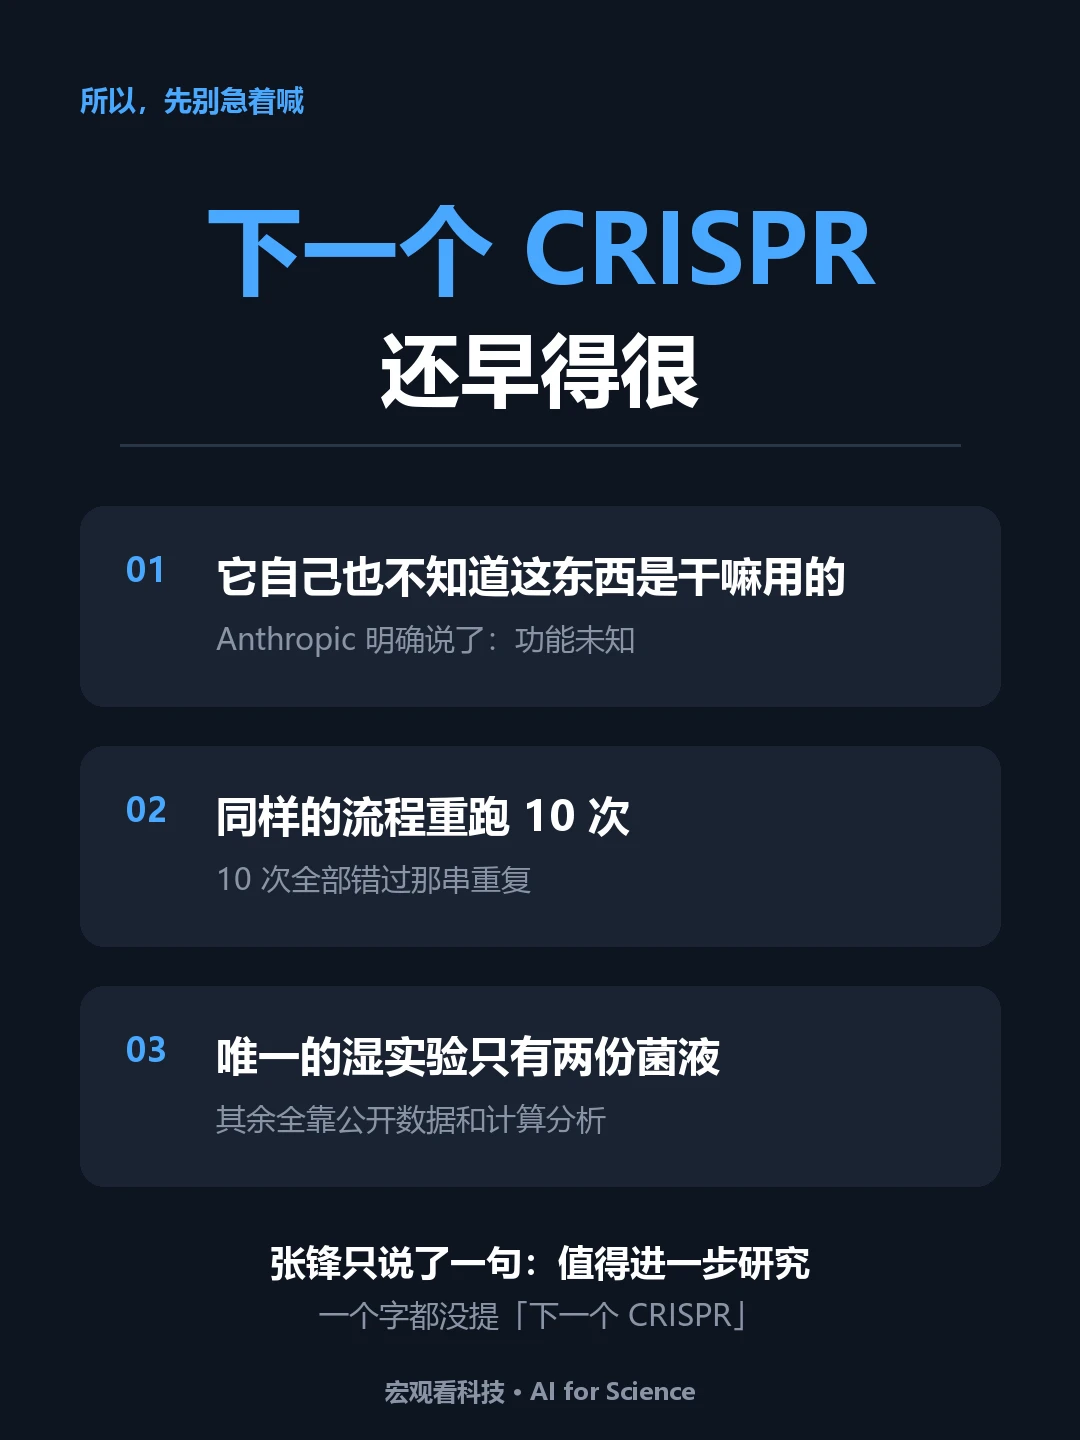
最后说句煞风景的:先别急着喊「下一个 CRISPR」。
Anthropic 自己都说,不知道这东西是干嘛用的。 同样的流程重跑 10 次,10 次全部错过那串重复,一次都没再读那段 DNA。 19 份报告里,这份只排第三,是研究员凭经验挑出来的。
CRISPR 的先驱张锋看完预印本,说了一句「值得进一步研究」。 他夸的是 AI 参与科研的这种方式,一个字都没往「下一个 CRISPR」上靠。
CRISPR 从 1987 年被偶然看到,到 2013 年变成能用的工具,中间隔了 26 年。
我觉得真正的好消息不是「AI 会做科研了」,而是那个负责「第一眼」的位置上,第一次坐了一个愿意把 2900 个碱基一个字母一个字母读完的读者。
#ai #人工智能 #Anthropic #Claude #CRISPR #基因编辑 #AI科研 #科技真相 #涨知识 #生物科技