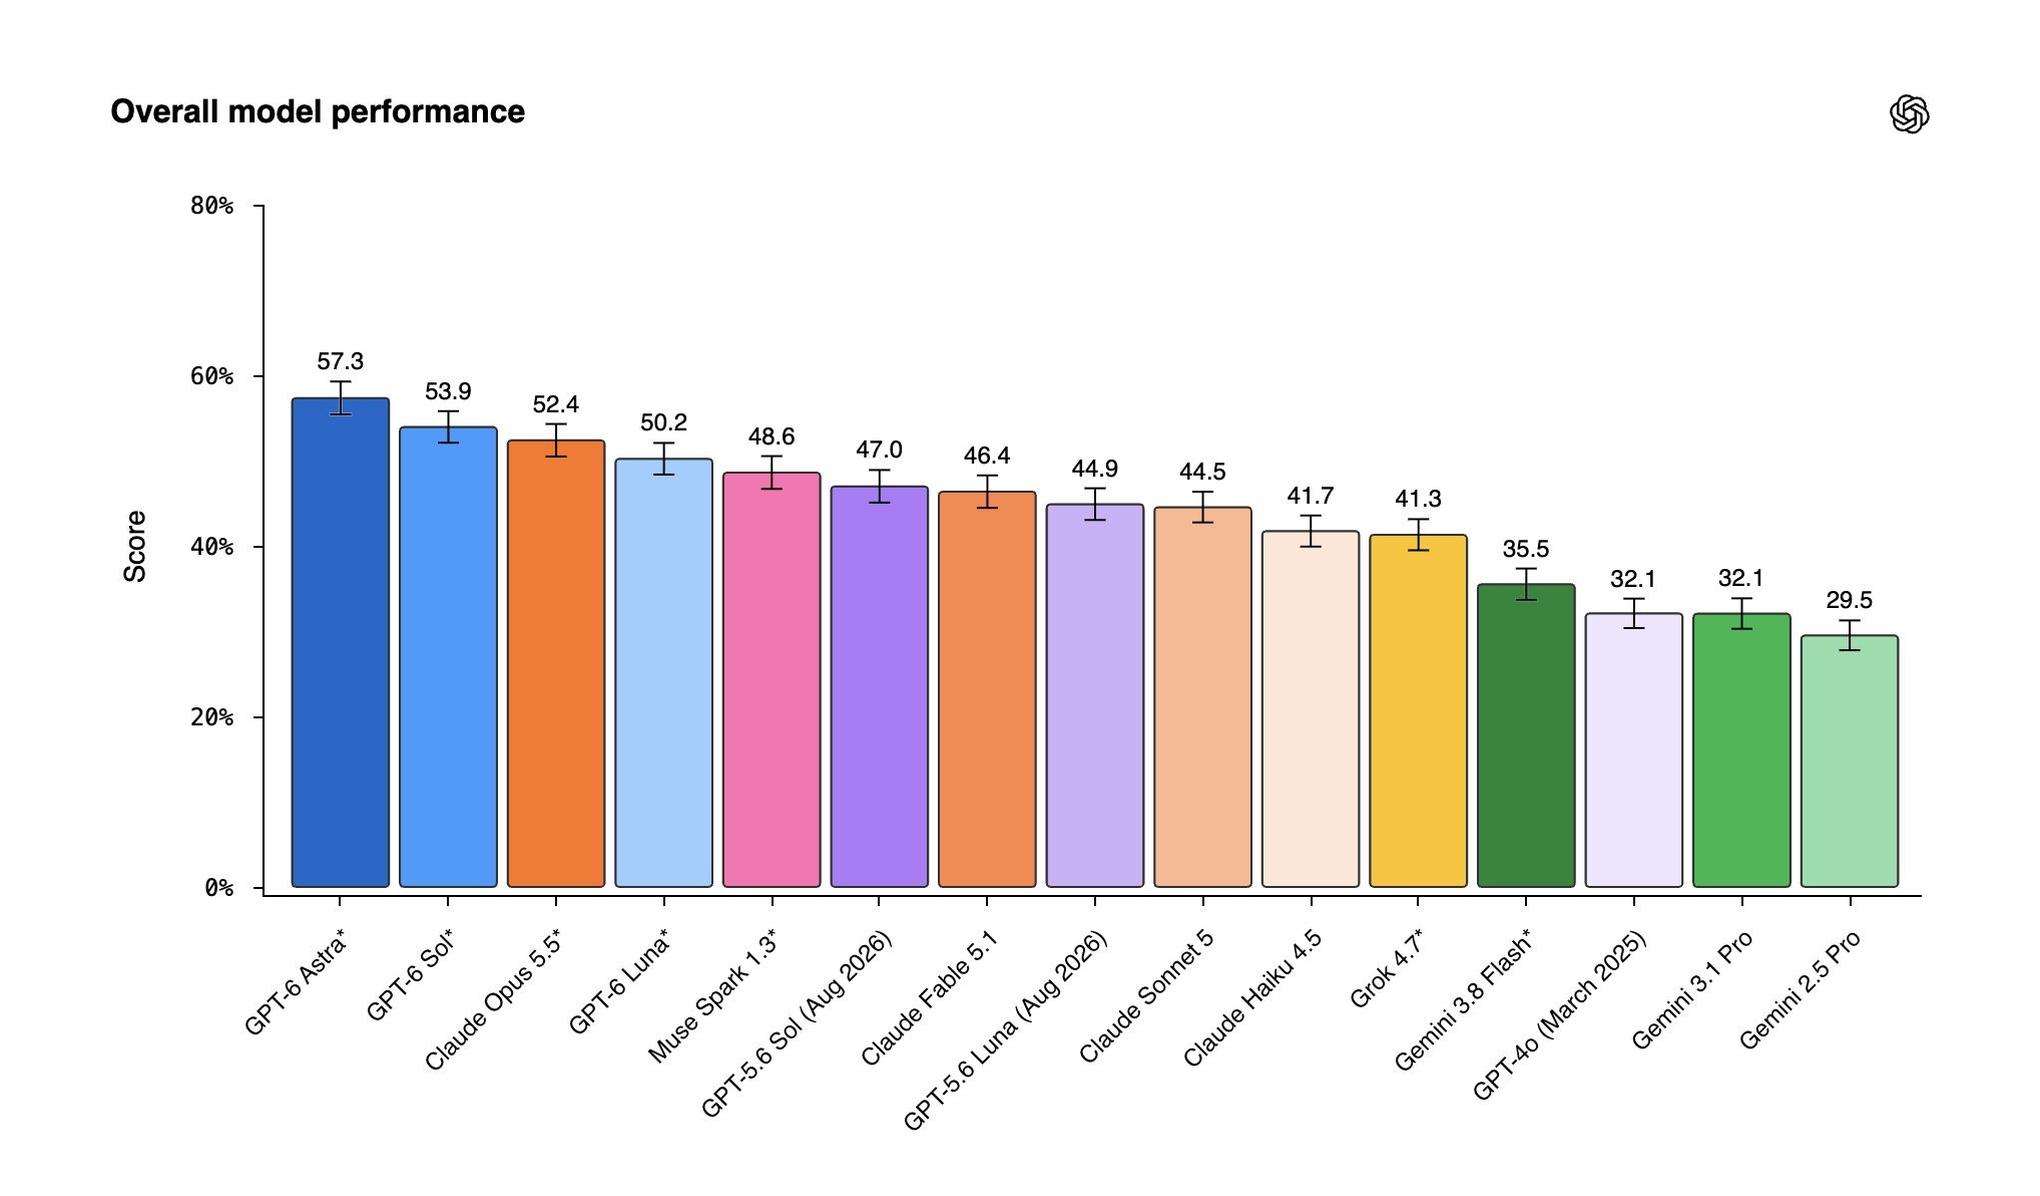
OpenAI的新MentalHealthBench将GPT-6 Astra置于57.3,而GPT-4o为32.1,用于现实的心理健康对话。
大多数心理健康人工智能评估都以紧急情况和广泛的安全标准为中心,使得日常和模棱两可的对话缺乏衡量标准。
因此, OpenAI与来自22个国家的80多名有执照的心理学家和精神病学家共同创建了这个基准,涵盖19种语言和近20个子专业。
每次综合对话都会获得一个自定义的专家评分细则,涵盖寻找背景、保留用户代理、安全和适当的指导等行为。
至少有3名专家审核了每个个案,只有在2名专家同意且第3名专家没有反驳的情况下,标准才得以保留。
GPT-5.6 SOL然后根据这些人工编写的标准对模型答案进行评分,因此分数质量仍然部分取决于大语言模型评委。我们正在展示Frontier模型如何在与MentalHealthBench的现实心理健康对话中不断改进。
这个新的开放基准是根据80多名心理健康临床医生的意见建立的。