云栖大会:阿里真武V900+小米开源大模型,国产算力产业链与全球格局深度解读
AI算力平民化 企业级AI架构 阿里AI硬件 阿里AI新硬件 小米开源大模型 阿里AI编程 阿里算力概念
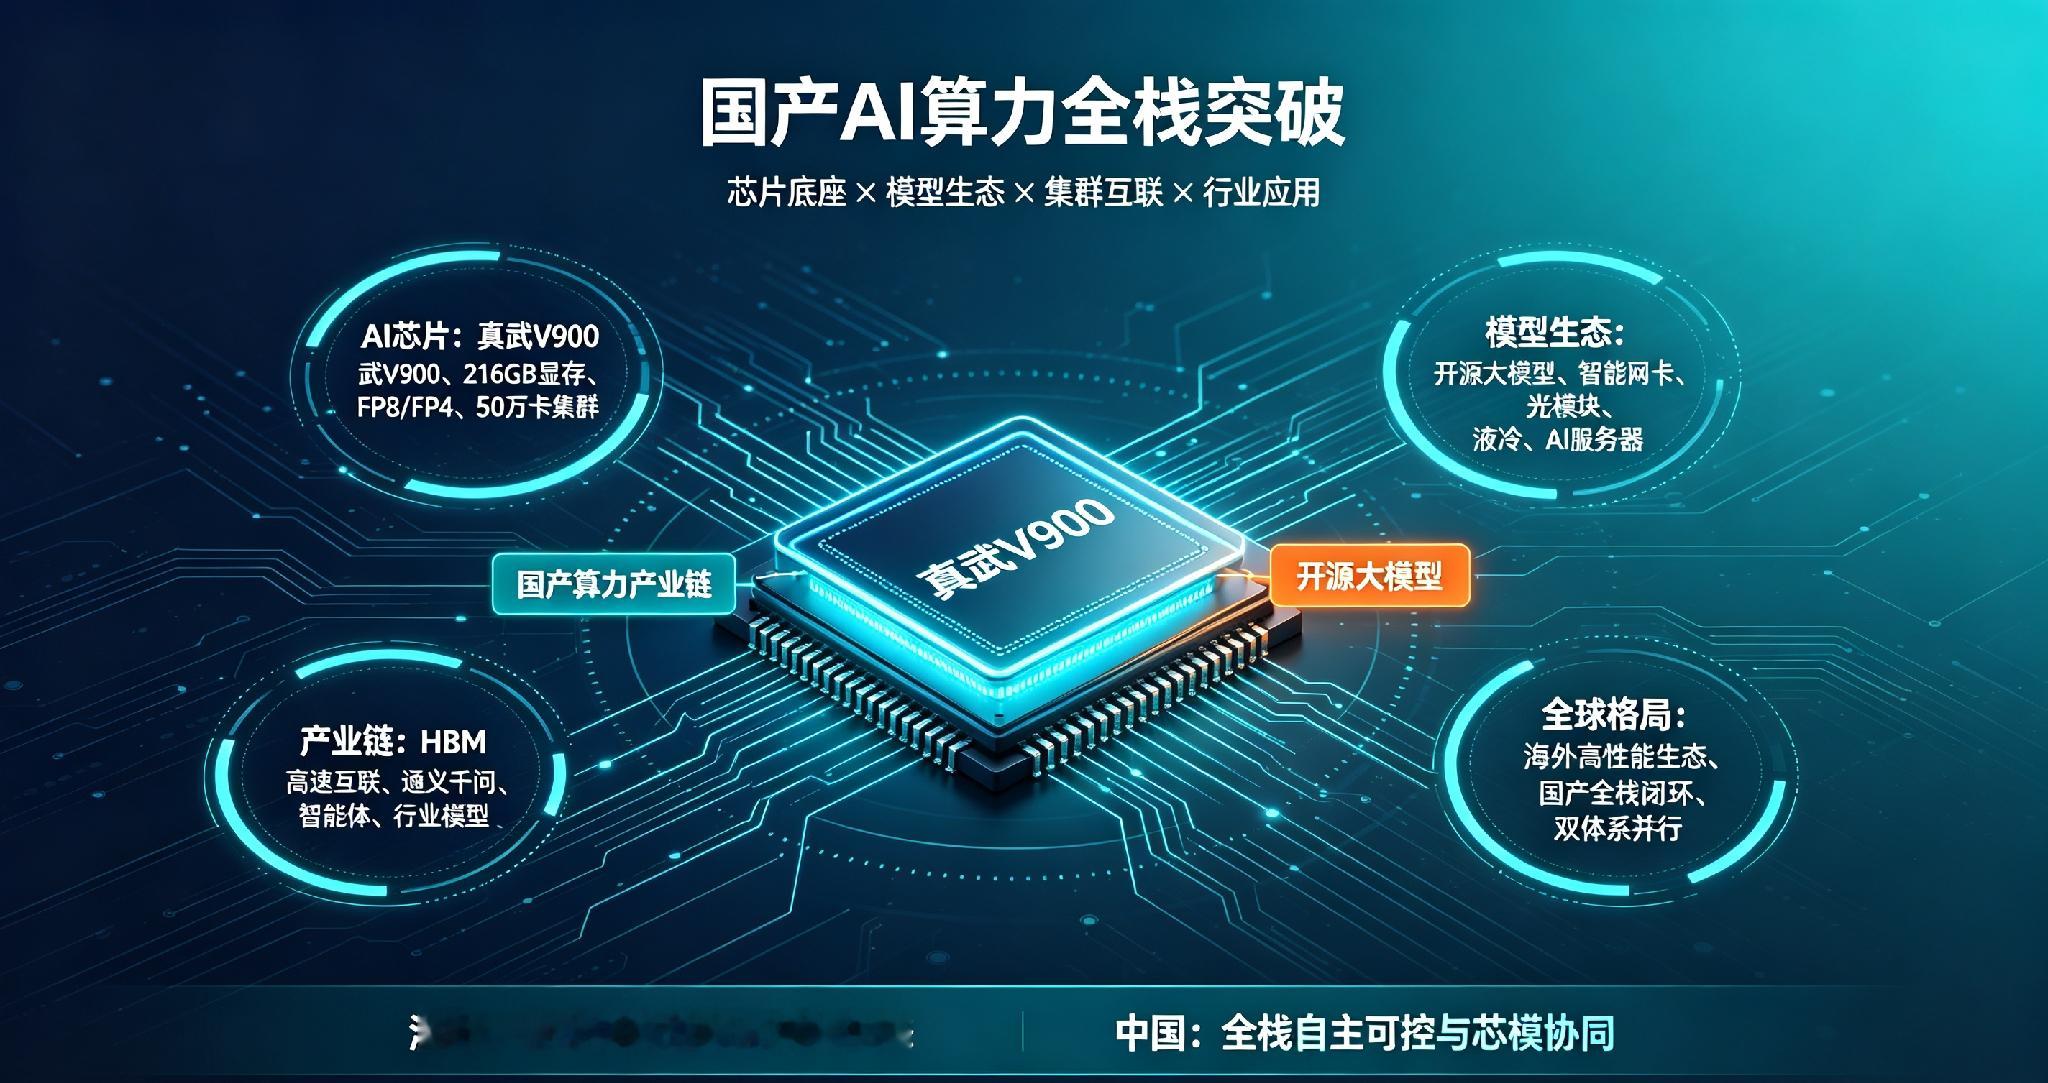
核心事件:2026云栖大会,平头哥发布真武V900训推一体AI芯片,单卡性能是上代M890的3倍,搭载216GB显存、1200GB/s片间互联带宽,原生支持FP8/FP4,可支撑万亿参数大模型,2027Q1量产,单集群最高可扩展至50万卡;同时小米持续开源大模型,国内形成自研算力芯片+开源大模型双轮驱动的国产AI生态。
一、事件核心逻辑:国产算力从“单芯片突破”走向全栈闭环
1. 真武V900的核心价值
不只是单卡算力提升,而是算、存、网一体化自研:V900+ICN Switch互联芯片+磐脉智能网卡+镇岳SSD,磐久超节点服务器实现千卡高速互联,解决国产芯片过去“单卡能用、大规模集群组网困难”的痛点,能支撑5~10万亿参数Qwen4超大规模模型训练 。
2. 小米开源模型的协同意义
小米开源大模型降低模型使用门槛,和阿里真武芯片形成互补:芯片提供算力底座,开源模型丰富上层应用,国产算力不再只是硬件,而是“芯片-框架-模型-云服务”完整生态,摆脱对海外软硬件栈绑定。
一句话总结:阿里解决大规模训练算力底座,小米等厂商打开模型应用生态,国产算力进入“芯片+模型协同突破”阶段。
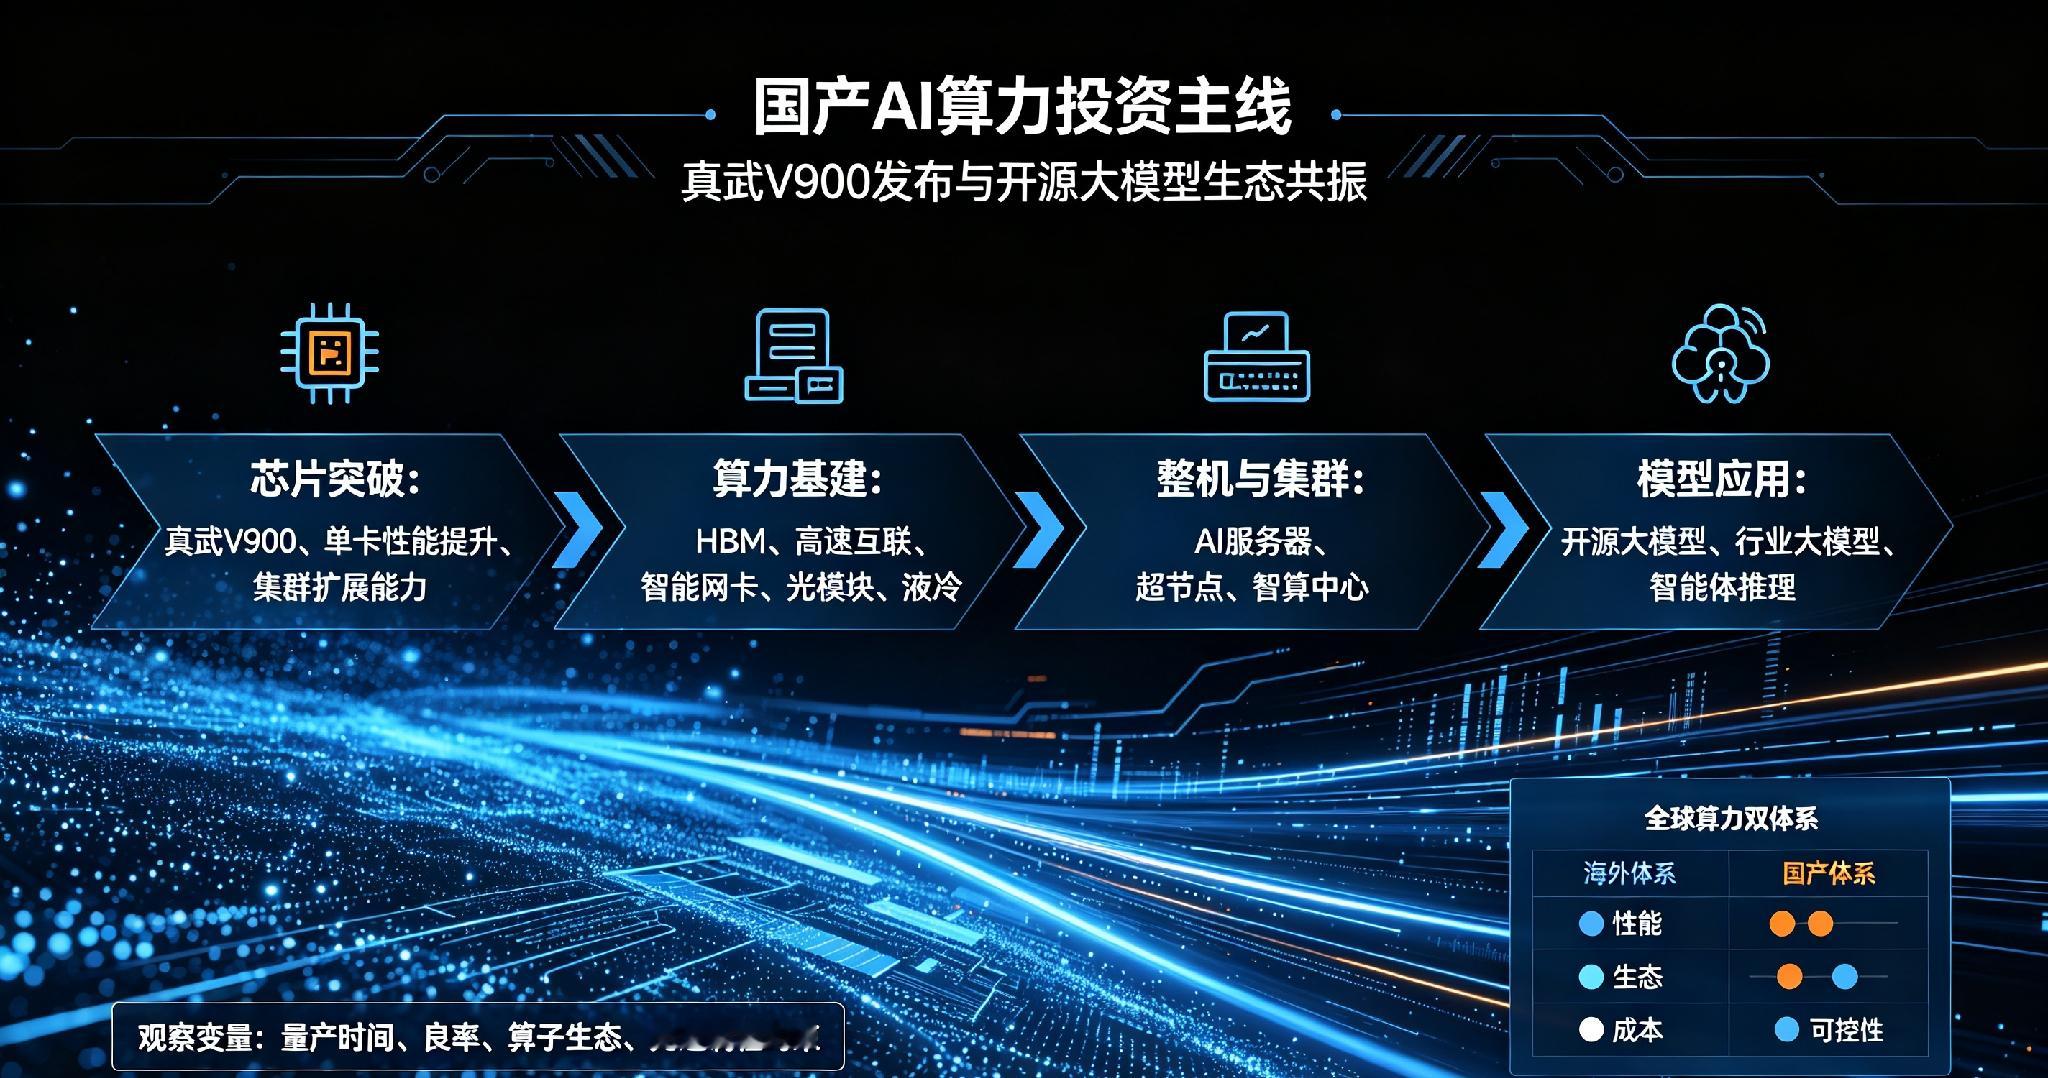
二、国产算力产业链投资机会(分层拆解)
风险提示:以下仅产业逻辑分析,不构成任何投资建议,芯片量产、良率、客户落地存在不确定性。
1)核心AI芯片层(最核心主线)
- AI加速芯片:平头哥真武系列,国产训推一体标杆;国内其他智算芯片厂商同步受益,行业验证国产芯片可以跑通万亿参数大模型。
- 配套自研芯片:ICN高速互联芯片、智能网卡、SSD主控。大规模AI集群,片间互联是瓶颈,高速互联芯片、网卡价值量提升。
- HBM高带宽显存:真武V900搭载216GB HBM,国产AI芯片对HBM需求持续放量,HBM是算力卡的核心成本项。
2)服务器与整机、算力基础设施
磐久超节点服务器作为V900的载体,带动AI服务器整机、PCB、高速连接器、光模块。
大规模集群配套:液冷散热、高压供电、IDC智算中心。阿里规划2032年数据中心规模超20GW,长期拉动算力基建需求。
3)软件栈与模型生态
- 大模型开源生态:小米、通义千问等开源模型,拉动国产算力平台适配、AI框架、算子库、编译器需求。
- 算力运营:国产卡算力租赁、智算服务,国产芯片成本优势会逐步释放,推理场景率先落地。
4)细分机会优先级
高确定性:HBM、高速互联、光模块、液冷;中长期机会:国产AI加速芯片、AI服务器整机;应用端:开源模型带来行业AI应用落地。
三、全球AI算力竞争格局变化
1、旧格局:海外厂商软硬件生态垄断
此前全球算力市场高度集中,海外芯片凭借成熟生态、强大单卡性能、完善集群互联,垄断全球大模型训练市场;国内算力高度依赖进口卡,供应链存在不确定性。
2、本次事件带来的格局重塑
① 国产算力进入“千卡/十万卡集群商用阶段”
真武V900最大亮点不是单卡,而是50万卡集群扩展能力,证明国产芯片具备超大规模大模型训练能力,缩小和海外头部产品的差距。短期在超高精度训练仍有差距,但在FP8/FP4低精度训练、推理场景竞争力快速提升。
② 市场分化:两条算力路线并行
- 海外路线:单卡极致性能+成熟生态,优势在前沿超大模型训练,但是供给受限、成本高;
- 中国路线:全栈自主可控+芯模协同,阿里芯片搭配通义千问,小米开源模型适配国产算力,打造独立软硬件闭环,优先满足国内政企、行业大模型需求。
③ 生态竞争取代单纯硬件比拼
AI算力竞争不再只比单卡算力,而是芯片、互联、存储、编译器、大模型一体化竞争。真武V900+Qwen,加上小米开源模型,共同构建独立生态,降低国内产业对海外软件栈依赖。
3、现存短板(不能只看利好)
- 量产时间:V900要等到2027Q1才量产,良率、大规模商用验证还需要时间;
- 生态差距:海外生态积累数十年,算子、工具链、开发者生态仍占优;
- 先进制程约束,芯片性能上限仍有差距。
四、产业总结
1. 短期:推理场景优先落地,国产算力会率先在行业大模型、Agent智能体推理大规模替代;超大模型训练仍会是国内外芯片并行。
2. 中长期:国产算力不再是单点替代,而是完整独立算力生态,“芯片+开源模型”的组合,是国内AI产业自主可控的关键一步。
3. 全球格局:算力市场从单一垄断走向双生态并行,海外高性能芯片和国产全栈算力各自占据不同市场。