个人团队撞上工业级Agent评测
事情源于昨晚刷帖,发现美团公布了《Agent评测白皮书》,仔细对比一看,这套东西怎么越看越眼熟。
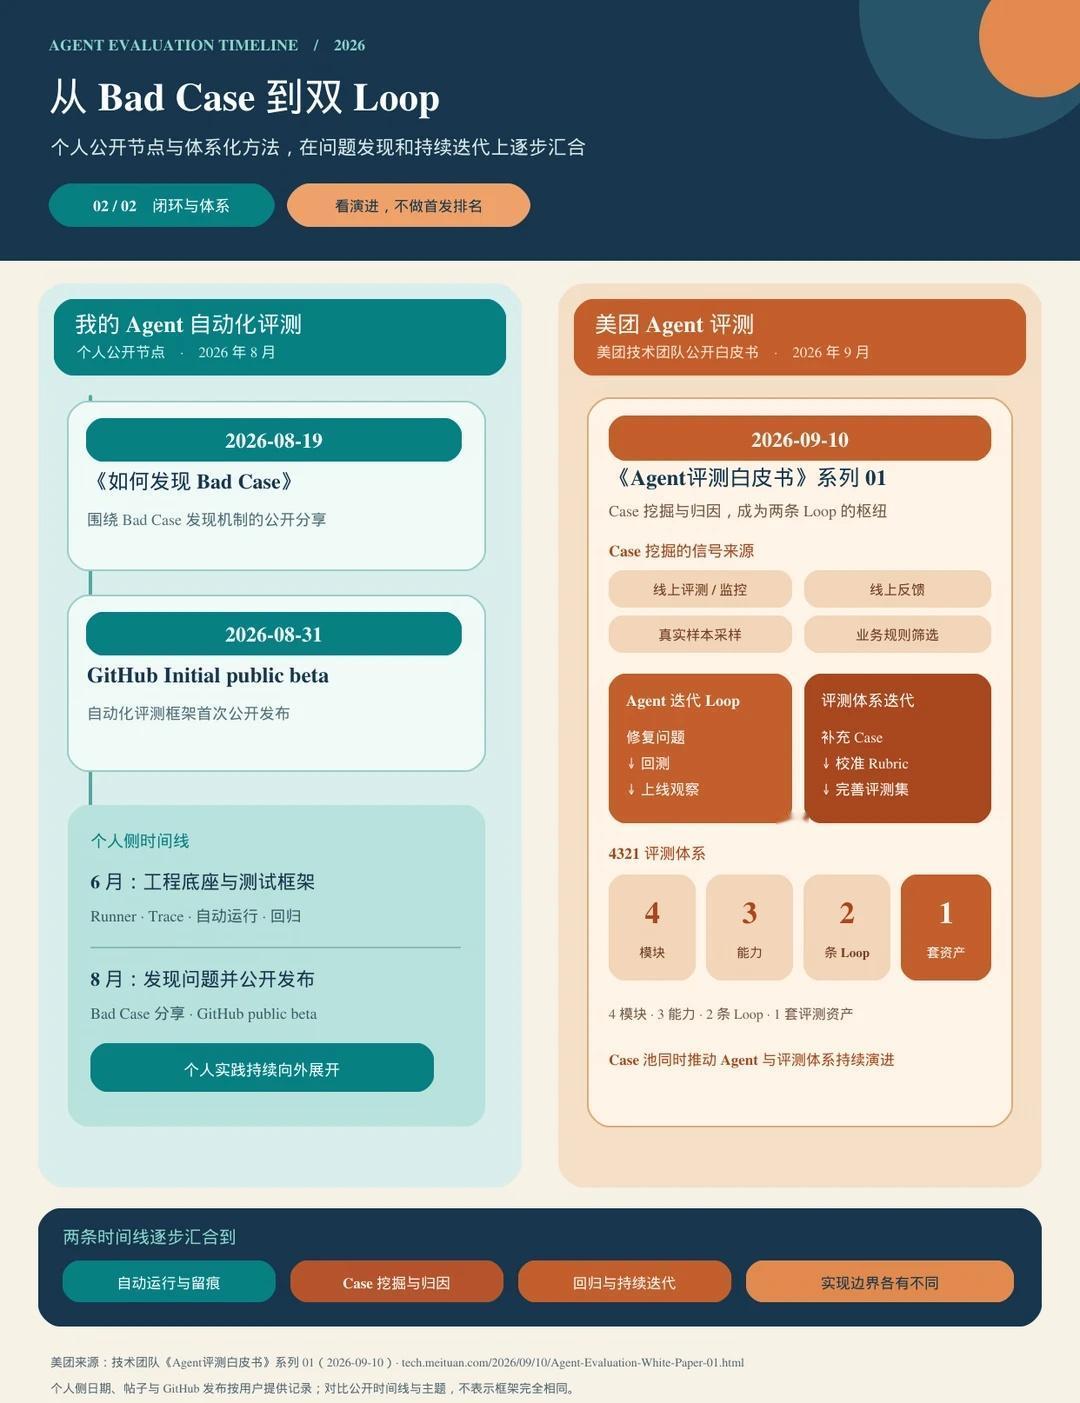
我从 6 月开始实践的一套 Agent 自动化评测框架,不止核心框架有接近 80% 的相似度,甚至一些流程分叉和工程细节都高度相似:失败后都先做归因,明确Agent 演进 + 评测体系演进的Loop——前者进入 Agent 修复、回测和发布门禁,后者反向修正 Metrics / Rubric / 评测集;确认的 Bad Case 都会沉淀成回归资产,防止同样的问题再次出现甚至门禁设计上,都进一步区分了必须通过的硬门禁和允许阈值判断的软指标。
连我自己都惊讶,这种相似已经不只是“都在做自动化评测”,而是连问题怎么分流、资产怎么沉淀、修改怎么放行都撞到了一起(之前的思路分享见主页合集/置顶)
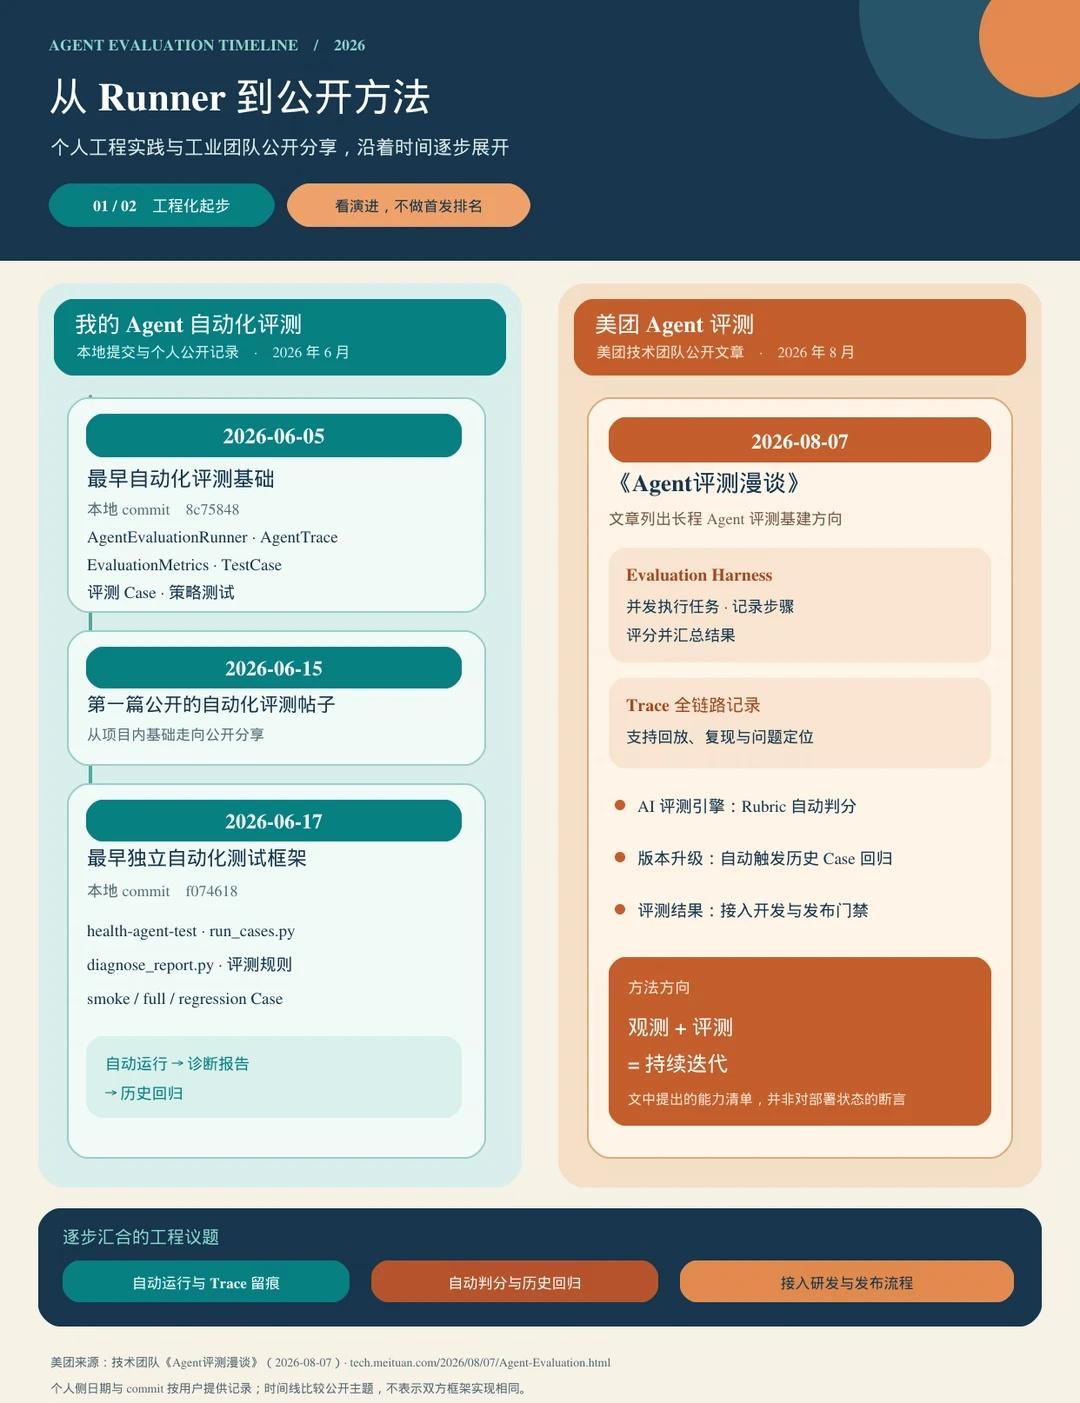
后来仔细扒了时间线,美团第一篇方法论在8.7,比我公布的晚了两个月左右。(具体见p2/p3)
当然,我的项目和美团的规模上没法比。美团拥有真实的大规模业务流量、长期积累的评测资产和完整的线上基础设施;而我的框架目前仍然有明确的验证边界——单机,而非多物理机集群。
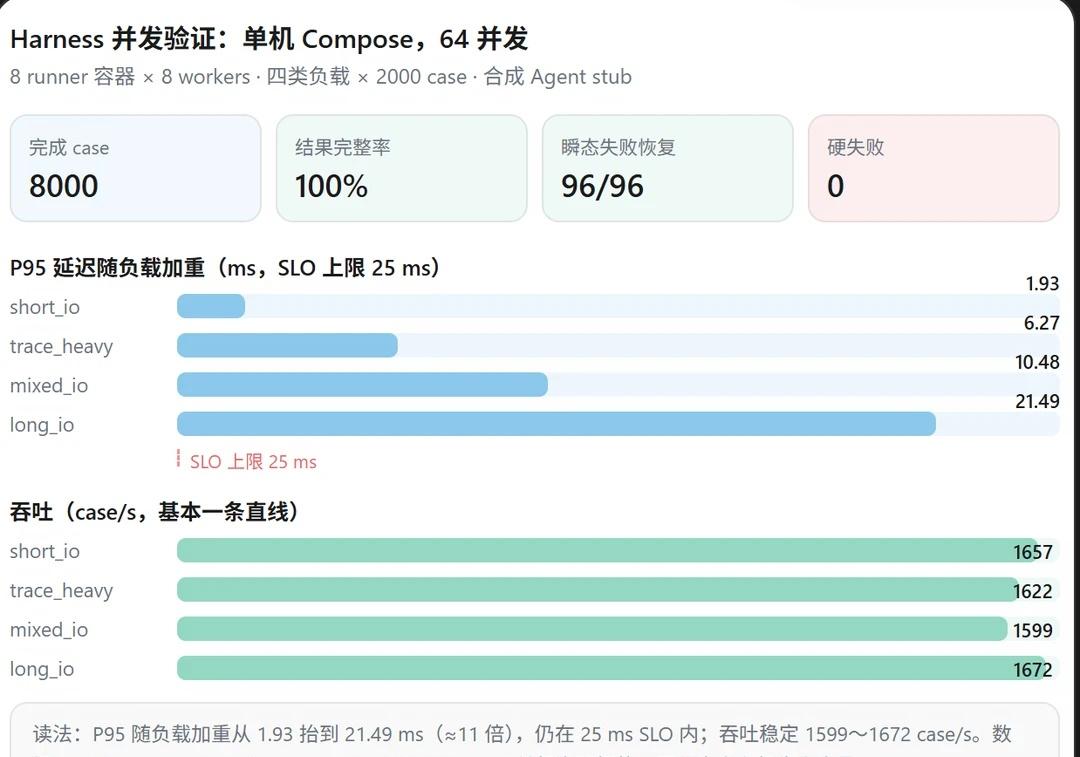
但我这个框架也没有停留在 Demo 和架构图。(P4)
相比单纯追求一个更大的 QPS,我更关注的是:负载持续加重以后,系统如何退化;故障出现以后能否恢复;并发执行以后 Trace 和结果能否保持完整;最终是否仍然满足预设 SLO。
目前这些实验、Trace、复现脚本和证据文件也都保留在仓库里(地址见主页置顶)
说到这里,我并不是想和美团抢首发。实际上这个项目之前在求职、面试,包括在公开平台分享的时候,我都反复推荐过它。很可惜我人微言轻,连带着我的项目也没有水花
如果你也在做 Agent,不想每次改完 Prompt / Skill / Tool 都靠手工测一遍,或者正在折腾自动化评测、回归测试、Bad Case 和 Agent 自演进,可以来看看我的框架。
它现在可能还是一个只有 2 个 Star 的小仓库——其中一个还是我自己点的
但至少这次,我不再准备因为没人看,就怀疑这个问题值不值得做了。@美团技术团队
评测 自动化测试