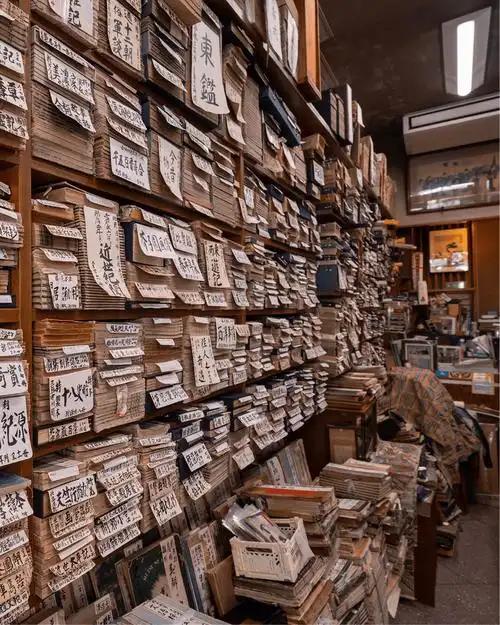
日本爆发诡异扫书潮,一支神秘买家书扫遍大阪、京都、东京,从江户时代古书到上世纪七十年代政治小册子,凡是带字的全收。有书商统计,单是神田町一条街,三个月被拉走的旧书就超过两百吨。问买去干嘛,对方只回四个字:出口消化。
看到这条消息,我停了大概三秒。
说实话,让我真正愣住的不是那个数量,是那句“凡是带字的全收”——七十年代的左翼运动小册子照收,昭和年代的学生课本照收,江户年间讲驱邪仪式的地方志也不放过,来者不拒,毫无筛选。
正常的收藏家讲品味,书商算受众,任何一种合理的购书动机,都不应该长这个样子。
那这帮人到底是谁?
9月22日,日本电视台发了一篇独家调查,追出了目前最接近真相的一条线。
今年8月前后,日本全国各地的网络旧书店陆续收到大批订单,书商形容“单日销售额飙到平时五倍”。
订单里的书目极其诡异:哲学、历史、医学、法律、江户时代生活文化、三十年前的政界旧事,一本小说、一部漫画都没有。
东京一家书商的原话是“脉络全无”——一眼就是看不出这堆书是同一个人用来干什么的。
更怪的地方在送货地址。无论多少个不同账号下单,收货地都指向同一处:岡山县某物流中心。
等间隔下单、多账号分散操作、统一汇往一处,有书商直接推断,背后是机器在自动运转,整个链条有系统在支撑。
日本电视台用贸易数据分析工具Sayari继续追,发现了一条硬记录:日本一家大型出版发行集团的子公司,去年起向美国出口了超过50吨“日本图书”。
50吨精装书,按每本500克算大约是十万册的规模,被追问用途,对方只说“没有认知到是AI企业学习用途后出售”——这句话的分寸感,本身已经是一种信号。
而硅谷那帮人干这事早就不是头一回了。
Anthropic的“巴拿马计划”内部文件写得清清楚楚,买书、切脊、扫描、粉碎,一条龙流水线,预算几千万美元对他们年营收四百多亿来说连根毛都算不上。
加州联邦法官还给他们开了绿灯,裁定合法购买的实体书扫描用于训练属于“合理使用”,销毁原件反倒成了加分项,因为数字版“替代”了实体版。
法律做成这样,跟给偷猎者发狩猎证有什么区别。
说到底就是网上没东西可吃了,公开文本被爬了个底朝天,新网页里超过七成是AI自己生成的垃圾,模型再用这些数据训练几代下来输出的就是一堆逻辑混乱的呓语,行业内管这叫“模型塌陷”。
2022年之前印出来的纸质书成了唯一没被污染的干净粮源,日本旧书排版规整、纸张讲究、OCR识别率高,里面还藏着大量从没上过网的地方记录和历史细节,对AI公司来说就是高纯度的饲料。
五十吨书拉回去切碎扫描,纸浆冲进下水道,文字喂进显卡,昭和年间的地方志和明治时期的法学典籍最终变成大模型嘴里几句不伦不类的日语。
人类几百年攒下来的纸质文明扛过了战火和虫蛀,最后栽在集装箱和扫描仪手里。
日本书商还在那儿高兴销量涨了五倍,等反应过来书架空了、绝版书没了、那些全世界只剩几本的老东西被切碎打成纸浆,想哭都找不着坟头。
日本书籍出版协会发了书面文件去问,答复是“对个别交易内容不予回答”,客气得跟没说一样。
马斯克都看不下去了,专门要求自家AI团队把珍稀图书保住,一个造火箭的都比搞出版的急,这事儿本身就够荒唐。
旧书被买走是市场行为,被切碎销毁就是另一码事了。
绝版古籍扫描完原件扔掉,数字版本锁在企业服务器里,以后谁想看谁掏钱,公共知识被私有化装进算力集群。
文化保护喊了这么多年,到头来最安全的知识避难所居然是家里书架上那几本落灰的旧纸。
这场“吃书”运动裹着合法的外衣全速运转,规则还没跟上,纸已经没了。
纸能变成数据,数据变不回纸。