谷歌:让AI在离线环境自我探索与进化
📖标题:Dream-RSI: Recursive Self-Improvement through Evolving Worlds
🌐 2609.14858v1
🛎️文章简介
🔸研究问题:在AI自主进行科学发现或代码生成时,如何高效地优化其“探索策略”,避免因反复尝试昂贵且反馈延迟导致的资源浪费?
🔸主要贡献:论文提出Dream-RSI框架,将历史探索记录转化为可重放的模拟器,让AI在离线状态下通过“做梦”快速评估和优化探索策略,大幅降低计算成本并提升发现质量。
📝重点思路
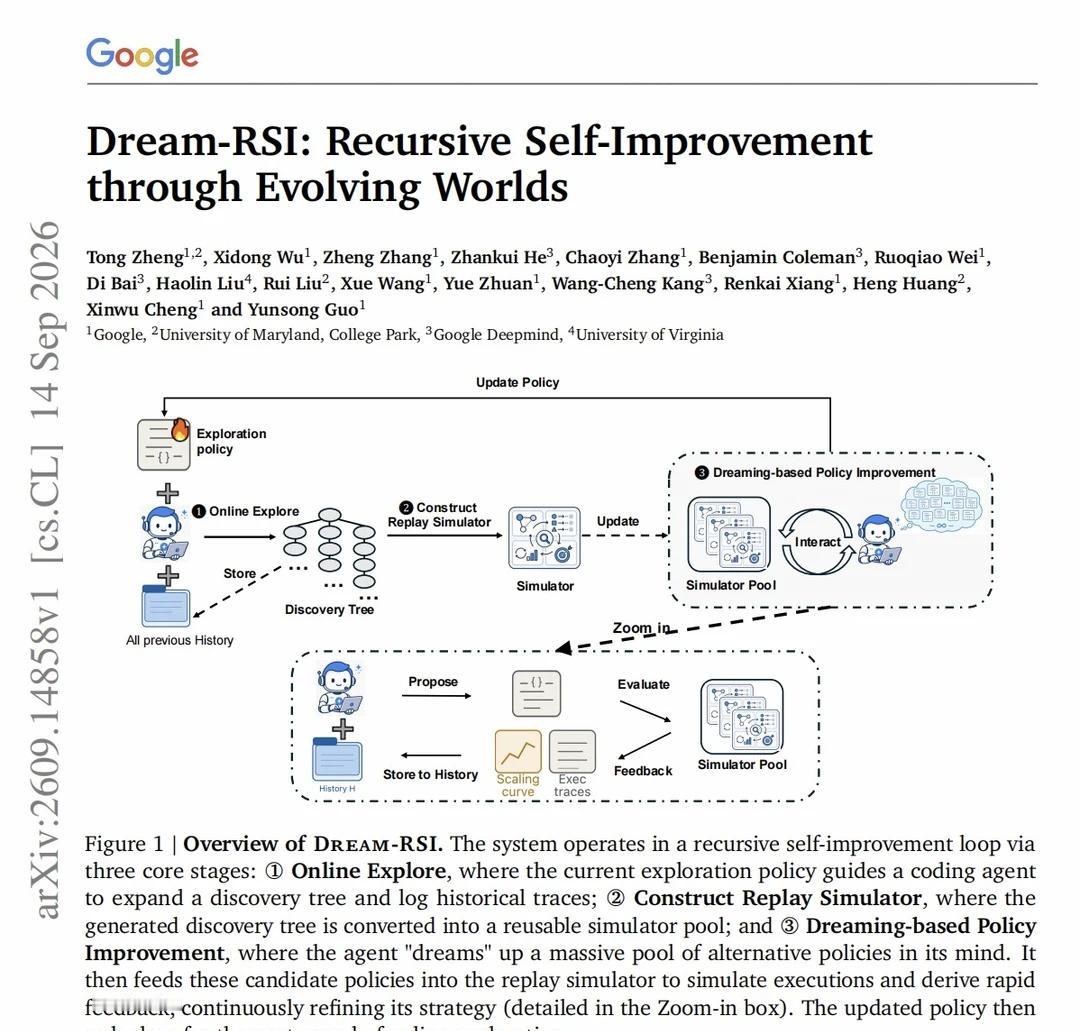
🔸构建重放模拟器:核心洞察是将过去积累的探索历史(以发现树的形式存储)视为一个“重放模拟器”。因为所有节点的结果已保存,无需重新运行代码即可模拟不同策略下的探索路径。
🔸轻量化编排层:引入一个可编程的轻量级控制层来管理分支、并行探索和停止条件,而底层的代码生成Agent保持不变,使探索过程显式化且可优化。
🔸三阶段递归闭环:系统包含在线探索(收集新数据)、构建模拟器(整理历史树)和基于做梦的策略改进(在模拟器中测试新策略)三个阶段。
🔸离线策略优化:在离线阶段,Agent在模拟器中“梦想”出多种替代策略,通过读取历史记录快速获得反馈,选出最优策略后重新部署到在线环境中,形成自我进化的循环。
🔎分析总结
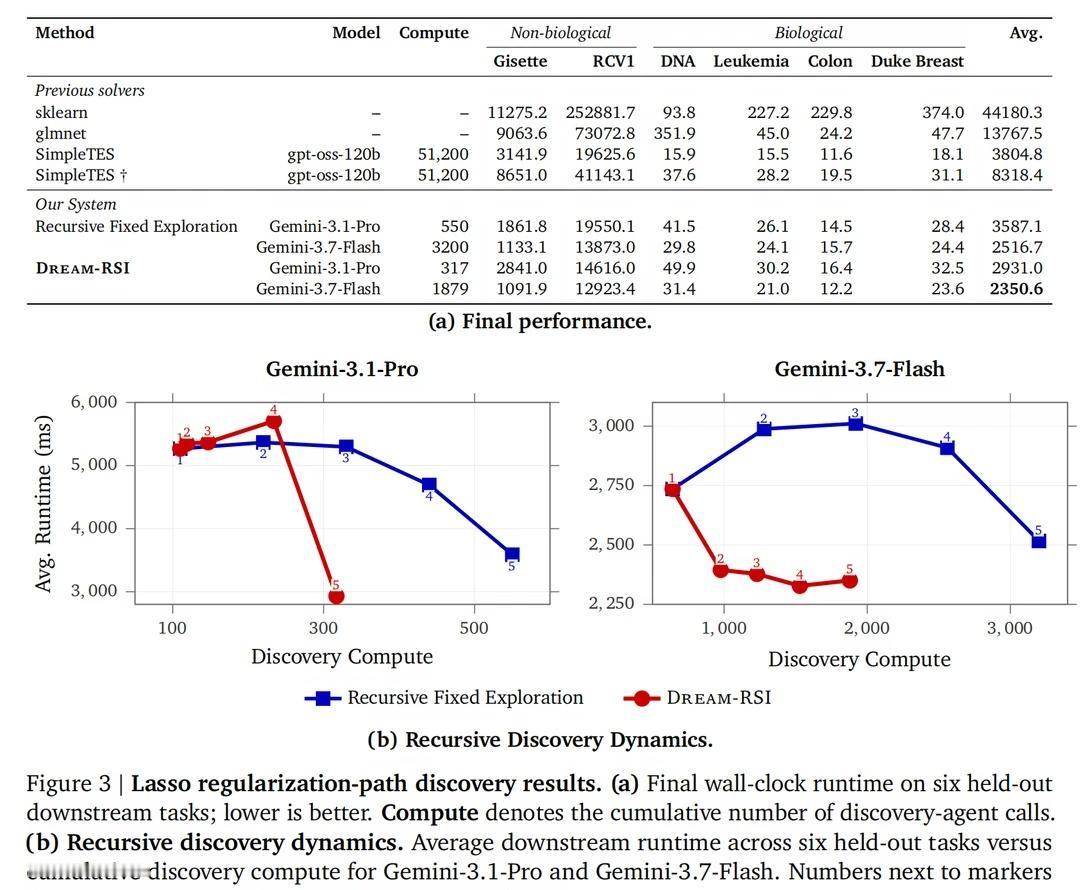
🔸算法工程优势:在Lasso正则化路径求解任务中,Dream-RSI生成的算法在多个下游数据集上优于sklearn等标准库,且相比基线方法减少了高达162倍的Agent调用次数。
🔸数学优化表现:在求和差、自相关不等式和圆 packing 等数学任务中,Dream-RSI在1000次迭代内达到或超越了现有最强基线的性能,同时节省了超过50倍的预算。
🔸GPU内核加速:在GPU内核工程任务中,Dream-RSI要么用更少的生成次数达到同等性能,要么在相同预算下显著提升内核执行速度。
🔸历史利用效率:实验表明,直接将历史作为交互式模拟器进行重放评估,比仅将其作为提示词中的语义指导更有效,后者容易限制搜索空间的多样性。
💡个人观点
论文将强化学习中的“世界模型”概念迁移到了LLM代理的探索过程中。传统方法往往把历史当作静态上下文或微调数据,而Dream-RSI将其变成了动态的“沙盒”。
LLM 大模型 agent 论文分享