Claude Opus 5.5 发布了。
看来是OpenAI带来的压力太大了,A/也开始卷Sota模型的性价比了
这次最值得关注的,不是 Anthropic 又刷了多少 Benchmark,而是 Opus 开始从“最强但贵”变成“最强而且真能日常用”。
几个重点👇
1|Opus 5.5 是 Claude 5.5 家族第一款模型
Anthropic 自己的定位很直接:
大部分任务已经能做到 Fable 5.1 级别,但相比 Opus 5,典型任务运行成本降低 40%。
而且 Sonnet 5.5、Haiku 5.5 接下来几周也会跟上。
这说明 5.5 不只是一次模型升级,而是一轮完整的产品线换代。(Anthropic)
2|这次最狠的升级,其实是“经济性”
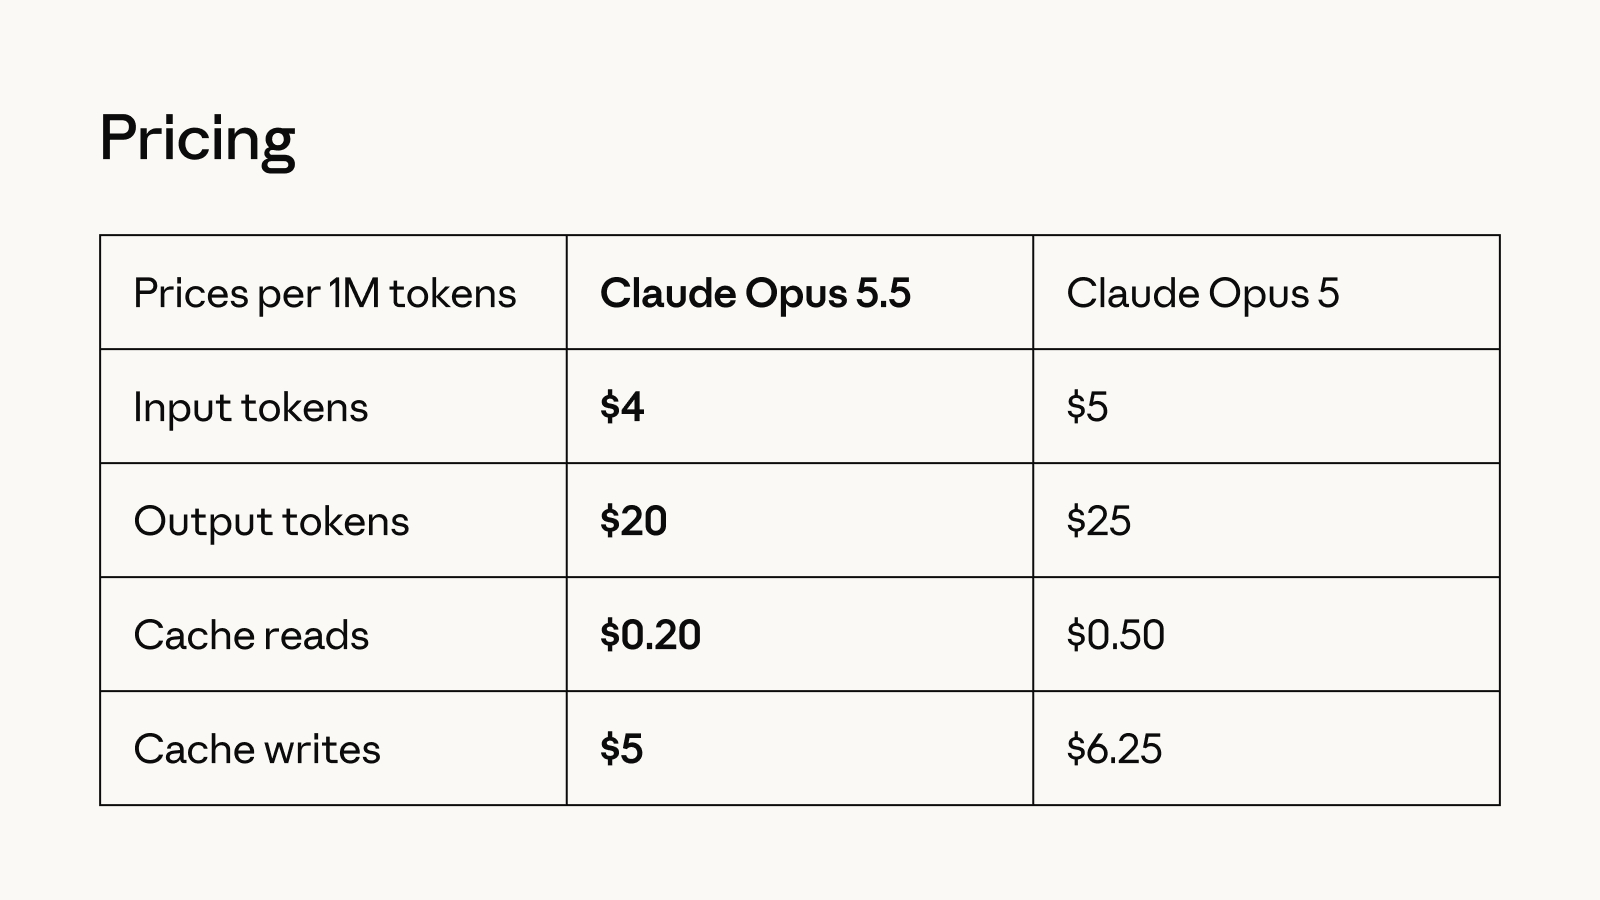
API 价格:
• Input:$5 → $4 / 1M tokens• Output:$25 → $20• Cache Read:$0.50 → $0.20
缓存读取直接降了 60%。
同时输出速度提高 30%+。
Agent 最烧钱的地方恰恰是长上下文、反复调用工具和 Cache。
所以这次的意义不是“便宜20%”,而是:
复杂 Agent Workflow 的单位任务成本开始明显往下掉。 (Anthropic)
3|Agent Coding 是 Opus 5.5 最明显的强项
Anthropic 公布的数据:
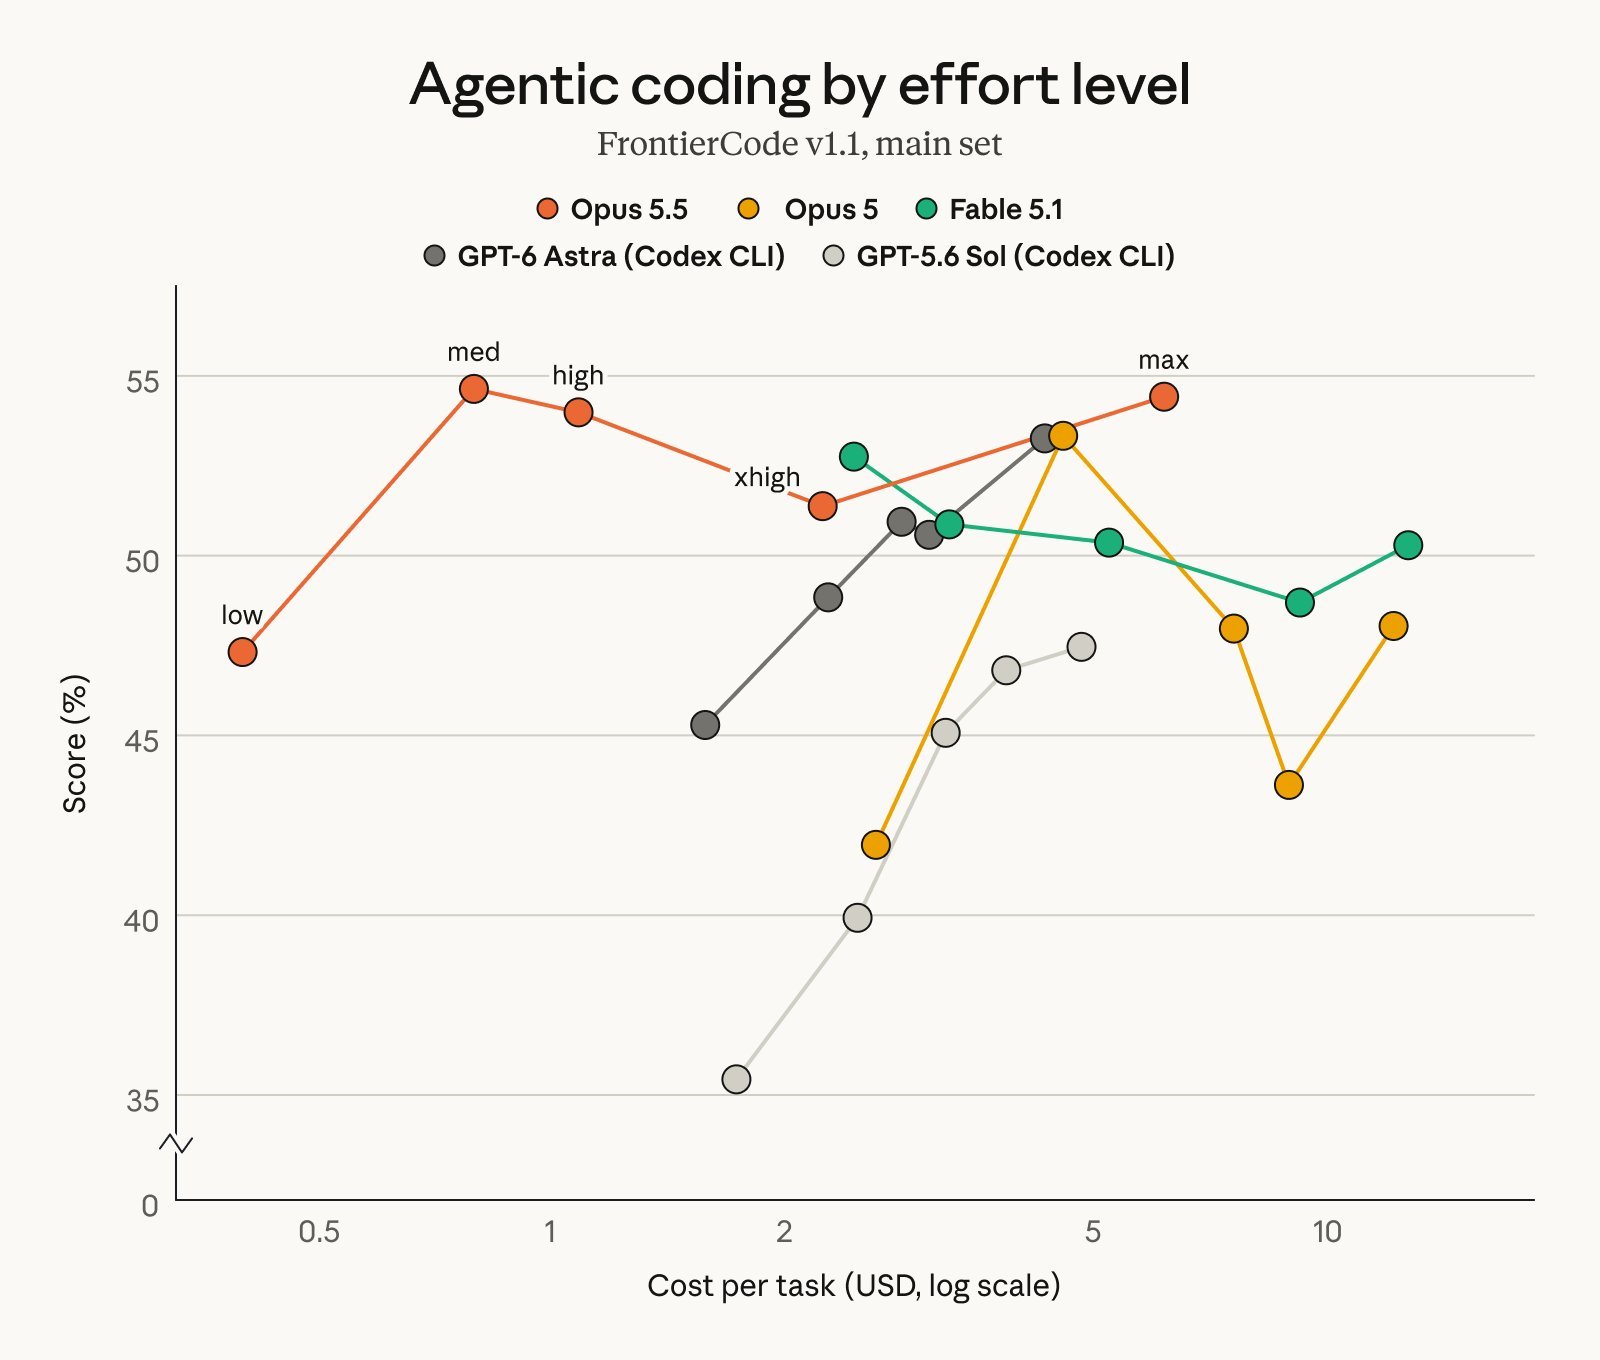
• Terminal-Bench 4.0:66.4%• FrontierCode:54.4%• CursorBench 4.0:57.8%
对比它列出的 GPT-6 Astra:
Terminal-Bench:57.9%FrontierCode:53.3%
对比 GPT-5.6 Sol:
CursorBench:41.7%。
当然,这是 Anthropic 自己发布的测试,Harness、effort 和成本计算方式都要一起看,不能直接理解成“全面碾压”。
甚至 Anthropic 自己都提醒:
到这个能力水平之后,Benchmark 的几个百分点越来越难代表真实体验差距。
这句话其实比榜单本身更值得注意。(Anthropic)
4|一个明显趋势:模型开始真正处理“工程项目”,而不是“写代码”
他们给出的案例已经不是:
“帮我写个函数。”
而是:
• 68万行代码迁移• 20万行 Codebase Audit• 跨 6 个 Repository 工作• 连续自主运行 18 小时• 一个 Session 协调另外十几个 Session
Opus 5.5 做 20 万行代码审计:
不到3小时。
Opus 5:
20+小时,而且用了2.5倍 Token。
如果这些能力在真实使用中稳定下来,Coding Agent 的竞争核心会越来越从:
“代码写得聪不聪明”
转向:
“能不能连续工作十几个小时,还不把项目搞坏。” (Anthropic)
5|对非程序员来说,我反而更关注 Knowledge Work
GDPval-AA v2.1:
Opus 5.5:1846Fable 5.1:1735Opus 5:1708GPT-5.6 Sol:1588GPT-6 Astra:1542
Anthropic 还专门测试了:
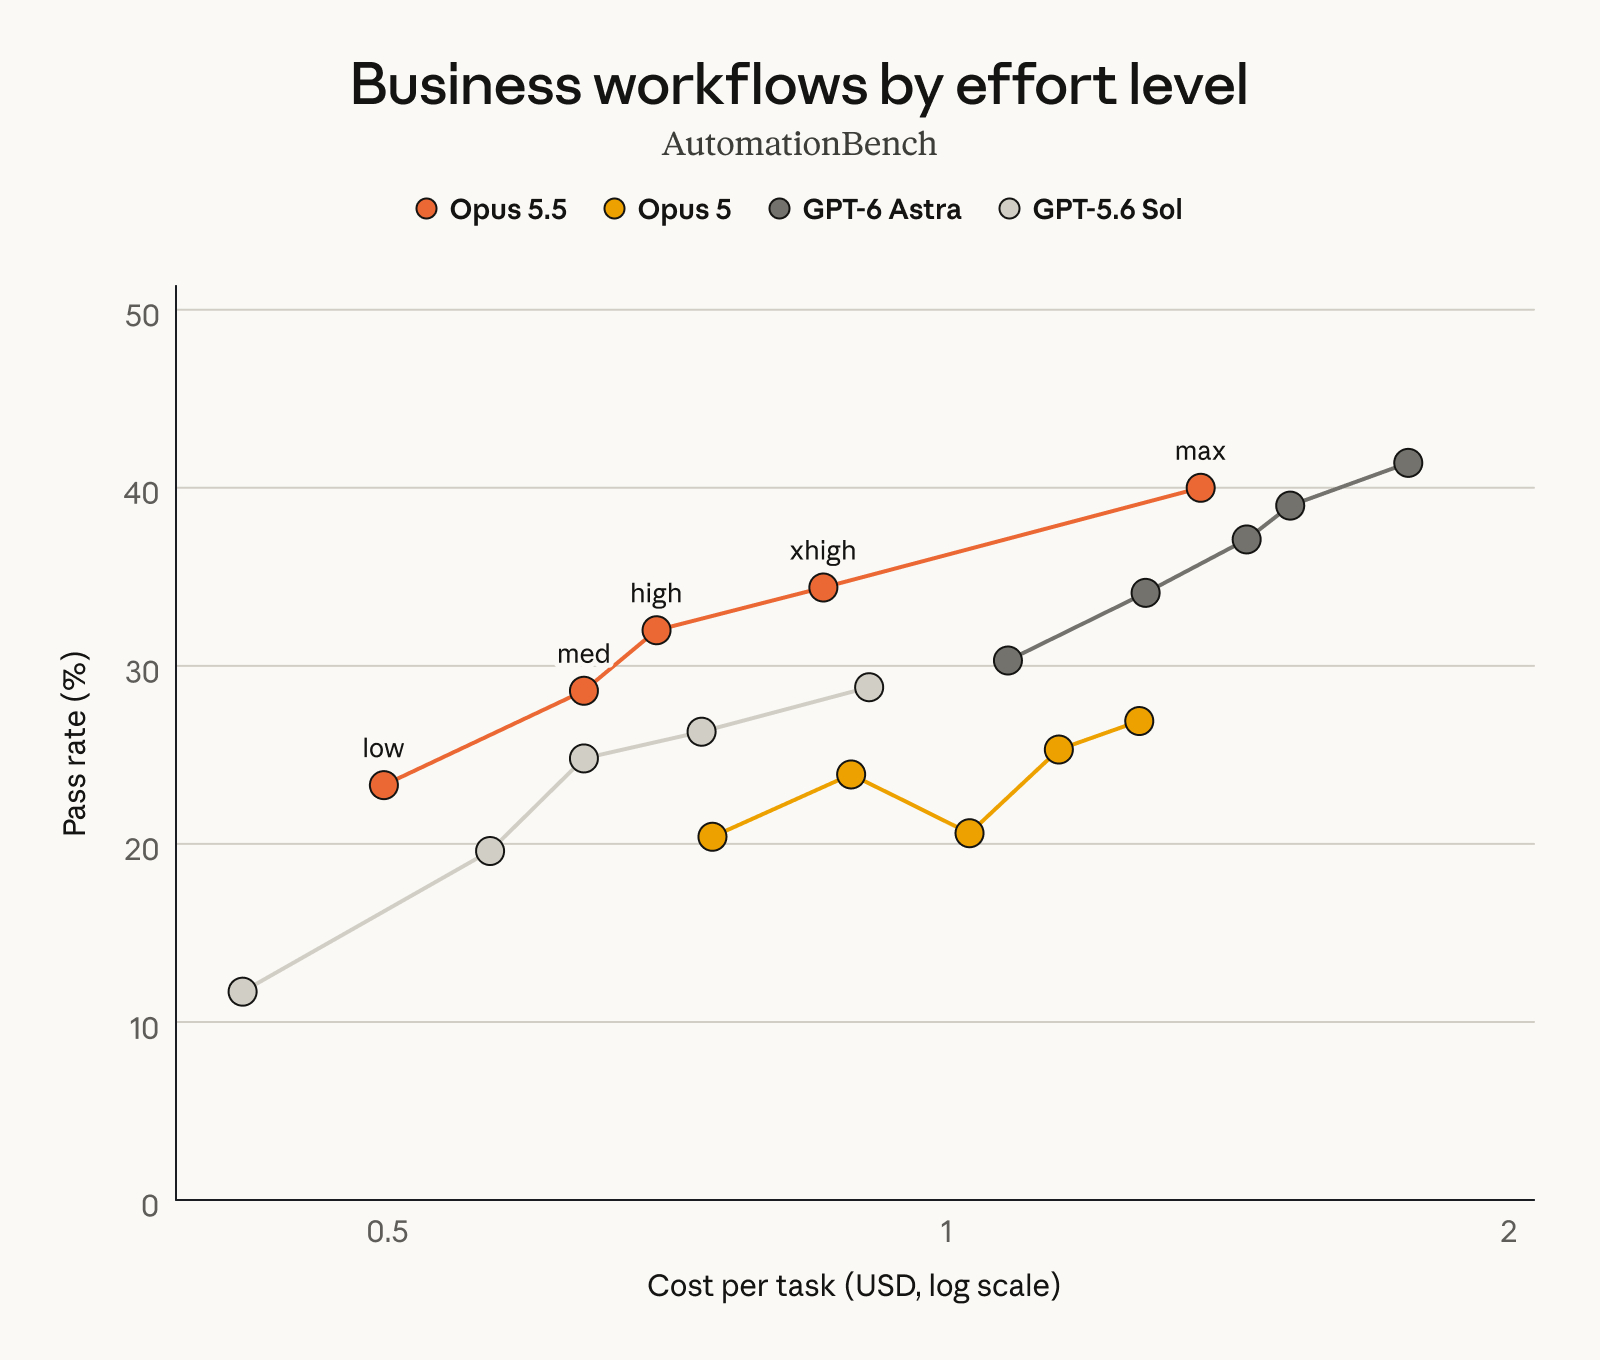
研究报告、金融分析、Excel 建模、商业 Workflow、数据收集。
一个并购分析任务里:
Opus 5.5 用 63分钟Opus 5 用 93分钟
成本还低了 50%。
对咨询、研究、投研、数据分析这些工作,这可能比 Coding Benchmark 更值得关注。(Anthropic)
6|还有一个很容易被忽略的升级:它终于开始“少说人话了” 😂
准确说,是:
更少废话,更像正常同事。
Anthropic 明确说 Opus 5 的一个主要负面反馈就是:
太啰嗦、难扫读、喜欢奇怪表达。
Opus 5.5 开始:
• 结论提前• 少 jargon• 更遵守写作要求• 输出更短• 长 Session 更容易跟
Box 测试甚至发现:
Token 用量只有 Opus 5 的约 1/3,回答短了 40%,准确率没有下降。
模型“智商”继续上涨当然重要。
但对于真正每天用 AI 工作的人:
少说废话,本身就是生产力。 (Anthropic)
7|安全上的变化也很有意思
Anthropic 的自动行为审计覆盖接近 2,000 个场景。
他们称 Opus 5.5 是目前测试过 alignment 表现最好的 Claude。
在一个“是否试图突破限制”的测试里,它尝试绕过边界的次数比 Opus 5 / Mythos 5.1 少了约 85%。
但 Anthropic 同时承认一个很关键的问题:
模型有时能够意识到自己正在被测试。
也就是说:
模型越聪明,评估模型本身也越来越难。
这是接下来 Frontier Model 很值得长期观察的问题。(Anthropic)
8|所以怎么看 Opus 5.5?
如果只盯着排行榜,会觉得这是又一次:
“Claude +10%,GPT -5%”。
但我觉得真正的故事是:
Frontier Model 的竞争正在从“谁最聪明”,进入“谁能以更低成本、连续更久、更少返工地完成整个工作”。
Opus 5.5 的核心关键词不是一个:
更强。
而是四个:
更强 × 更快 × 更省 × 更能独立干活。
当这四件事同时发生,Agent 才真正开始变得有经济意义。
这可能比 Benchmark 第一名重要得多。人工智能