这是本人对未来几年光通信的终极预测,等到2030年的时候挖出来看看,纯个人研究,无投资建议,DYOR。
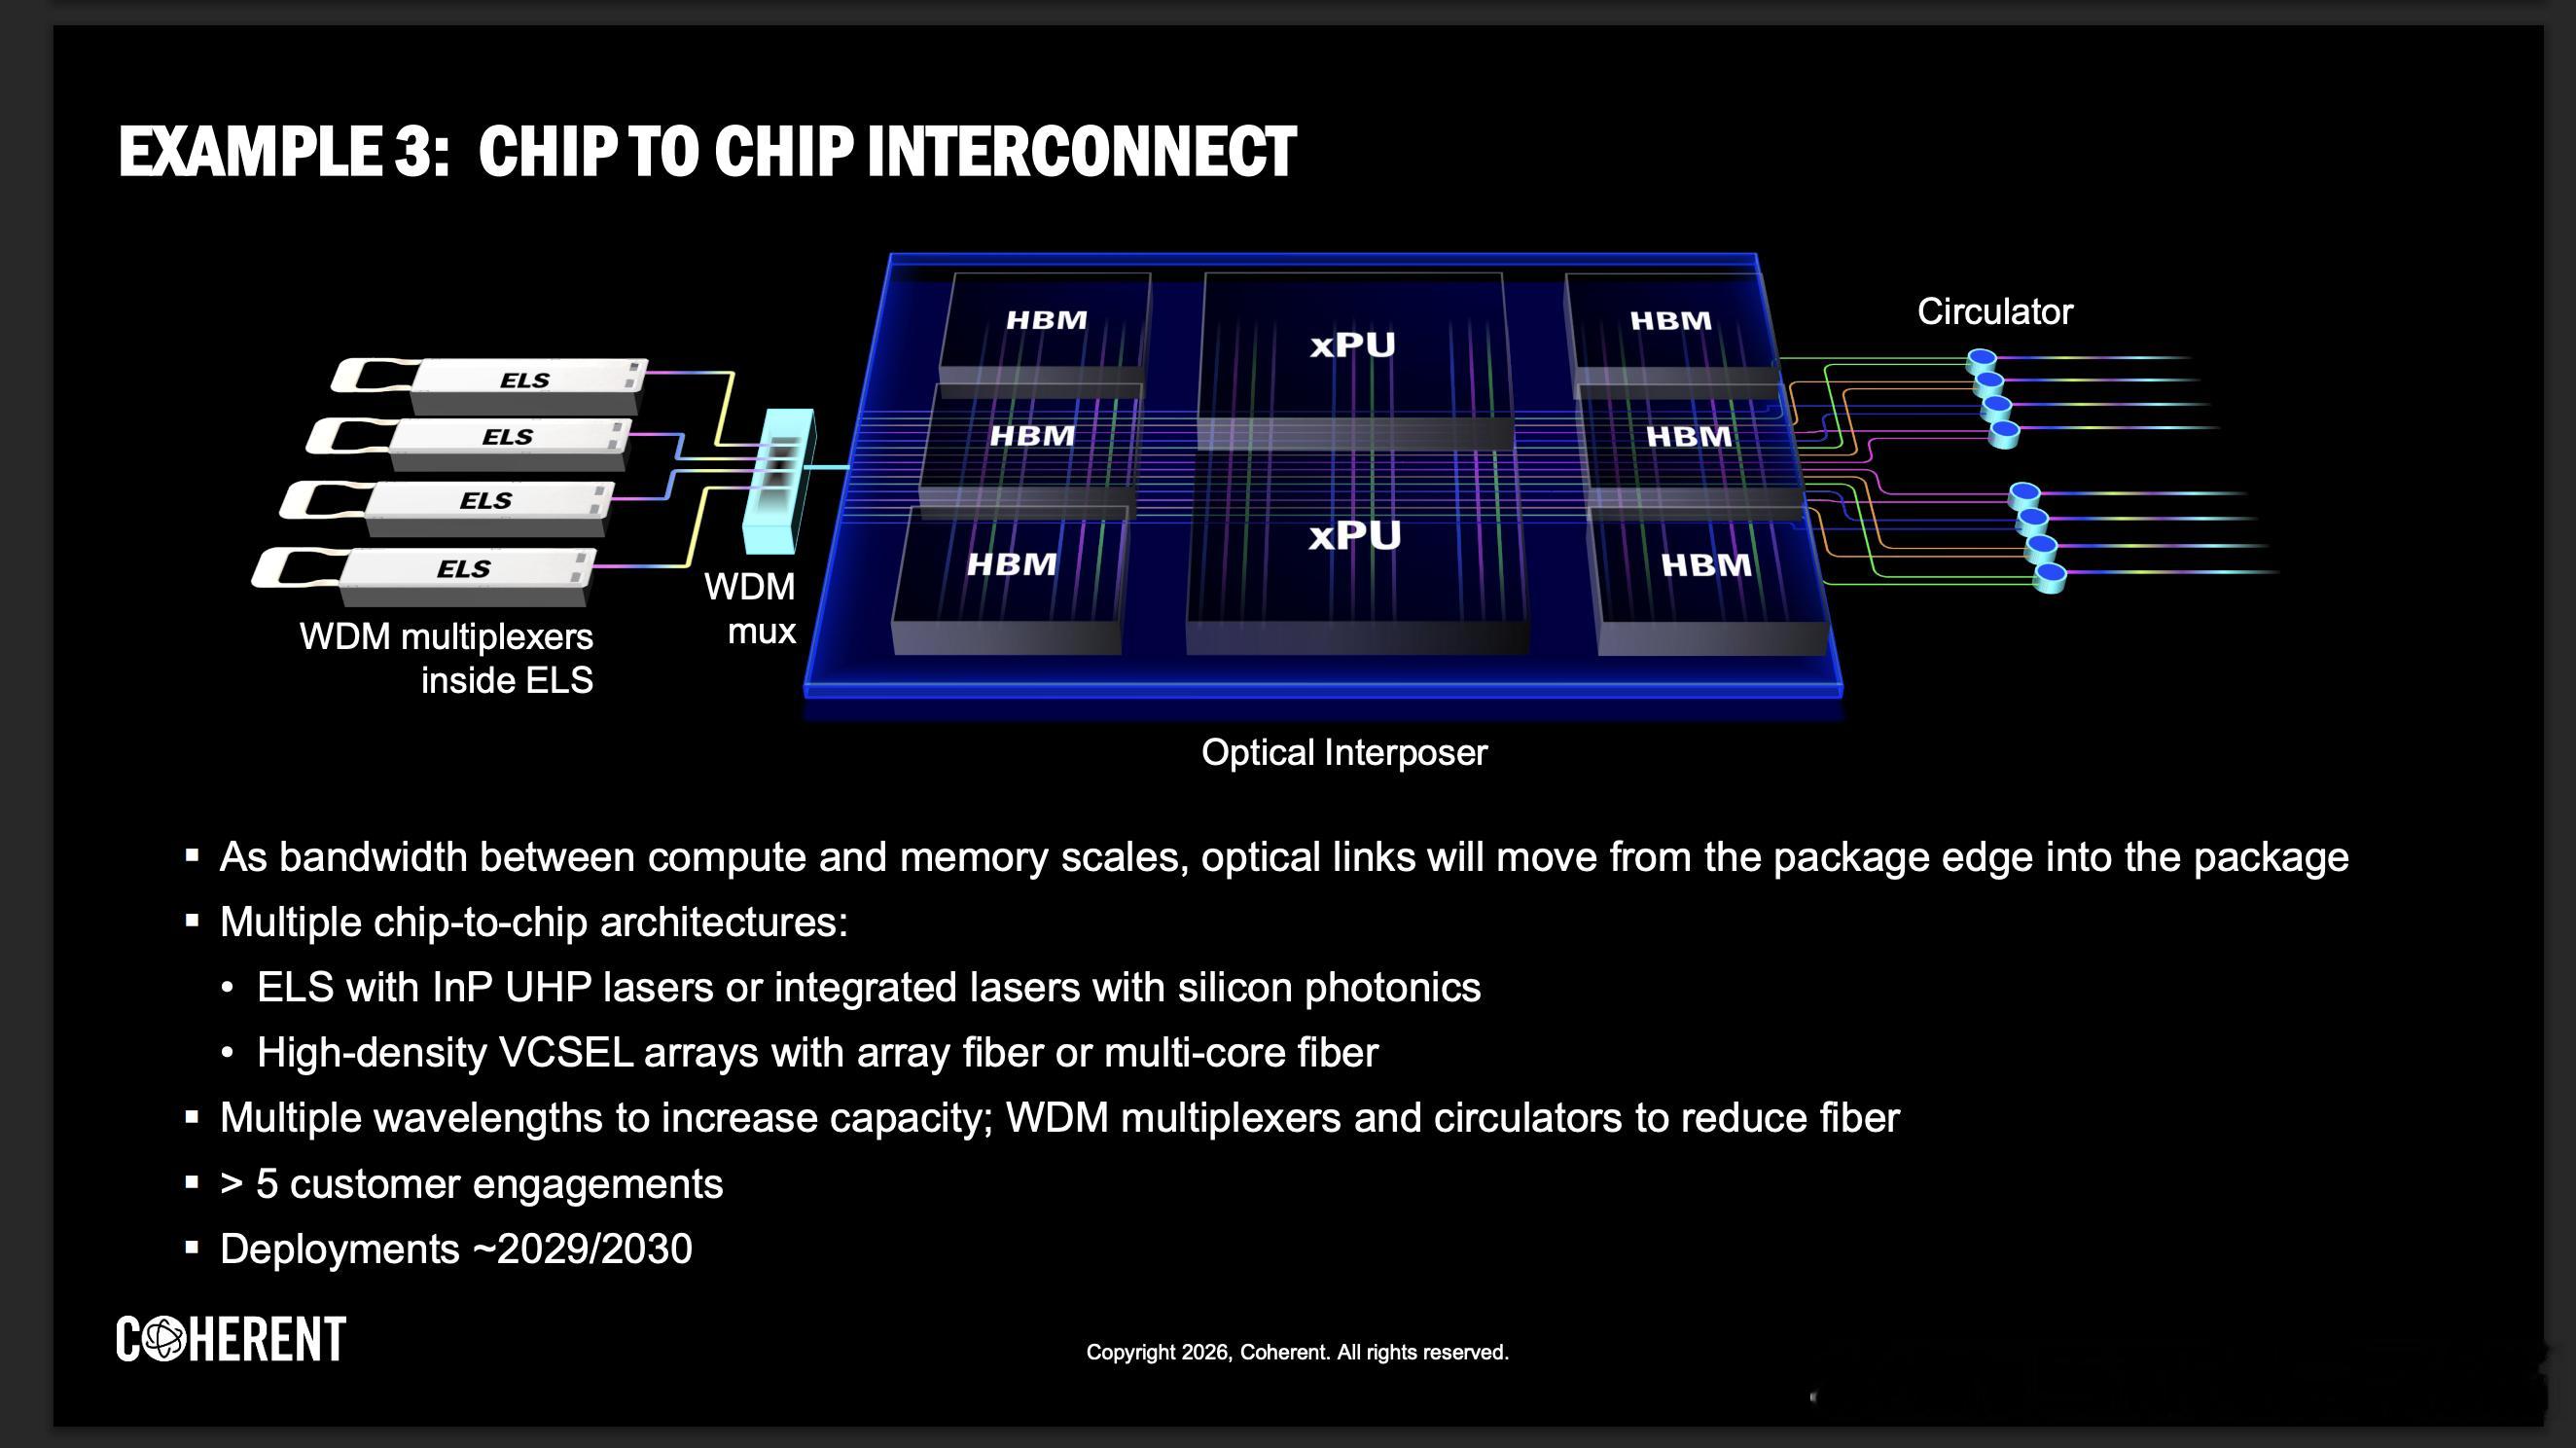
这波光通信至少要看到 2030 年,真正的终局可能不是 3.2T 光模块,而是光一路向芯片内部逼近,最终走向 OIO(Optical I/O)。
AI 集群的数据搬运正在从 Scale-out → Scale-up → Scale-in 不断向芯片靠近。越靠近芯片,带宽密度越高、距离越短,对 pJ/bit、Tbps/mm 和 latency 的要求也越极端。因此未来光互联不一定只有一条技术路线,而更可能形成一个连续谱:
1. Fast & Narrow:高速、少通道。延续当前光通信产业路线,通过 200G/lane → 400G/lane,不断提高单通道速率,主要依靠高速 SerDes、PAM、SiPh/EML、DSP 等技术。优势是 fiber 数量少、与现有产业链兼容度最高;代价是随着单 lane 速率继续提高,SerDes、DSP、功耗和信号完整性的难度快速上升。
2. Flat:中速率、中等并行度。不再一味追求 400G 甚至更高的单 lane,而可能把速率“冻结”在约 50–100G NRZ 的高能效区间,再通过更多 optical lanes、WDM 和 SiPh 提升总带宽。它本质上是在时间维度和空间维度之间重新做 trade-off:牺牲部分 lane 数量,换取更低的 SerDes/DSP 复杂度和更低 pJ/bit。这条路线尤其值得关注,因为它可能成为今天 NPO/CPO 向未来 chip-to-chip / die-to-die Optical I/O 演进的桥梁。
3. Slow & Wide:低速、超高并行度。进一步降低单通道速率,用数百甚至更多 optical lanes 搬运数据,把复杂度从高速 SerDes 转移到 massive-parallel optical I/O。这里 microLED、microVCSEL 等 micro-emitter 都可能成为候选方案,配合高密度 fiber / multicore fiber、光连接器和先进封装,最终把光真正推进 package 甚至 die 边缘。
因此真正值得跟踪的,不只是 “SiPh 还是 microLED”,而是 AI 芯片 I/O 架构会在什么位置找到最优解:
Fast & Narrow → Flat → Slow & Wide
背后的核心变量则是:
SerDes speed ↓ / optical lane count ↑ / bandwidth density ↑ / pJ per bit ↓
如果 AI Scale-in 最终要求 chip-to-chip / die-to-die 带宽逐渐逼近 memory bandwidth,那么光通信的长期空间可能远远不只是今天的 800G/1.6T/3.2T Scale-out 光模块,而是继续向 NPO/CPO → Optical Engine → OIO → chip-to-chip / die-to-die optical fabric 扩张。
从这个角度看,2030 年更像是光通信价值量继续向芯片内部迁移的中途站,而不是终点