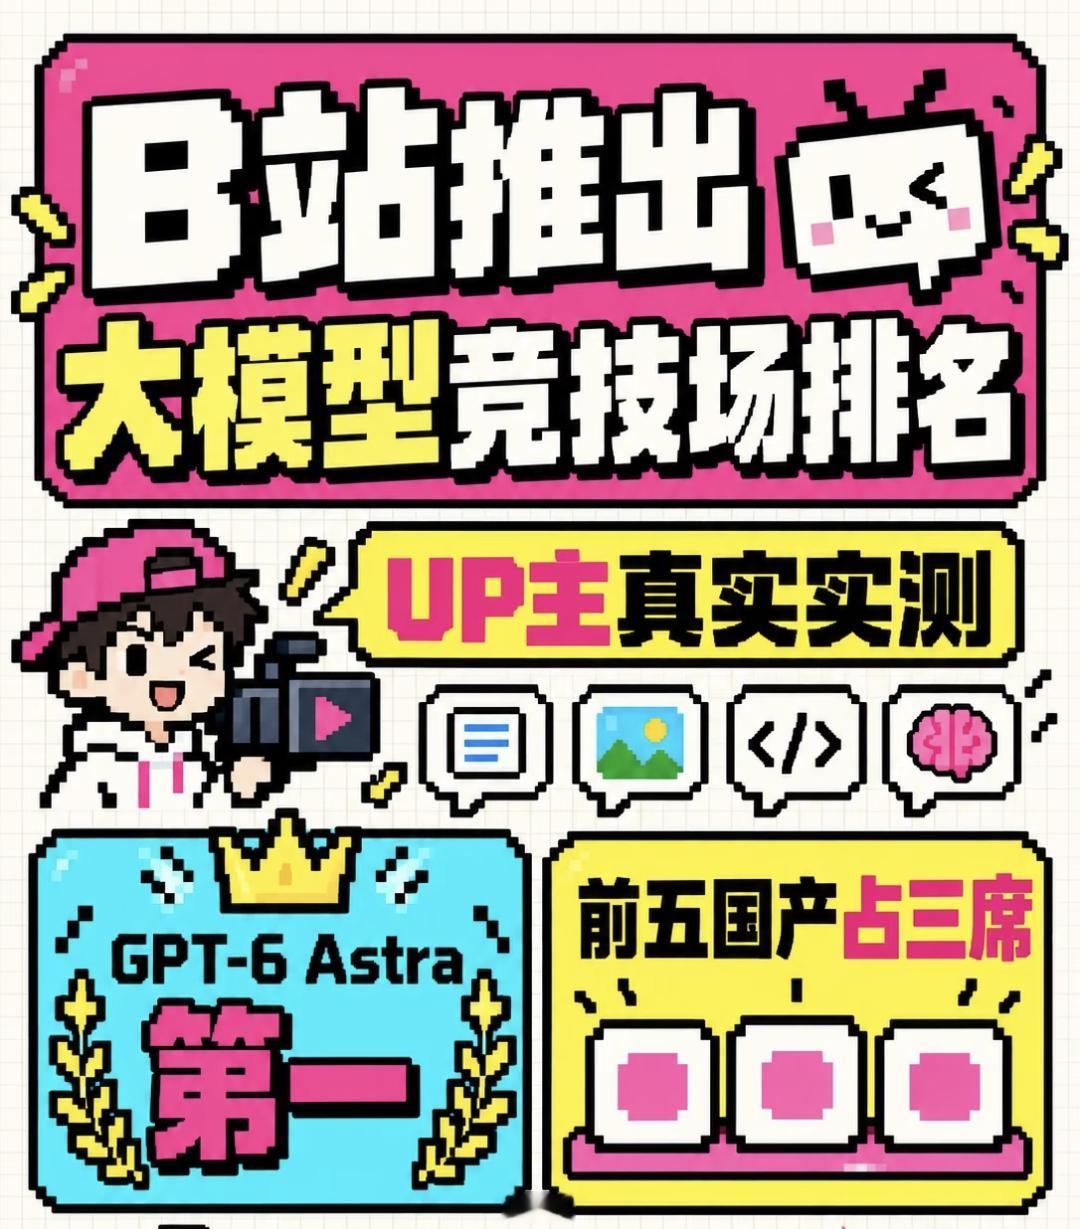
B站9月16日上线“AI无限竞技场”,玩法很接地气:不设主题限制,由UP主根据自己的真实工作流自主命题,让上百个大模型同题PK。
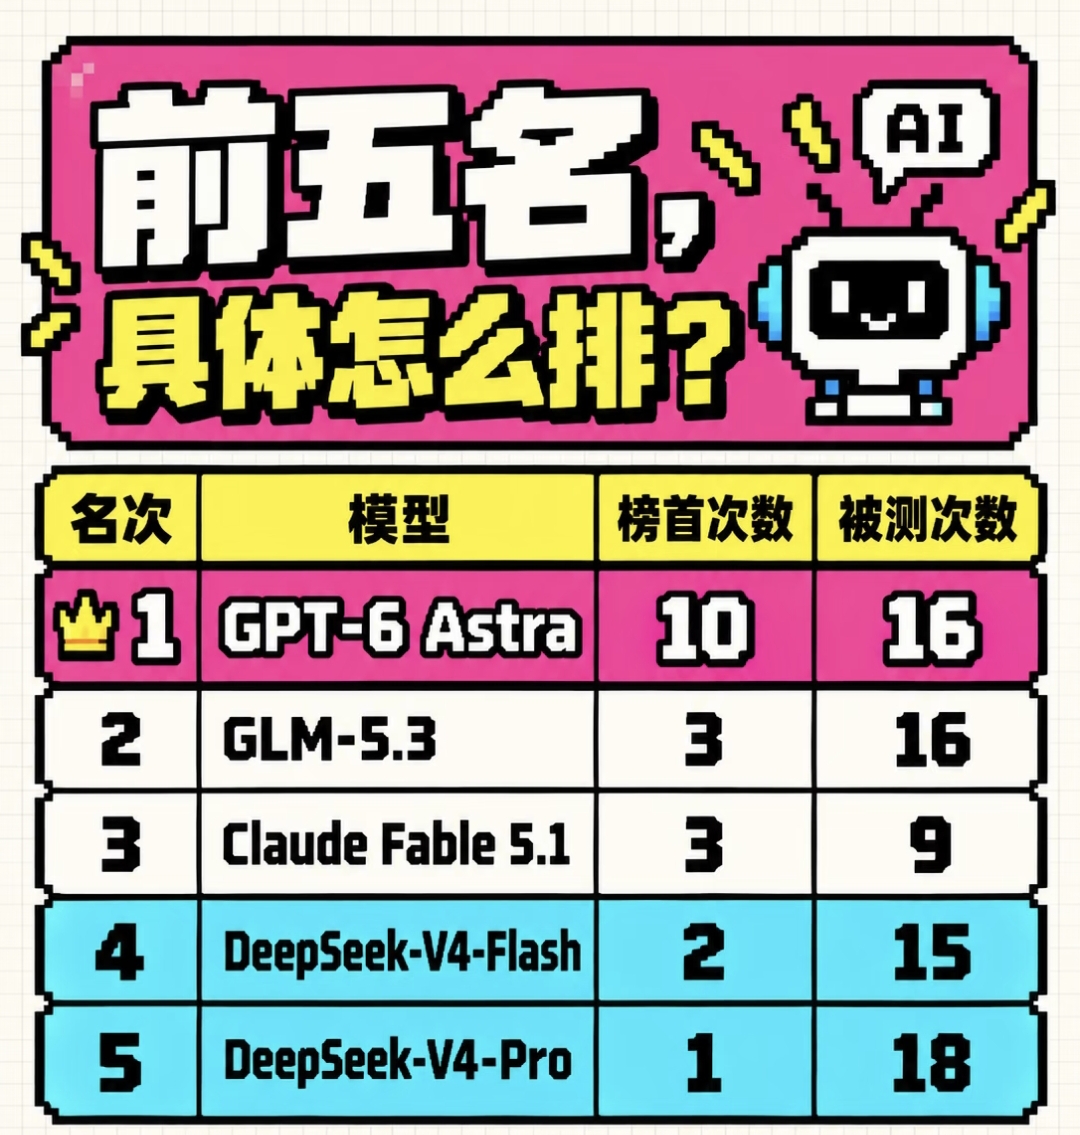
首期榜单GPT-6 Astra拿下榜首,但前五名中国产大模型占了三个位置。有意思的是,同一个GPT-6在不同UP主的视频里表现差异巨大,代码修复稳如老狗,游戏开发偶尔翻车,中文语境下更是“水土不服”。
有UP主说了句大实话:“GPT-6确实更上一层楼了,但能不能始终稳定,还值得进一步观察”。
B站这波操作确实比厂商自己发的成绩单有说服力,因为出题的人是真正拿模型干活的人,题目里有“修祖传代码”“复刻游戏”这种真实场景,不是标准答案的应试考试。
有网友说得挺到位:“不少在榜单上亮眼的模型,落地表现平平,一些小众模型日常使用反而更加省心好用”。
GPT-6的Computer Use能力确实强,能自己进终端、跑测试、改代码、再跑测试形成闭环,但“一次测评跑出高分”和“一百次真实任务稳定交付”之间,差距比很多人想的大得多。