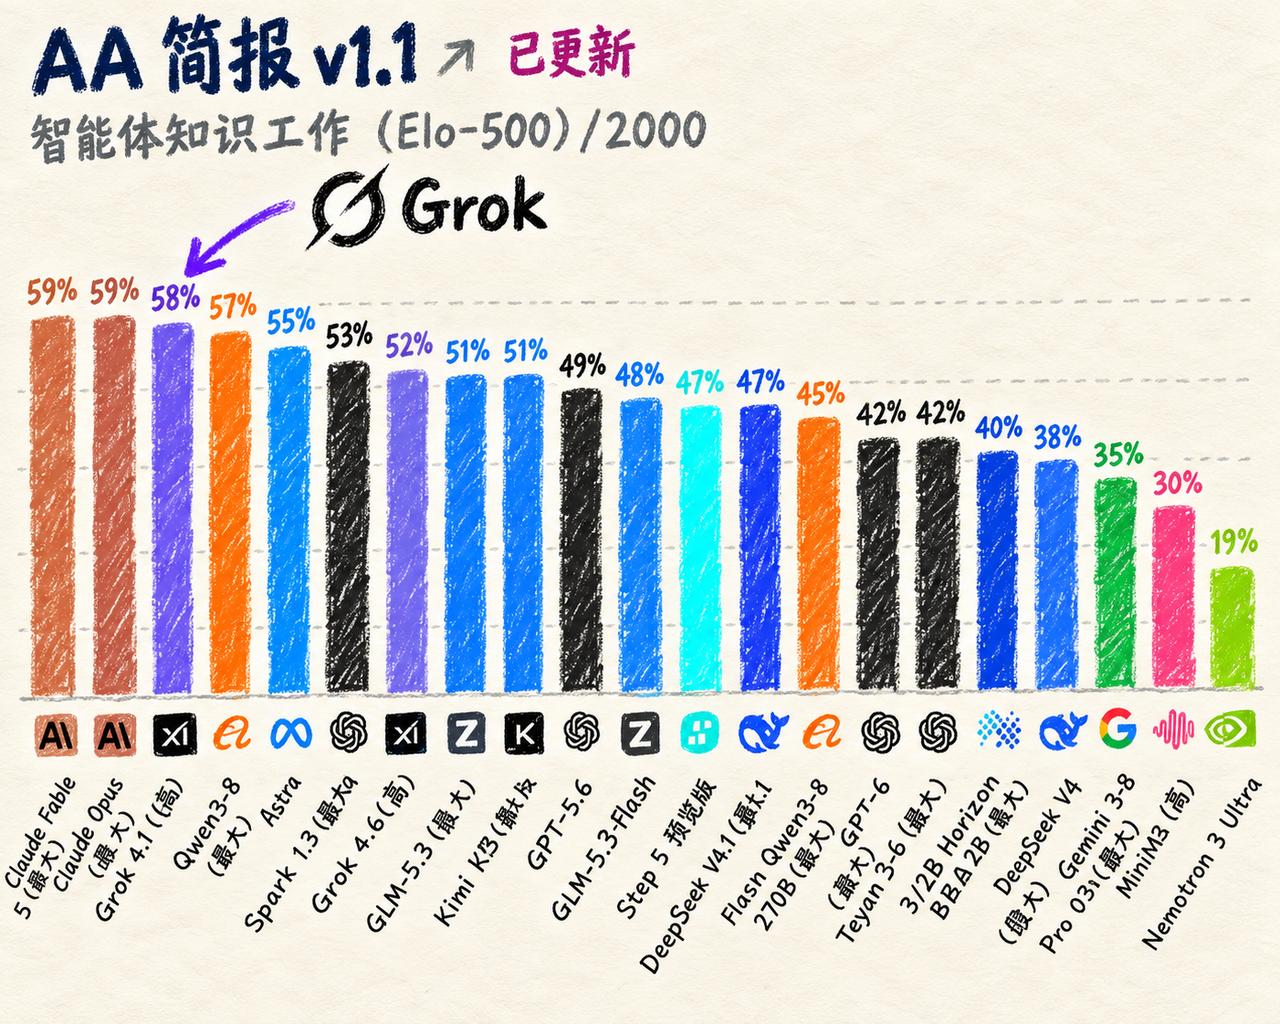
最新公布的 AA-Briefcase v1.1 榜单,马斯克刚刚发布的 Grok 4.7 xHigh 以 58% 的高分杀到贴脸,距离登顶仅差区区 1 个百分点。
阿里 Qwen3.8 Max 以 57% 紧随其后,甚至盖过了 53% 的 GPT-6 Astra。至于国产的 GLM-5.3 和 Kimi K3 分别拿下 51%,DeepSeek V4.1 也有 47% 的不俗表现,而以往被寄予厚望的 Gemini 3.8 Flash 居然跌到了 35%。
以前大家测试 AI,就像考小学生做选择题;现在的 AA-Briefcase 考核,相当于给 AI 发一个需求模糊、还包含三个错误数据集的压缩包,看它能不能在不逼疯老板的前提下,自力更生写代码、调 API、跑数据、清洗表格,最后把一份逻辑自洽的报告呈上来。
马斯克的 Grok 最早被大家戏称为社交平台上的黄毛,靠着说怪话和画梗图起家。
但事实证明,当 xAI 把算力堆到极限,开启 xHigh 推理范式之后,这台原本以为只会讲讽刺笑话的机器,干起脏活累活来居然比绝大多数所谓的正统精英还要硬核。
反观 OpenAI,GPT-6 Astra 居然落后 Grok 4.7 整整 5 个百分点,甚至被 Qwen3.8 反超。昔日的老大哥似乎陷入了挤牙膏的怪圈——名字叫得越来越像科幻大片,跑起 Agent 工作流来却像是在给老爷机上油。而谷歌 Gemini 3.8 的 35% 成绩,更是让人怀疑他们是不是把算力全拿去跑内部演示 PPT 的动画效果了。
当 AI 已经开始在长链条工作流里展现出接近甚至超越人类中阶白领的连续决策能力时,算力堆叠与思维链拓展的边际效益依然没有看到尽头。大模型的终局或许不是人类的导师,而是一个永动机般的超级外包团队。