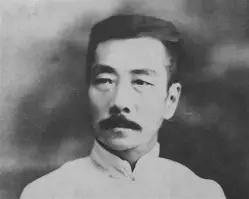
鲁迅曾称 :“天之所以高,是怕骄傲的人撞破头,地之所以厚,是怕聪明人看太透。留一份糊涂,让聪明者感受,存十分高远,让骄傲者低头。如果不懂得天高地厚,不知道天外有天,不明白人上有人,就会乐极生悲。”
先不要急着讨论这几句话有多深刻。把时间拨回120年前,会发现一个几乎一模一样的故事。1906年,英国作家Evelyn Beatrice Hall写了一本关于伏尔泰的书,她为了概括伏尔泰的态度,写下了一句后来举世闻名的话,结果后人渐渐把作者的概括当成了伏尔泰亲口所言。
几十年后,Hall还专门解释,那是自己的表达,并不是伏尔泰原话,可已经迟了。因为那句话太像人们心目中的伏尔泰:锋利、宽容、捍卫表达自由。于是一个人的思想形象,反过来替一句并非他说的话提供了身份证,这才是名言误传最顽固的机制。
今天这段署名鲁迅的“天高地厚”,恰好面临同样的问题。截至目前,没有可靠的一手文献能够证明它出自鲁迅。可很多人第一次读到时并不怀疑,因为里面有“聪明人”“骄傲”“天外有天”这些字眼,再加上鲁迅两个字,一段普通的人生劝诫立刻有了文学巨匠的重量。
问题也恰恰出在这里。真正的鲁迅谈“聪明人”,并不是在劝一个有能力的人把光芒收起来,免得别人嫉妒。1925年12月26日,他写下《聪明人和傻子和奴才》,其中那个“聪明人”很会表示同情,却什么也不改变;真正动手砸墙、准备给奴才开窗的是那个被称为“傻子”的人。
更有讽刺意味的是,当“傻子”真的挥手砸墙,奴才反而大喊抓人,最后把他赶了出去;等主人出来,奴才又因为护住房子得到夸奖。“聪明人”此时也重新出现,陪着奴才一起高兴。鲁迅这一笔真正刺中的,是安慰代替行动、精明代替改变之后形成的自我满足。
这么一比较,两种“聪明”几乎走向两个方向。网传版本告诉读者,人太耀眼容易遭妒,因此应当懂得隐藏;鲁迅笔下却把一个只会顺着现实、安慰别人、从不真正动手的角色叫作“聪明人”。前者教的是降低风险,后者追问的是:如果聪明只剩趋利避害,这份聪明究竟还有多少价值。
因此,今天真正值得讨论的已经不是“鲁迅这句话假不假”这么简单,而是谁在重新塑造我们心中的鲁迅。把鲁迅变成一个不断提醒年轻人少出头、别露锋芒、凡事留退路的“人生导师”,传播起来当然舒服,却可能恰好削掉鲁迅文字里最不好消化的那一部分——行动、质疑和不肯轻易接受现成答案。
这种改造过去靠语录书、公众号和朋友圈完成,现在又增加了AI。2026年9月2日,中央网信办公布的一组数字很有分量:专项行动已经清理违法违规信息561万余条,查处4.9万余个账号,处置2400余个违规网站和应用,“利用AI制作发布虚假信息”和“假冒仿冒他人”都是明确整治对象。
这组数字说明的并不是“以后假话会消失”,而是生产假内容的成本已经降得非常低。一张假照片还需要生成,一段假视频还需要模型,可制造一句“鲁迅说”,几乎只需要几十个字。它没有面部破绽,没有口型错误,也没有背景穿帮,复制到下一篇文章时连文件属性都没有留下。
国际技术界也在补这道漏洞。C2PA在今年7月发布新的实施指南,推动利用数字凭证保留内容的制作与修改来源;OpenAI也把内容验证从图像继续扩展到音频,并计划进一步覆盖文本。问题在于,来源凭证可以告诉人们一份文件经历过什么,却不能替读者判断里面那句“鲁迅说”究竟是不是真的。
到9月,Anthropic甚至已经开始在部分模型和平台推进文本水印。技术公司为什么开始盯上文字?因为大家逐渐发现,最容易跨平台流动的恰恰就是文本。图片重新截图还可能留下视觉痕迹,一句话却可以被人工重新敲一遍,从此与原始生成记录彻底脱开。
这才是以后看“名人金句”最麻烦的一关。AI可以制造一句很像鲁迅的话,另一个AI搜索到之后可能把它当资料,再有作者引用AI的答案继续发出去。经过几轮转手,最早那个连出处都没有的句子,会获得网页、截图、短视频甚至电子书相互作证,看起来比真的还真。
对中国读者来说,更值得珍惜的因此不是又收集到了多少鲁迅金句,而是还有没有耐心读鲁迅本人。一个1925年的短篇,把“聪明人”“傻子”“奴才”三个人放在一起,就比几十张人生语录复杂得多。经典的意义,本来就在这种不能被一句话迅速吃透的复杂之中。