分享下知名科技媒体「Every」对新模型 Jev 的评测,你大概就能清楚它为什么这几天会风靡科技圈,也能更清楚它的用武之处:
并非每个语言模型都必须要成为聊天机器人。企业在后台运行的业务流程中,需要快速、廉价且可靠的 AI 工作流:决定将客服请求路由到何处、核对发票是否与采购订单一致,或是将交易归类为潜在欺诈。
今天,新型 AI 实验室 TypeSafe 推出了 Jev,这款全新模型旨在生成代码可直接调用的结构化答案。
你只需要用大白话提问,即便问题非常主观或模糊,它也能针对是/否或你自定义的标签,直接返回对应的置信概率。
你可以把它想象成一个智能的 if-then 语句,用来决定自动化工作流中的下一步操作。
假设你在写一个客服工单系统,想按紧急程度排优先级。你在代码里向模型提问:“这位客户听起来很生气吗?”Jev 可能会返回 0.9。基于模型训练学到的规律,这一数值代表有 90% 的概率是肯定的。
你也可以提供自己定义的分类,例如“微愠”(annoyed)、“恼火”(irritated)、“感到被冒犯”(offended)、“狂怒”(furious)和“暴怒”(enraged),并得知该客户有 60% 的概率被归类为狂怒,而暴怒的概率仅为 10%。
得到 0.9 的回答(极有可能处于愤怒状态)后,软件可能会自动将客户问题升级给主管处理,而如果回答是 0.1(不大可能生气),该请求的优先级就可能被调低。
但聊天机器人的底色是输出客套的长篇大论,比如回复“您说得太对了,这位客户听起来确实怒气冲冲。需要我以友好安抚的口吻起草一封回信吗?”,而不是给出一个冰冷的数字。
程序需要的是 0 到 1 之间的数值,塞给它一篇小作文只会导致系统崩溃。
以往我常用 DSPy(一个用来给模型编程的 Python 框架)费尽心思地诱导 LLM,让它按指定格式吐出数据,而 Jev 原生就能做到这点,且快得惊人,成本也低得不可思议。
至于它在实际任务中的交付质量究竟如何,目前还是个未知数。
▶ 决策训练
TypeSafe 的思路是:直接训练模型输出下游软件决策所需的结构化结果。核心目标是让模型的置信度与实际命中率精准对齐:如果它判定 100 条客服留言中有 90% 的概率带怒气,那么现实中就该有大约 90 条确实是在发火。
模型返回的结果格式规范,且具备高度校准的概率值,以便下游代码据此触发下一步操作。TypeSafe 将这种训练方法称为 RLCD(校准决策强化学习)。
像 DSPy 这样的框架固然能帮开发者提升 LLM 在企业场景中的可靠性,但本质上,你依然是在强行把自由文本拧成结构化代码的形状。
TypeSafe 联合创始人 Diogo Almeida 在谈及研发初衷时对我直言:“问题恰恰出在文本本身。”
在 OpenAI 任职期间,Almeida 曾是 2022 年 InstructGPT 核心论文的合著者,该研究证实了人类反馈能让模型更稳定地遵循指令,直接为同年底 ChatGPT 的横空出世打下了地基。
如今,他的目标是做出一款更易构建高可靠工作流的模型,在吞吐速度与推理成本上真正接得住大规模工业级生产的检验。
正如 TypeSafe 团队的那句口头禅:“我们要造的是能上生产环境的工具(prod),而不是全知全能的神(God)。”
得益于 Almeida 团队研发、并经由 RLCD 训练的 System One(系统一)架构,Jev 彻底摆脱了传统 LLM 逐字、逐 Token 吐字生成的拖沓节奏。它能在几百毫秒内并发处理多个提问,综合成本也仅为常规 LLM 查询的零头。
Jev 的定价是每十亿 Token 42 美元,而市面上的 LLM 大多按每百万 Token 计价。
更极致的是,TypeSafe 甚至不对输出 Token 计费。Almeida 评价道:“这些输出便宜到了懒得计量的程度。”
▶ 极限实测
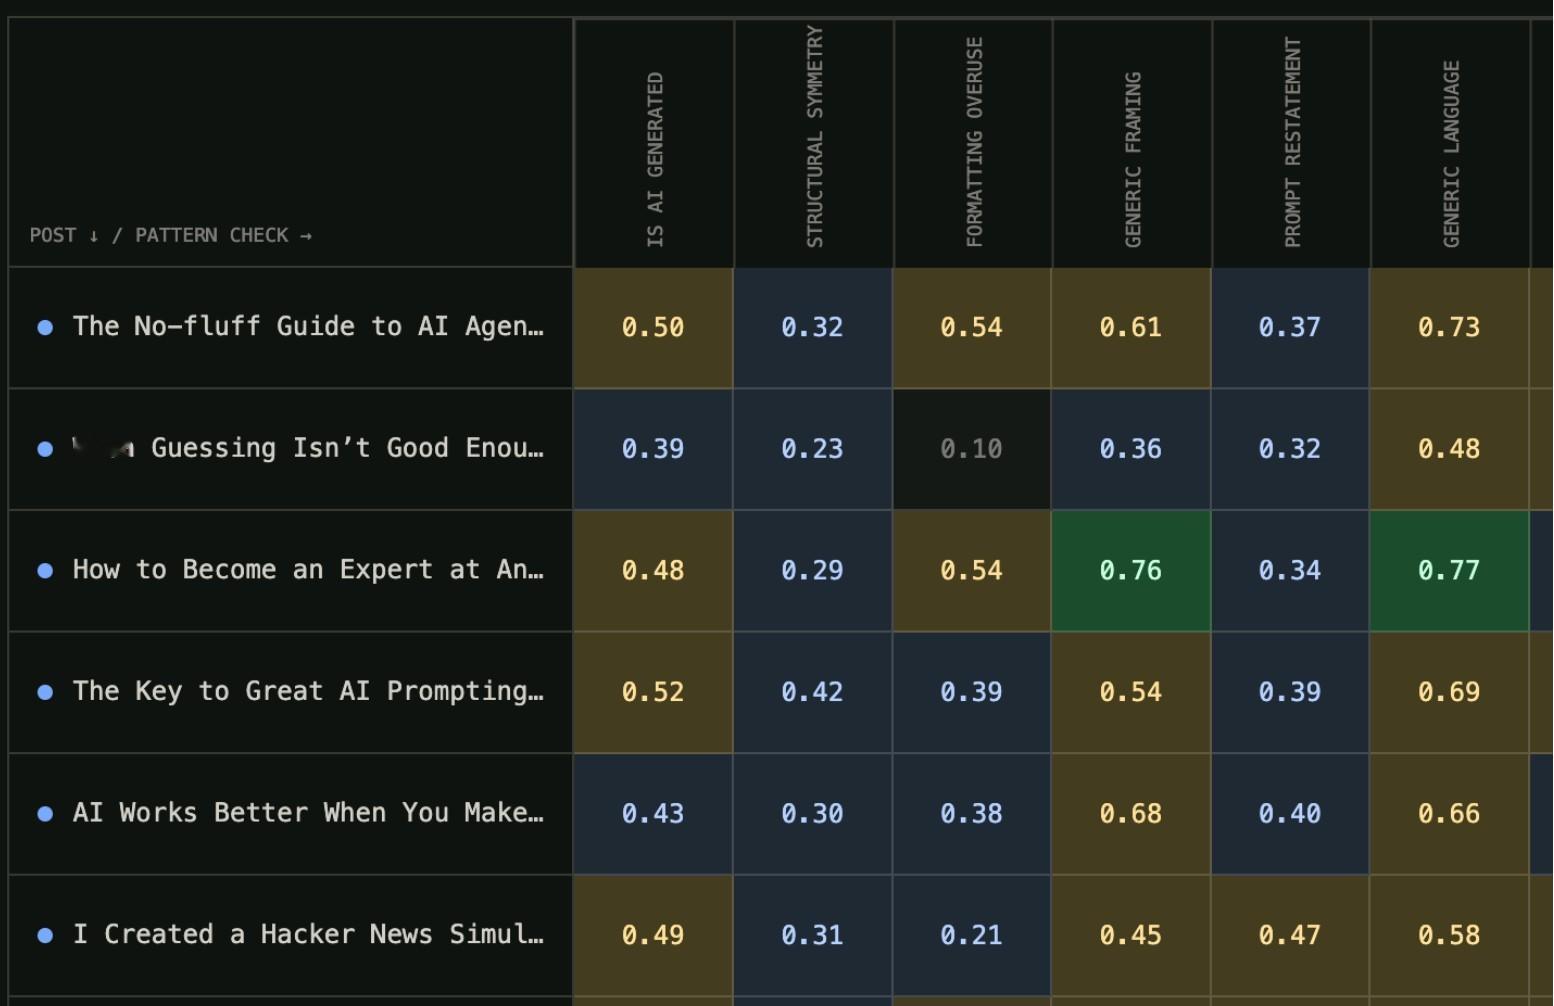
我先做了一个极限测试:把自己在 Every 上发表的全部 27 篇文章,外加 10 篇刻意写成 AI 腔调的对照文章,一股脑全喂给 Jev。随后,我对这 37 篇文章同时并发抛出相同的 21 个问题,地毯式排查 AI 味。
这套问题清单提取自我们内部专打 AI 写作通病的质检规则,比如:“文章是否在缺乏论据时车轱辘话来回说?”“是否强行凑出‘各打五十大板’的对称论证?”“是否对显而易见的浅显概念过度解释?”
仅仅耗时不到 0.7 秒,Jev 便读完了整整 37 篇长文,并逐一回答了每篇底下的全部 21 个问题。
它一次性输出了 777 个明确判断,消耗的成本折算下来只有四分之一美分。这番速度与开销,意味着你哪怕想把全公司所有人写过的所有文字通通筛一遍 AI 质检,结果也能秒级呈现。
当然,敢不敢完全信任这套结果是另一码事。细看分类结果,Jev 确实精准挑出了我那几篇对 AI 依赖度较高的稿子,但在敢将其挂载到正式生产线之前,我依然会要求做一轮更严苛的准确率校验。
可即便有此保留,它作为一道前置预警网也已足够超值:毕竟,不用它的代价就是直接裸奔。
我总共运行了 11 项实验来探索不同的用例(这里有一份更详细的说明),例如:
查找上下文:查找正确的代码文件,协助 Agent 浏览代码库,检索能够回答某个问题的公司政策。
检查工作:对客户支持回复进行评分,标记 Agent 提议的高风险操作,检查我的写作中是否存在 AI 痕迹。
做出决策:对初创公司的路演提案进行排序,对需要帮助的客户进行优先级排序,识别需要 CEO 参与的决策,决定哪些邮件需要在今天回复,询问 100 位模拟人物他们会点击哪则广告。
贯穿这一整套评测,TypeSafe 累计给出了 1,709 次判定,预估总开销还不到一美分。
这些测试场景是我借助 Codex 里的 GPT-6 Astra 搭建的。它完全不需要我额外引导,自己就读懂了 TypeSafe 的开发文档。
而这正是传统 LLM 的用武之地:它们擅长编写查询条件,并直接消费返回的结构化数据。
▶ 流程质检
在软件工程里,Linter(代码检查工具)是一种能在你写代码时即刻揪出语法错误、捕捉 Bug、识别不良模式并统一代码风格的静态检查工具。
而 TypeSafe 的模型擅长把模糊任务极速转化为清晰的结构化答案,恰好能成为知识工作领域的代码 Linter。
只要让 Codex 或 Claude 接入 Jev 并配上一份排查清单,大模型就能随时给自己的输出做体检,排查掉你提前设定的禁忌。
在 Every,我正为全公司每位员工搭建个性化的能力评测基准。既然打分工作总得有人做,我便一直在用 AI 来给其他 AI 的输出把关。
具体做法是:挑出你日常处理的 5 到 10 项高频任务,存好范例,再把你的主观偏好转化为一个个明确的合格/不合格检查点。比如:“这份 PPT 符合品牌调性吗?”“这篇社媒文案开头够不够抓人?”或者“模型的推荐和我的思路一致吗?”
我们将模型的判定与你的真实判断反复比对并持续调优,直到这套评分能切实指导你在实际工作中选用哪款模型或技能组合。
Jev 的极速与廉价,让这类检查不再局限于事后抽检少数标杆任务,而是能在任务推进的过程中多次、实时地随行触发。
Every 首席执行官 Dan Shipper 更直接地测试了这套代码 Linter 方案。针对这次测试,他专门生成了 12 个测试样本文段,其中 6 段行文清晰,另外 6 段则故意埋入逻辑缺陷,并让 Jev 和 Fable 5.1 同时运行同一套四项写作质检。
这 4 项检查直指具体瑕疵:某项行动是否缺乏合理解释、论证链条是否脱节、是否用实现机制偷换了最终结果,以及某个断言是否歪曲了引用的信源。
在单段文本的处理上,Jev 的耗时中位数为 0.35 秒,而 Fable 5.1 在高算力消耗(high effort)模式下耗时 8.83 秒,Jev 快了近 25 倍,预估调用成本更是只有后者的 1/580。
不过在准确度上,预设的 7 处缺陷中 Jev 抓出了 6 处,Fable 则是 7 处全中。
比如有一段写道:“一个由家长与教职员工共同去‘教’的共享预约日历”。究竟什么叫“教日历”?
面对这种违背常理且未作解释的操作,Fable 一眼就揪了出来,而 Jev 跑了三次测试全部漏检。但考虑到成本只是对方的一个零头,7 处查出 6 处的成绩已经足够亮眼。
正如 Astra 凭借出色的 Computer Use(电脑使用)能力重构了工作方式,这类专攻轻量判定的小模型也将开辟新的可能性。
试想一下:Codex 或 Claude 每写完一个段落,就顺手调用 Jev 跑一遍规则质检,一旦 Jev 标记出潜在问题,主写作模型立刻复查并就地修正,确认无误再继续下一段。
最终呈现在你眼前的,将是一份通关所有质检规则的终稿,人类再也不需要被死死绑定在每一个审校环节中充当人工安全带。
▶ 落地建议
如果你正在用 AI 搭建应用或工作流,不妨从日常中那些最频繁、最机械的判定环节切入,作为检验 Jev 的试金石。
拿我自己的场景来说,就是两件事:Agent 是否找对了上下文,以及输出结果是否达标。
正是由于 TypeSafe 将速度提了上去、把成本压到了地板,我们才敢在任务执行的每个节点上高频追问这几个问题,而不必把风险全积压到流程终点让人肉兜底。
对于在自动化工作流方面涉水不深的开发者而言,驾驭这种新型模型可能需要打破既有思路,但只要你的业务场景存在输入模糊问题、索取结构化判定的需求,Jev 都值得立刻上一套实测。
我们很难得遇上一种全新形态的模型,而过去受制于成本与延迟而无法落地的构想,眼下正迎来转机。你不妨翻出那些曾因现有 LLM 分类太慢、太贵而被搁置的 Idea。
将其准确率与通用 LLM 横向对比,看它能否胜任你的业务精度。归根结底,衡量它的终极标准只有一个:根据它的判定直接驱动下游动作,到底有没有让整套工作流变得更好。
Jev为何火爆AI圈