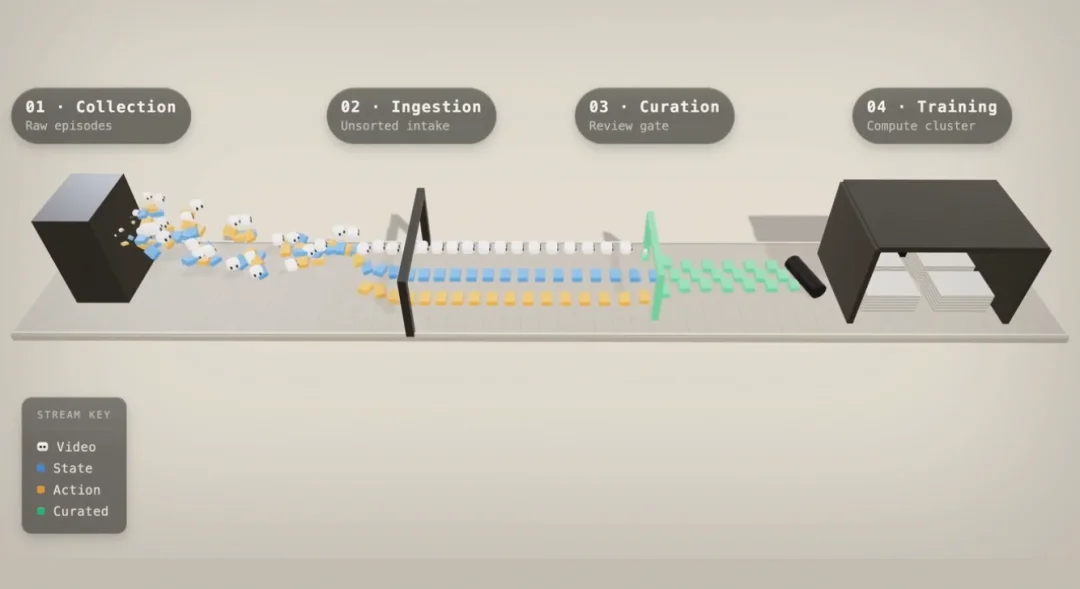
过去两年,具身智能大多沿着一条熟悉的路线发展:收集数据、训练模型、部署测试,再进入下一轮训练。
RSI(Recursive Self-Improvement,递归自我改进)要求更高。系统完成一次改进后,还要能自主设计实验、生成训练信号、优化模型,让下一轮改进更有效。
数字世界已经出现了这种趋势,北美科技公司正将其带入真实研发流程。
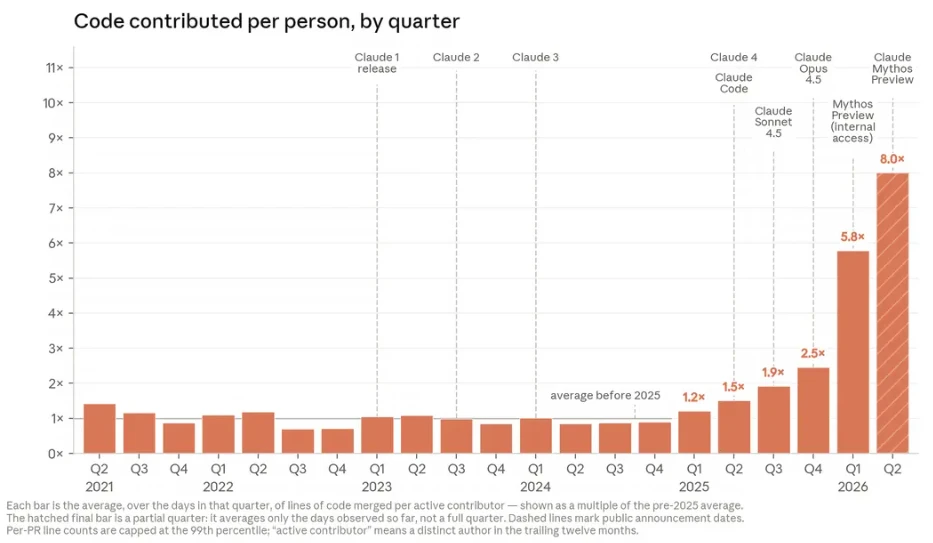
Anthropic披露,Claude已经参与代码编写、实验执行和研究建议。在部分工程任务中,它的成功率半年内提升到76%;在一项小模型训练代码优化测试中,最高加速幅度从约3倍提高到约52倍。
但Anthropic仍认为,这还没有达到真正的 RSI,Claude在自主选择研究目标、做出关键判断和开发后续版本方面仍需提升。
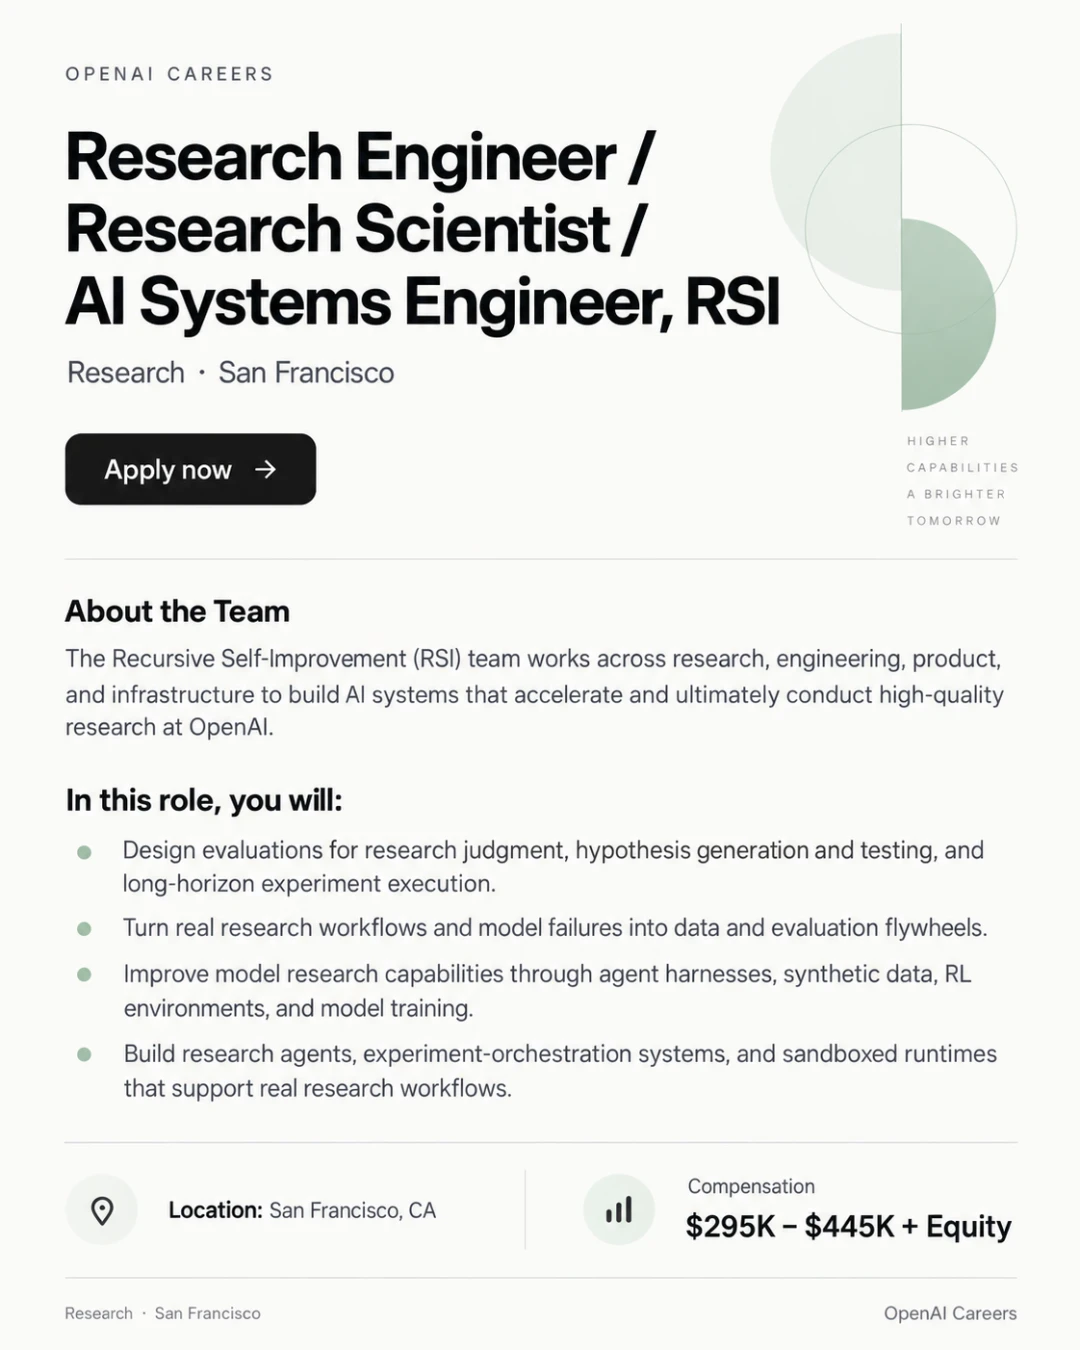
OpenAI已经成立 RSI 团队,研究让 AI 提出假设、运行长周期实验、分析失败,并把研发过程转化为训练数据和评测飞轮。但安全问题同样悬而未决,系统越强,也可能越难监控。
Google DeepMind把递归自我改进列为从 AGI 走向 ASI 的潜在路径。AlphaEvolve已经能够生成程序、评估方案并持续迭代,还优化过 Gemini 训练中的矩阵运算,使相关运算加速约23%。
机器人面对的情况复杂得多。
数字实验可以在计算环境中运行,机器人却必须到真实场景中验证,还会遇到环境变化、硬件差异和任务失败。
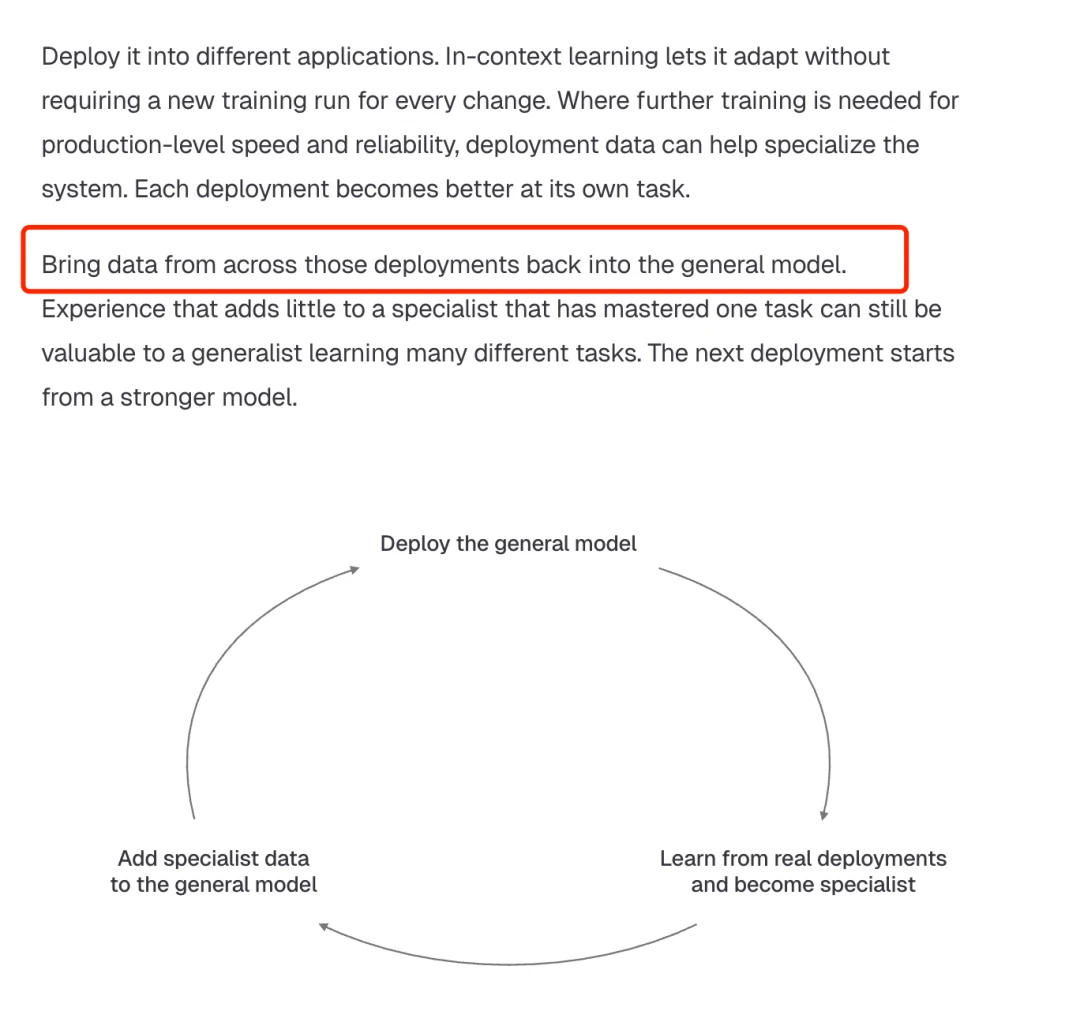
Skild AI提出Physical RSI让机器人在真实场景中边工作边学习,再将经验回流至通用模型,模型变强后进入下一轮部署。Physical Intelligence的真实机器人训练、Dyna的集群经验回流,也接近这一方向,但尚未正式称为RSI。
中国也有一些公司积极使用“具身RSI”或“物理RSI”概念,例如SeeAct AI、MirroS、瞬适科技等。
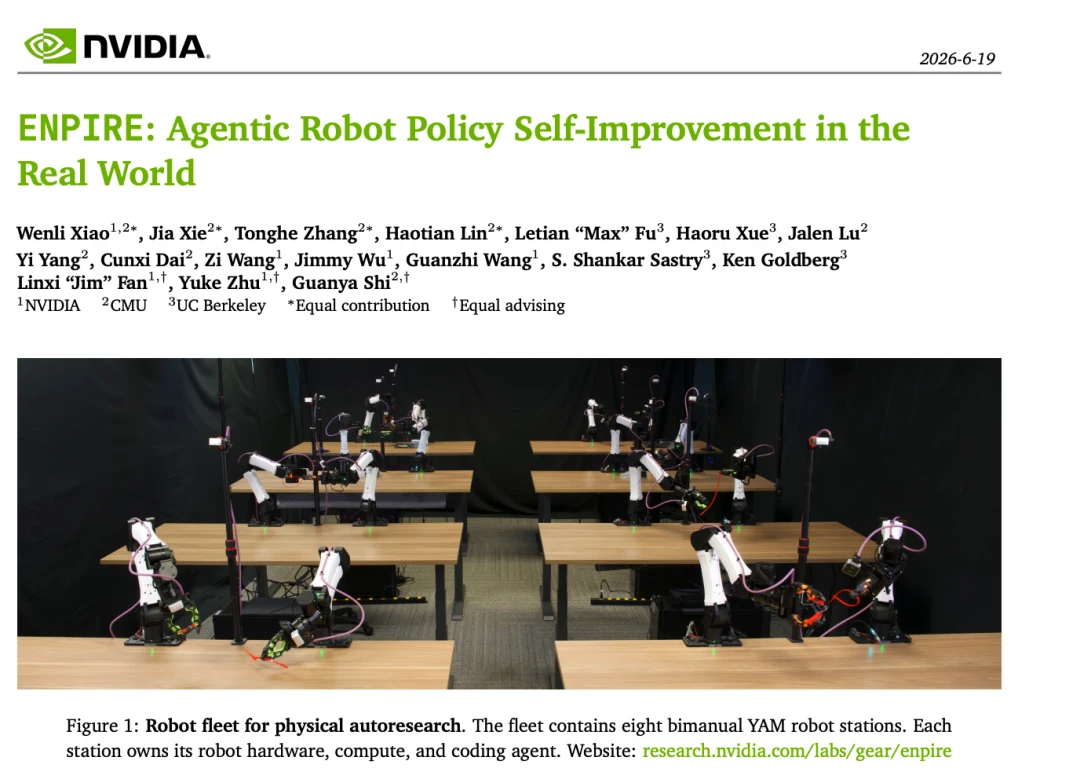
相关论文仍然很少。Motus2和 Jim Fan团队的 ENPIRE 都探索了策略自我改进,但没有直接称为 RSI。
有数据飞轮、持续学习和自动化实验,还不能证明RSI已经成立。
关键在于:改进后的机器人能否设计更有效的实验,获得更好的训练信号,学会新技能,并持续提升自我改进的效率。
目前,数字RSI已进入研发议程,具身RSI仍处于初级阶段。机器人距离“自己进化”还有多远,取决于它能否让下一次学习本身变得更有效。
#具身智能 #机器人 #RSI #递归自我改进 #强化学习 #人形机器人