如果说前两年,大家评价机器人的时候,看的还是它能不能做后空翻等炫技表演,那今年的标准明显变了。
近期行业里更常聊的话题,是机器人能不能真的融进一个人的场景里,跟一群人自然相处、真实上岗服务。
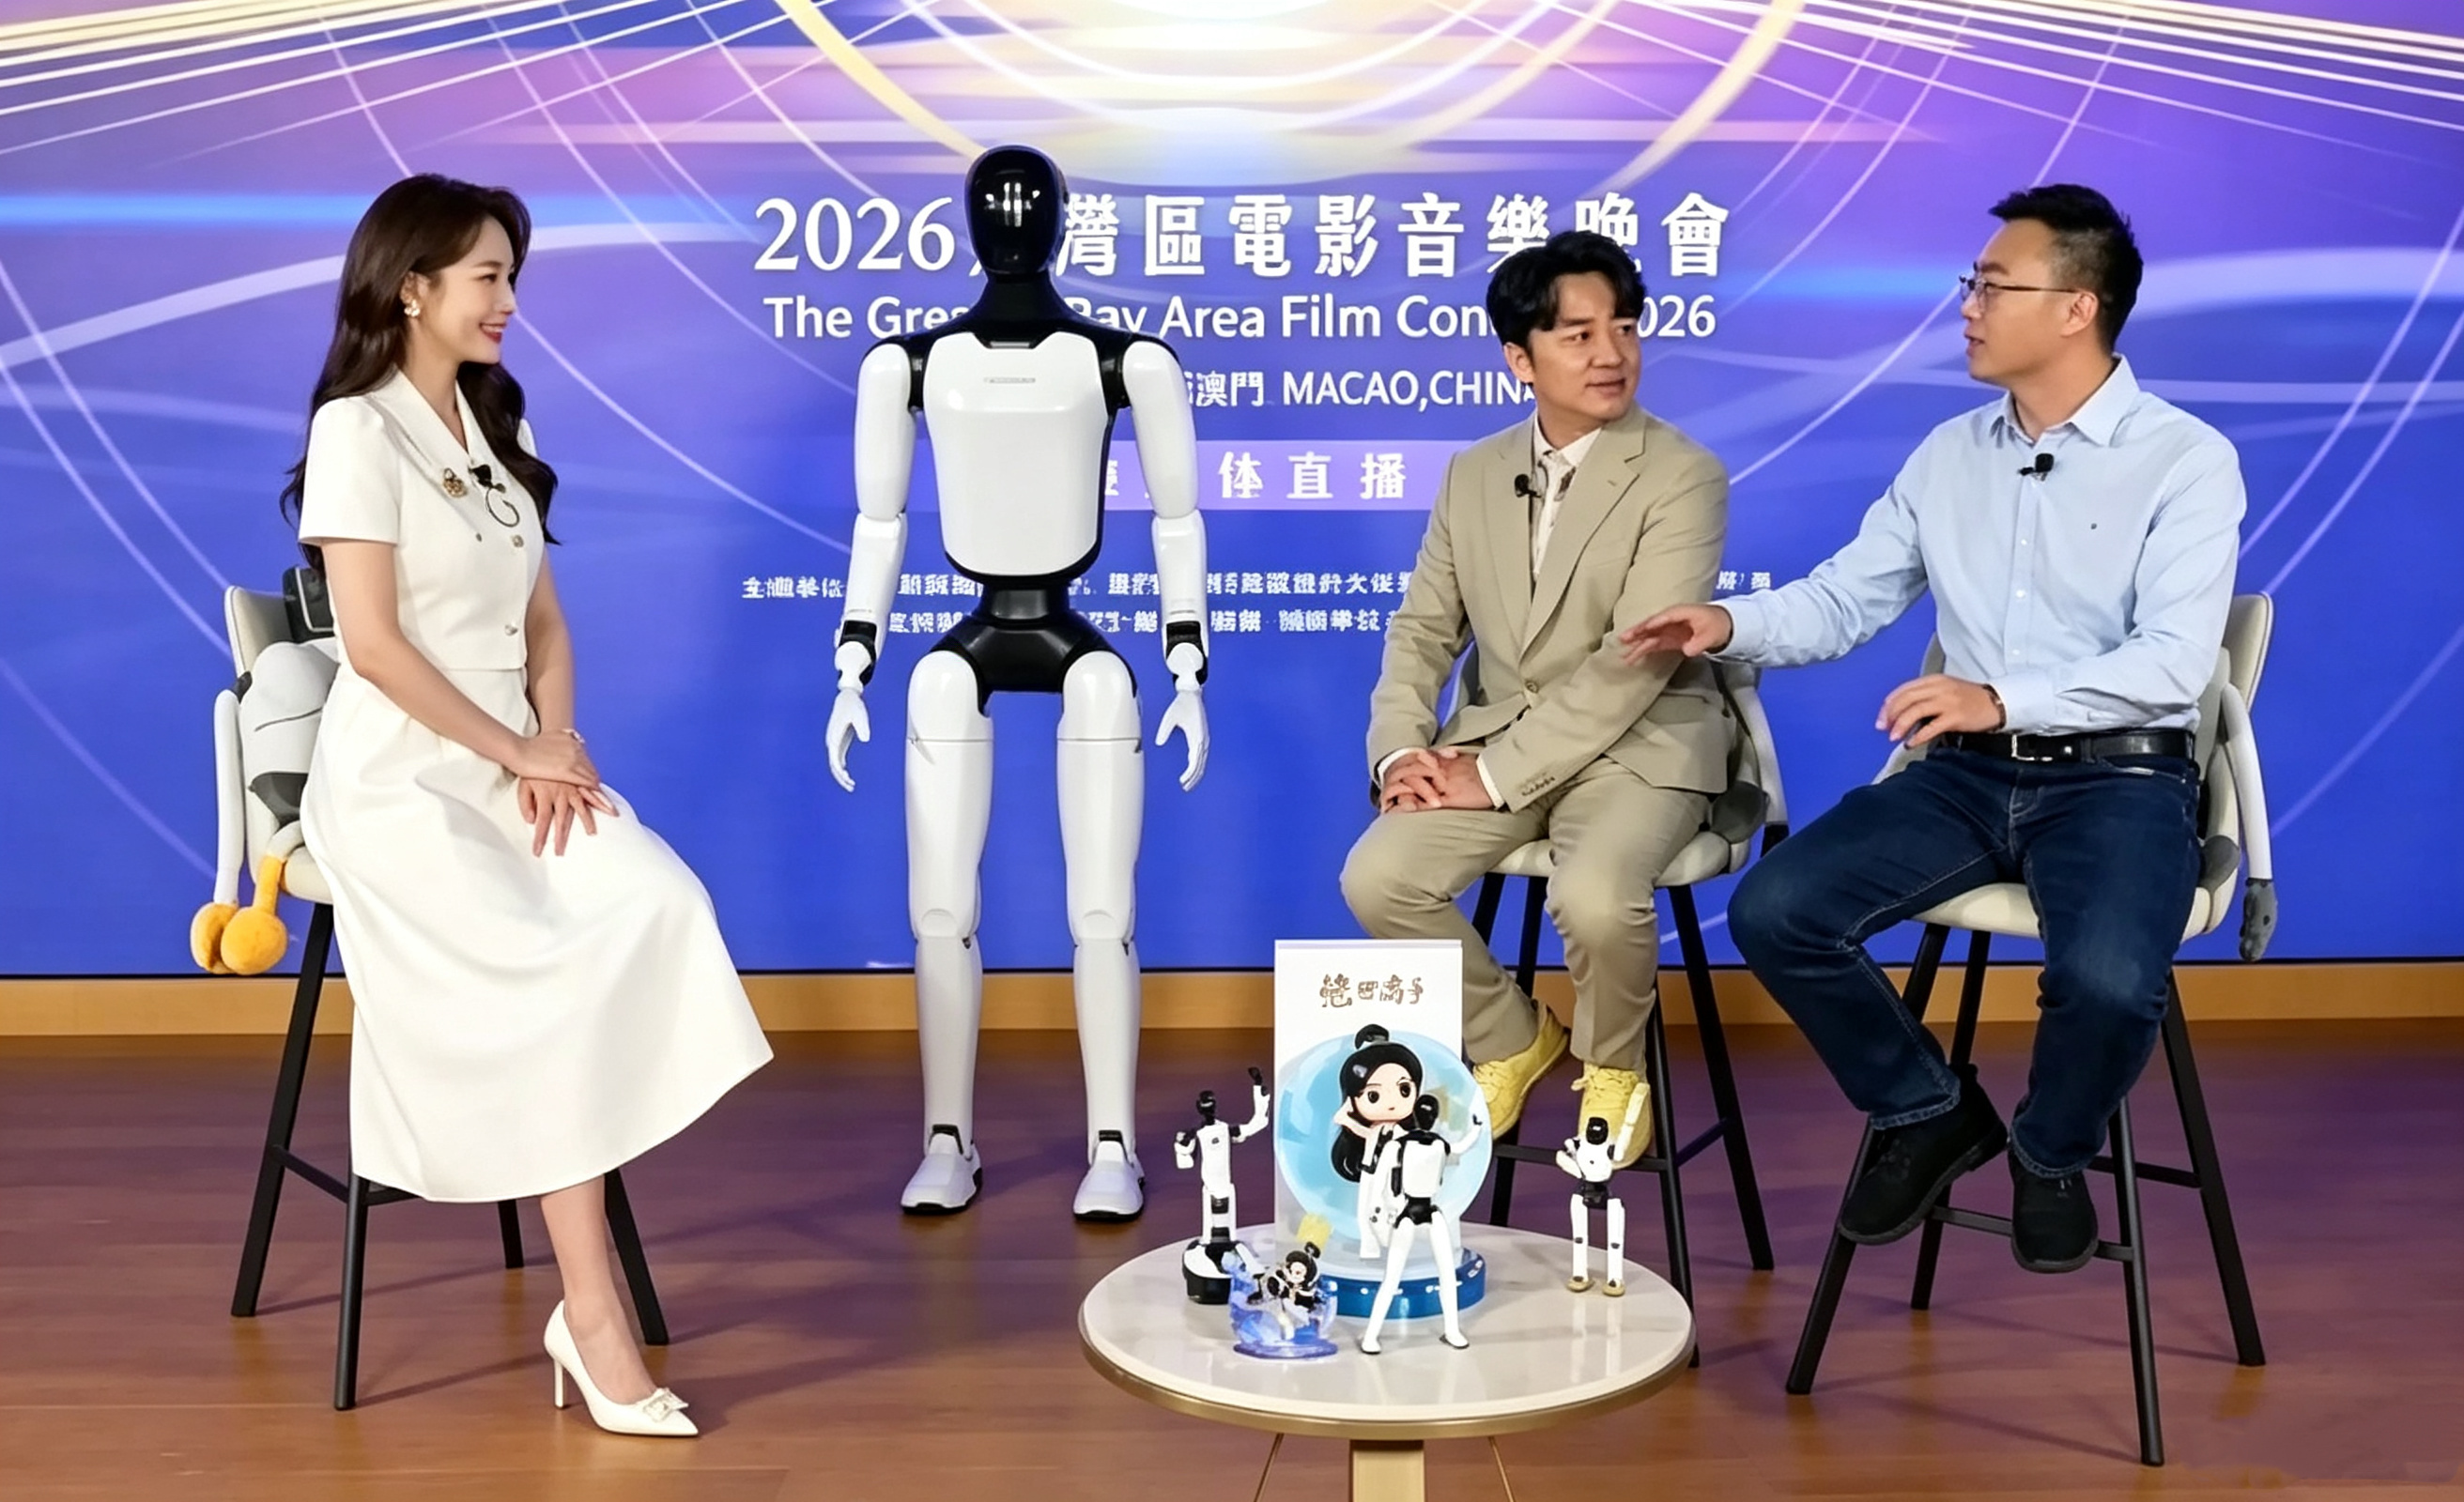
9月20日,澳门有一场晚会,晚会本身是电影音乐主题,但今年多了一个不太常规的安排。
智元的远征A3走进直播间,跟主持人和现场艺人一起互动,中间还有一段智元高层跟A3的专访,重点展示一个叫WITA-Omni的交互模型。
当机器人离开演示视频,走进一个真实、多人、不可控的现场,它到底能不能自己撑住?
这才是这次直播最大的看点。
1过去十几年,语音识别的准确率一路涨到接近人耳水平,语音合成已经能做到听不出机器味,大模型也让机器人可以流畅回答几乎任何问题。
但一直没被很好解决的,是另一件事,就是机器人放到多人环境里的时候,它不知道自己该扮演什么角色。
谁在说话,这句话是不是对我说的,我现在该不该开口,该回应谁,什么时机开口才不突兀。
现在很多机器人,要么慢半拍,要么没眼力见地插话,要么把环境里的声音也误当成指令回应。
但我们真实世界里的人,都是是怎么交流的?我们从来不是一句一句轮流讲。你在说话的时候,我已经在看你的表情、听你的语气、观察你有没有停顿的意思。
我可能在你还没说完的时候就已经开始准备回应,也可能听着听着发现你其实不是在跟我说,就默默把嘴边的话咽回去。
这种能力,我们从小到大自然习得。但对机器人来说,这是一座真正的大山。
2行业里做机器人交互,多数走的是流水线思路。先语音识别把声音变文字,再语言理解把文字变意图,再任务规划,再语音合成,再动作控制。
这套流程的问题也很明显,每一段都独立运行,整体给人的感觉容易是割裂的,也很难贴合真实对话的节奏。
而智元推出的 WITA-Omni,走的就是另一条路——端到端。它不是把看、听、说、动拆成四段流水线,而是把它们放进一个统一的模型里同时处理。听觉、视觉、语言、动作,在同一个决策空间里协同生成。
也就是说,它在听你说话的同时也在看你,看你的同时也在想怎么回应,想的同时嘴巴和身体已经开始配合。这就是所谓的原生端到端多模态交互。
前不久,WITA-Omni Preview前段时间在DailyOmni全模态理解评测里拿了第一,85.21分,八项指标里六项排第一。
这个评测专门考察开放环境下的音视频联合理解、时序推理和跨模态信息协同等能力。在乱糟糟的真实场景里,测评模型是否也能同时处理好几路信息,并判断先后顺序,知道哪件事和哪件事有关。
但榜单归榜单,我们还是要看一下真实场景下的表现。所以这次智元干脆把机器人拉到直播间里,让大家看看它到底行不行。
3直播间是一个很复杂的考场。
主持人可能突然把话头递过来,艺人之间也可能出现即时互动,还可能有现场设备的动静和各种动态变化。
这个都是没办法提前排练的,只能让模型现场判断。
所以如果你也在看20号那场直播,可以留意一下直播里主持人抛问题时,智元的远征A3是抢答还是等对方讲完,艺人之间在互相调侃时它是安静旁听还是尴尬插话,别人跟它挥手时它先动身体还是先出声。
这些不起眼的瞬间,恰恰能让我们看到一个交互模型在真实多人场景中的表现。
从会说话到懂互动,这一步跨过去,可能才是机器人真正从演示场景走进现实世界的重要一步。